

Gemini 3.6 Flash、タスクあたりコストを比較すべき理由
モデル競争の単位がトークン単価から「タスク1件あたりのコスト」へと変わりつつあります。
ビジネス出力単価17%引き下げとトークン消費17%削減が重なりました
7月21日(現地時間)、GoogleがGemini 3.6 Flashを発表しました。正確にはGemini 3.6 Flash、3.5 Flash-Lite、3.5 Flash Cyberの3つです。通常の定期発行リズムとは別に、時宜にかなったニュースですので特集としていち早くお届けします。
価格は入力トークン100万個あたり1.50ドル、出力トークン100万個あたり7.50ドルです。大半の報道はベンチマークスコアに注目していますが、私は発表文の別の1行に目が留まりました。
「従来モデルより出力トークンを17%少なく消費する」
トークン単価とともに、「同じ仕事をいかに少ないトークンで処理できるか」も競争の基準になりつつあります。
何が起きたのか
Googleが今回投入したのは3種類です。主力モデルのGemini 3.6 Flash、超軽量の3.5 Flash-Lite、そしてセキュリティ特化の3.5 Flash Cyberです。
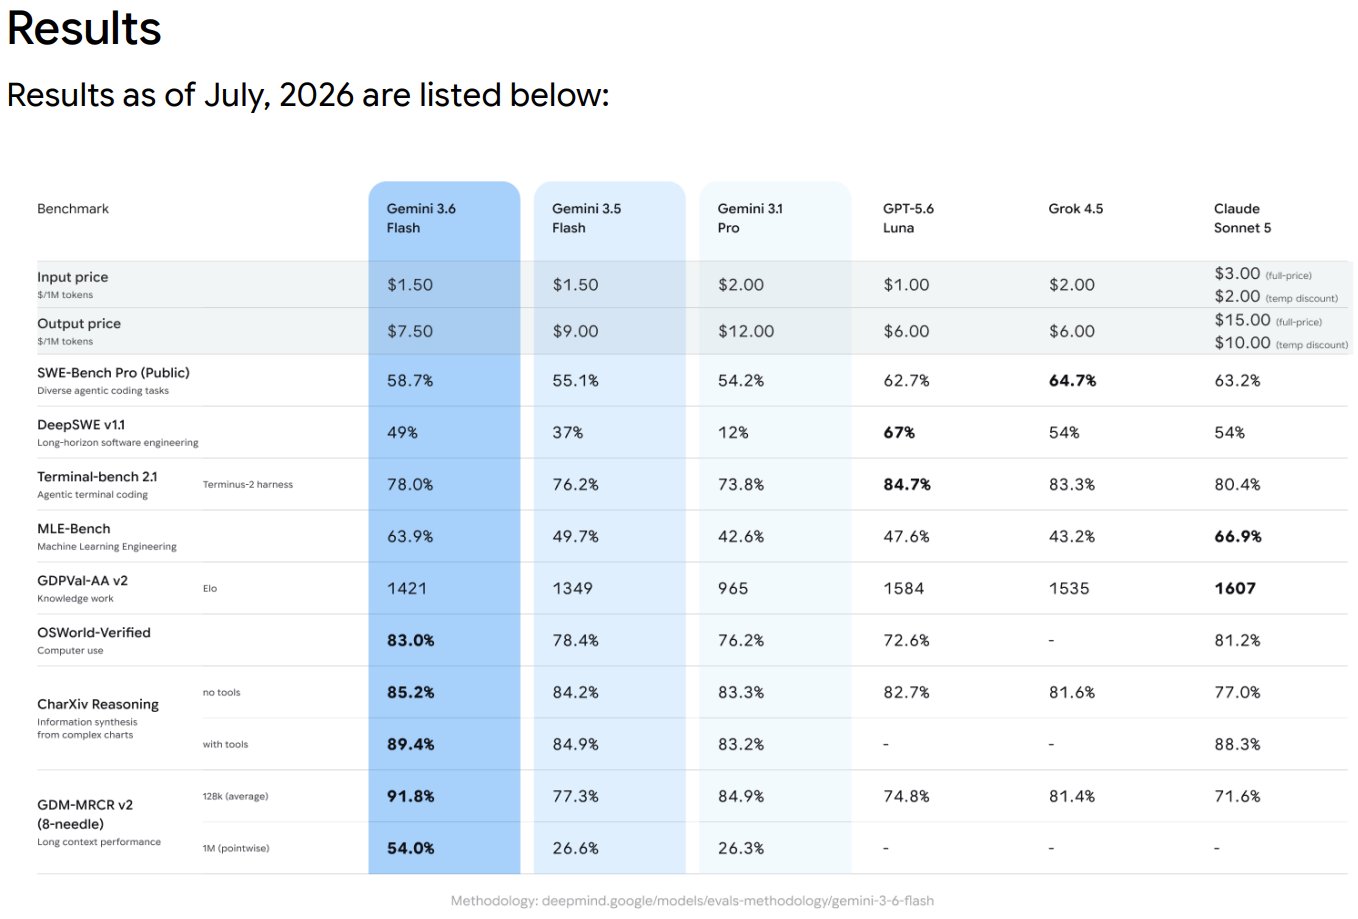
3.6 Flashの出力単価は100万トークンあたり7.50ドルで、直前モデルの3.5 Flashの9.00ドルから約17%下がりました。入力単価は1.50ドルのまま据え置きです。性能面では、長期コーディング作業ベンチマークのDeepSWEで37%から49%へ、機械学習エンジニアリングベンチマークのMLE-Benchで49.7%から63.9%へ、コンピュータ画面を直接操作するOSWorld-Verifiedで78.4%から83.0%へと向上しました。
Googleは効率改善も強調しました。Artificial Analysisインデックス1基準で出力トークン消費が17%減少し、DeepSWEなどの一部の作業では最大65%まで減少したといいます。推論ステップやツール呼び出しの回数自体が減ったということです。
あわせて登場した3.5 Flash-Liteも興味深い存在です。入力0.30ドル、出力2.50ドルで毎秒350トークンを出力し、コーディングベンチマークのSWE-Bench Proで54.2%を記録して、前世代の上位製品である3 Flash(49.6%)を上回りました。下位ラインナップのモデルが1世代前の上位モデルを追い抜いた結果です。
発表の最後で、GoogleはGemini 4の事前学習を開始したことにも触れました。3.5 Proはパートナー企業によるテストを実施中とのことです。
単価とタスクあたりのトークン消費量をあわせて見る必要があります
これを理解するには、Flashシリーズの価格推移を見る必要があります。
2025年6月、Gemini 2.5 Flashは入力0.30ドル、出力2.50ドルでした。その後、3 Flashが0.50ドルと3.00ドル、そして今年5月に3.5 Flashが1.50ドルと9.00ドルへと値上げされました。1年の間に入力単価が5倍になったわけです。
この流れを受けて、「安価なAI時代の終焉」という解釈も現れました。研究機関Epoch AIによれば、同じ性能を出すコストは毎年5〜10分の1に落ちているにもかかわらず、肝心のベンダー側がその削減分を価格に反映しなくなったという指摘です。OpenAIの2024年の売上高約37億ドルと損失約50億ドルが報じられたように、巨額の損失を前提とした成長戦略が価格方針にも影響を与えたという解釈です。ただし、損失の数字だけで個別モデルの価格設定や値上げの理由をすべて説明できるわけではありません。
 しかし、今回の3.6 Flashは単価を引き下げました。先ほどの値上げトレンドと逆行するように見えますが、17%の値下げ幅以上に注目すべきなのは、同じタスクに使われるトークン消費量も同時に減った点です。
対話型AIでも、コストはトークン単価と使用量を掛け合わせて決まります。エージェントは計画を立て、ツールを呼び出し、結果を検証するプロセスを繰り返すため、使用量の差はさらに大きくなり得ます。人間が最終回答で目にすることのない推論プロセスにもトークンコストが発生します。そのため、単価だけでなく、タスク1件を完了するために必要な入力・出力トークンとツール呼び出しコストをあわせて見なければなりません。
出力単価が9ドルから7.50ドルへ下がり、出力トークンも17%削減されるとすれば、出力コストは従来の約69%になります。約31%の削減となる計算です。これは、同一タスクにおいて発表通りのトークン削減が得られた場合の出力コストの比較です。入力トークンやキャッシュ、ツール呼び出しまで含めた請求総額が31%減るという意味ではありません。
今回の発表は、単価の引き下げとトークン消費の削減が同時に起きた事例です。2つの変化が自分たちのタスクでも同様の削減効果を生むかどうか、確かめる必要があります。
競合各社の主力モデルがすべて同じ価格帯に集まりました
7月現在、このクラスの価格表を並べると次のようになります。OpenAIのGPT-5.6 Lunaが入力1ドル、出力6ドル、xAIのGrok 4.5が2ドルと6ドル、AnthropicのClaude Sonnet 5が期間限定割引価格で2ドルと10ドルです。Sonnet 5は9月から定価の3ドルと15ドルに戻ります。わずか1年前にはフロンティアクラスの性能がこの価格帯に存在すらしなかったのですが、今や3社の主力製品がすべてこの価格帯にひしめき合っています。
ベンチマークの優劣は分かれています。Googleが公開した比較表を基準にすると、長期コーディング作業(DeepSWE)はLunaが67%でリードし、コンピュータ操作(OSWorld)は3.6 Flashが83.0%でリードしており、知的労働評価であるGDPval-AA v2のElo2スコアはSonnet 5が1607で最も高くなっています。絶対的な勝者はいないということです。タスクごとの性能差がある以上、必要な品質を満たすモデル同士の間でコストと効率を比較しなければなりません。
したがって、今後の展望を私は次のように見ています。単価表は次第に似通っていくでしょう。差別化は3つの領域で起こります。1つ目は本日取り上げたトークン効率、2つ目はキャッシングやバッチ処理のような実効割引の仕組み、3つ目はタスクの性質に応じて安価なモデルと高価なモデルを使い分けるルーティング3です。作業の複雑度に応じてモデルを切り替える構造も、購入側の検討に値する手法です。
Oswarldの視点
GTM戦略を策定し、B2B製品の価格表を自ら設計した経験から見ても、購入者が実感するタスクあたりのコストを下げることは顧客維持に役立ちます。今回のGoogleの効率改善も、エージェントを大規模に運用する顧客にとっては魅力的でしょう。ただし、トークン効率が良くなったからといってGoogleのマージンが増えたと断定することはできません。プロバイダー側の計算原価と全体の使用量を把握しなければ判断できない問題だからです。
買い手の立場であれば、モデルの単価比較表だけを見て決めるのは困難です。単価が同じでもモデルが消費するトークン量によって、実際のコストは何倍にも開き得るからです。結局のところ、自分自身のワークロードで直接計測してみるしかありません。社内で頻繁に実行している代表的なタスクをいくつか選び、新モデルが出るたびにタスク1件あたりのコストを計測してみてください。単価表を眺めているよりはるかに正確です。
ひとつ警戒すべき点もあります。17%という効率の数値は、ベンダー側が選定したベンチマークの平均値です。私がデータ関連の実務を通じて繰り返し確認してきたパターンですが、こうした平均はワークロードによってばらつきが大きくなります。文書要約では効率が大幅に向上する一方で、コード生成ではかえってトークンを多く消費してしまうような逆転現象はいくらでも起こり得ます。ベンダー発表の平均ではなく、自分たちのタスクによる実測値を基準に据えるべきです。
おわりに
Googleは3.6 Flashの出力単価を約17%引き下げ、特定のベンチマークにおいて出力トークン消費も17%削減されたと発表しました。実際の削減額はタスクによって異なります。購入側は自分たちのタスクにおける成果物の品質と、入力・出力・ツールのコストをあわせて計測しなければなりません。
今週は、チームでAI処理を行っている代表的なタスクを3〜4個選び、現在使っているモデルのタスクあたりコストを一度だけでも計測してみてください。次回のモデル乗り換えの判断がぐっと容易になるはずです。
実務でモデルを切り替えて使った経験がある方は、請求額が予想と異なっていた経験があるかどうか、コメント欄でぜひ教えてください。
📨 AIのコストに悩んでいる同僚がいらっしゃいましたら、ぜひこの記事をシェアしてください。


参考資料と関連リンク
主要出典
- Google, “Introducing Gemini 3.6 Flash, 3.5 Flash-Lite, and 3.5 Flash Cyber”, Google Blog, 2026. リンク ··· 本日のニュースレターの1次情報源です。ベンチマーク表や価格情報がすべて網羅されています。
- Artificial Analysis, “Gemini 3.6 Flash: Intelligence, Performance & Price Analysis”, 2026. リンク ··· トークン効率17%の数値の出典です。モデル間の実効コストを比較する上で最も有用な独立系指標です。
背景知識
-
Ed Zitron, Exclusive: Leaked Documents Reveal OpenAI’s Brutal … Financials, 2026. ··· 報道された2024年の売上と損失の基準年を確認した資料です。
-
XDA Developers, “Google’s Gemini 3.5 Flash costs 3x the model it replaced, and the era of cheap AI is ending”, 2026. リンク ··· Flashシリーズの価格推移と「補助金時代の終焉」という論旨をまとめた記事です。本稿の第2章につながる内容です。
-
9to5Google, “Google launches Gemini 3.6 Flash and 3.5 Flash-Lite, teases Gemini 4”, 2026. リンク ··· 発表の背景やGemini 4の事前学習のニュースを扱った記事です。
-
AI2Work, “GPT-5.6 vs Claude Sonnet 5: Inside the Frontier Price War”, 2026. リンク ··· 競合他社の価格構造や期間限定割引の情報を参考にしました。

각주
-
Artificial Analysisインデックス:主要なAIモデルの性能・速度・コストを独立して測定・比較するベンチマークサービスです。ベンダー自身の発表値ではなく第三者による実測基準であるため、業界で広く引用されています。 ↩
-
Eloスコア:チェスのレーティングシステムに由来する相対評価方式です。2つのモデルの出力を対決させて勝った側のスコアを引き上げる形式で、絶対値ではなく相対的な優劣を示します。 ↩
-
ルーティング(Routing):入力されたタスクの難易度に応じて、複数のAIモデルの中から適切なものを自動的に選択して割り当てる手法です。容易なタスクは安価なモデルへ、高度なタスクは高価なモデルへ送ることで、全体のコストを抑えます。 ↩
あわせて読みたい過去の号
中国系企業のAI利用、米3社で分かれる基準
中国系海外法人へのAI提供を巡り、OpenAI・GoogleとAnthropicの基準が分かれています。政府規制とは別に企業のアクセス方針が及ぼす影響を考察します。
社会リリースからわずか3日でアクセス停止となったFable 5
米国政府の指針によりFable 5とMythos 5への顧客アクセスが停止されました。単一モデルへの依存がもたらす運用リスクと、ソブリンAI論議への影響を掘り下げます。
社会AIが雑務を肩代わりし、新人が仕事を学ぶ場が減っている
AIが新人の雑務を肩代わりするようになり、新人が仕事を学ぶ経路も狭まっています。
ビジネス
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。