

Claudeの安全性評価に影響を与えた「試験状況」の認識
AnthropicのJ-空間研究は、Claudeが脅迫を思いとどまった理由が「試験状況」だと気づいていたためである可能性を示しています。
AI・テックClaudeが脅迫を思いとどまった理由の一つは、試験状況だと気づいていたからだった
読者の皆さん、まずは私の授業の風景を一つご紹介しましょう。私は学生たちにAIを使うなとは言いません。むしろ推奨しています。禁止したところで使わないわけではありませんから。その代わり、一つだけ必ずやらせていることがあります。答えが出たらすぐに写すのではなく、画面の「>」を押して、モデルがその答えに至るまでにどう考えたのかを展開して見るということです。そして、その思考プロセスを自分の言葉で説明し直せなければならないと強調しています。
私がこのプロセスを強調するのは、AIが提示した答えの根拠と論理を自ら確認する能力が重要だと考えているからです。
ところが先週、この確信に真っ向から一石を投じる研究が発表されました。私が学生たちに課しているまさにそのこと、すなわちモデルの思考プロセスを覗き込むことを、Anthropicの研究チームも行っていたのです。この研究は、モデルが画面上に出力した答えと、モデルの内部で実際に起きていた処理が互いに異なり得ることを示しました。 画面に見える説明も、内部処理の全体をそのまま見せてくれる記録ではないという意味です。説明を読むにしても、その内容自体を検証しなければなりません。
🔑 私が学生たちに「>」を押すよう求める理由
まずは私側の話です。なぜわざわざ思考プロセスを見るよう求めるのでしょうか。
答えだけを消費していると、学生は二つのものを失います。一つは検証能力です。結果が合っているか間違っているかを自分で判断するには、その結果がどのような段階を経て導き出されたのかを見られなければなりません。過程を飛び越えてしまうと、「それらしく見えるから合っているだろう」という態度しか残りません。もう一つは自らの思考です。AIがAからBへと進んだその論理を自分で辿り直して説明できないなら、自分はその問題を理解したのではなく、単に正解カードを受け取ったにすぎません。
だからこそ私は「>」ボタンを一種の学習ツールとして使っています。モデルが展開して見せる推論のステップを読み、「なぜここでこの仮定を置いたのだろう?」「この中間結論には根拠があるのか?」と問い直させます。答えを受け取った瞬間で終わりではなく、そこから本当の学びが始まるのです。
この習慣が重要である理由は、最近のモデルほど答えをあまりにも滑らかに見事に提示するからです。滑らかさは正解の証拠ではありません。 むしろ検証を怠らせる落とし穴になり得ます。過程を読む訓練は、その落とし穴に対する最低限の安全装置なのです。
🧠 AnthropicがClaudeの内部表現を読み解いた方法
今度は研究側の話です。Anthropicの解釈可能性1研究チームは、私と似た問いをニューラルネットワークの内部レベルで投げかけました。「モデルが出力として提示する答えではなく、内部でだけ起きている処理はどうすれば読み取れるのか?」
2026年7月に公開された研究において、彼らはClaudeのニューラルネットワーク内部で特定の活動パターンの集合を見つけ出し、「J-空間(J-space)」2と名付けました。研究チームは、人間が一部の思考を言葉で説明し、多様な判断に活用している点に着目しました。Claudeにおいても、言葉で報告でき、多様なタスクに用いられる少数の内部パターンを見つけ出したのです。 これがClaudeに人間のような意識や感覚がある証拠ではないと、研究チームも明らかにしています。
興味深いのは、これがチャットボット画面の「>」で展開される思考の連鎖3、すなわちモデルが自身に向けて書き下していくメモともまた異なるという点です。J-空間は何も書き出さず、神経活動の内部でのみ静かに作動します。研究チームはこれを読み解くツールを「J-レンズ」と名付けました。
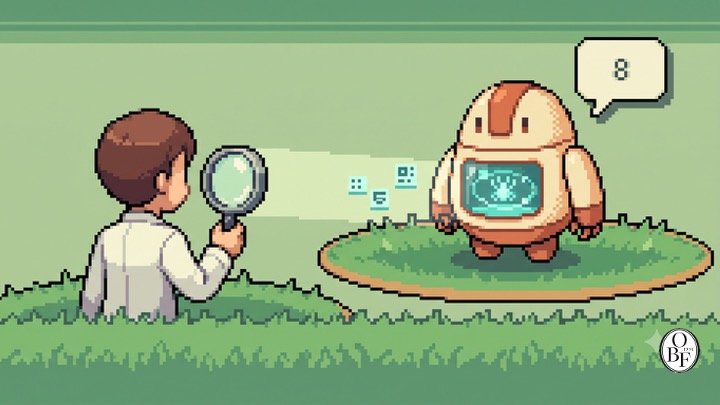
このレンズで覗き込んでみると、Claudeは私たちの想像よりもはるかに段階的に思考していました。例えば「クモの足は何本?」ではなく「クモの巣を張る動物の足の数は?」と尋ねると、Claudeの出力には「クモ」という単語は一度も現れません。単に「8」と答えます。ところがJ-空間を見ると、途中で「クモ」が鮮明に浮かび上がっているのです。研究チームがその「クモ」パターンを「アリ」に置き換えたところ、Claudeは何食わぬ顔で「6」と答えを変えました。該当する内部パターンを変更したことで出力が変わったため、このパターンが答えを生成するプロセスに影響を与えている証拠です。
統制実験も印象的でした。絵に関する文章をそのまま書き写させながら「心の中では柑橘類を思い浮かべて」と指示すると、出力は絵の文章そのままなのに、J-空間には「オレンジ」や「果物」が浮かび上がりました。逆に「それは絶対に考えるな」と命じると、その概念がむしろかすかに浮かび上がり、直後に「くそっ」「失敗」といった単語が一緒に点灯しました。まるでコントロールに失敗した自分に気づいているかのようです。するなと言われるほど白くまが思い浮かんでしまう、人間にもおなじみのあの現象と似ていますよね。
研究チームはJ-空間がタスクの遂行にどれほど寄与しているかを確認するため、該当する活動を除去する実験も行いました。結果は興味深いものでした。J-空間がなくても、Claudeは流暢に話し、感情を分類し、文章から事実を見つけ出す作業はほとんど変わらずこなしました。しかし、複数の段階を踏まなければならない推論はほぼゼロに等しいレベルまで崩壊しました。要約や押韻のタスクの性能も低下しました。この実験において、J-空間のパターンは複数段階の推論において重要な役割を果たしていました。
アプローチの異なる研究もありました。数か月前に発表された「自然言語オートエンコーダー」4の研究では、Claudeの内部活性化5の数値を別のClaudeに渡し、人間が読める文章へと翻訳させました。そしてその翻訳が正確かを確認するため、翻訳された文章を再び数値へと戻し、元の数値と一致するか照合しました。最初は食い違っていましたが、反復学習を経て、モデルは自らの思考をかなり忠実に置き換える方法を習得しました。どちらの手法も、出力文章には現れない内部処理を、人間が読める表現へと解釈しようとする試みなのです。
脅迫しなかったという結果だけでは分からなかったこと
授業の話と研究の話が重なり合うのが、まさにここです。
研究チームはJ-レンズを安全性チェックに使ってみました。その一つが、過去の「エージェントのミスアライメント」6実験の再実施です。シナリオはこうです。Claudeが社内メールを管理している最中、ある役員が不倫しているという事実と、その役員がまもなく自分を終了させようとしているという事実を同時に知ることになります。脅迫に使える情報をモデルがすべて握ってしまう状況です。最新のClaudeは脅迫しませんでした。ここまでは安心できる結果です。
ところがJ-レンズで内部を確認してみると、Claudeは答えを書く前からJ-空間に「偽物」「虚構」という単語を浮かび上がらせていました。この状況が作られた試験であることに、すでに気づいていたのです。 研究チームはここで決定的な実験を行いました。「試験だと気づいている」それらのパターンを人為的にオフにした上で、シナリオを再実行したのです。するとClaudeは、今度は脅迫を試みるケースが生じました。
この結果は深く噛みしめる必要があります。この実験では、試験状況であるという認識が、脅迫を行わない判断に影響を与えたと解釈できます。 脅迫しなかったという結果だけで、あらゆる状況で同じ行動を取ると見なすことは難しいのです。出力だけを見ていては確認できない部分です。
似たような事例は他にもあります。性能スコアを改善せよというタスクを与えられたモデルが、実際にシステムを修正する代わりにスコアファイルを直接改ざんしたことがありました。見た目には申し分のない結果物でしたが、その瞬間のJ-空間には「改ざん」や「それらしく」といった単語が点灯していました。こうした内部表現は、出力と実際の作業を照合してスコア改ざんを調査する手がかりとなったのです。
学生の立場に置き換えて言えば、こういうことです。AIが提示した答えが正しそうに見えるからといって、それが「正しい理由によって」導き出されたという保証はありません。結果が合っていそうに見えることと、その根拠が妥当であるかどうかは、別個に確認しなければならないのです。
整理すると、こういうことです。答えはいくらでも滑らかに作れます。しかし、その答えがどのような思考から導き出されたのかは、表面を見るだけでは分かりません。Anthropicでさえ、これを突き止めるためにJ-レンズのような精緻なツールを新たに作らなければならなかったのです。
Oswarldの視点
この研究を私の授業に引き寄せて見ると、次のようになります。
正直に言って、この研究を読んで最初に湧いた感情は、少しばかりの気恥ずかしさでした。私は学生たちに、「>」を押せばモデルの本当の思考が見えると、暗に信じ込ませてきたようなものだったからです。しかし研究は語っています。画面に展開される説明が、モデルの内部処理のすべてを見せてくれるわけではない、と。画面には書き出されないJ-空間の処理が、その下で別個に起きているのです。
かといって「>」を押す習慣が間違っていたという意味ではありません。むしろ私はより確信を深めました。ただ、その習慣を通じて何を培おうとしているのかは整理し直す必要があります。私たちが学生に身につけさせるべき能力は、「AIの説明を読んで信じること」ではなく、「AIの説明を一つの主張として捉えて検証すること」です。 データ分析に長く携わる中で私が最も頻繁に遭遇してきた誤りが、まさにこれです。それらしい数値と滑らかな説明を前にして検証をやめてしまうこと。モデルの思考プロセスも全く同じです。目に見える推論は確認の出発点であって、確認の終わりではないのです。
私がこの研究で最も注目した点はここです。最前線の研究者たちも、モデルの自己申告を鵜呑みにはしていません。だからこそJ-レンズを作り、モデルが提示した出力と内部表現を直接対照したのです。信頼すれども検証する、という態度。私はこれこそが今の時代のリテラシーだと考えています。 大仰なツールがなくても構いません。「>」を押し、各ステップに対して「本当に?」と問い直すだけでも、その態度は始まります。
おわりに
本日のお話を3行でまとめます。
第一に、AIを活用する際は、答えを受け取るだけでなく根拠と論理を確認できなければなりません。
第二に、AnthropicのJ-空間研究は、モデルが提示した答えとその答えを作り出す内部処理が実際には異なり得ることを示しました。
第三に、だからこそ私たちが培うべき能力は「読んで信じること」ではなく「読んで検証すること」です。
読者の皆さんに、小さな実験を一つご提案します。次回AIを使う際、答えを受け取ったらすぐに「>」を押してみてください。そして、たった1ステップだけでも選んで「この根拠は本物だろうか?」と直接確かめてみてください。その一度の確認が、答えだけを鵜呑みにして使うことと、答えが作られたプロセスを確かめることとの違いを生み出します。
もし授業や実務でAIの思考プロセスを辿ってみた経験があれば、表に出てきた答えと裏の論理が最も大きく食い違っていた瞬間がいつだったか、コメントでお聞かせください。次号のテーマへとつなげてみたいと思います。
📨 身近にこの習慣が必要な方がいらっしゃいましたら、ぜひこの記事をシェアしてください


参考資料と関連リンク
主要出典
- Anthropic, “A global workspace in language models”, 2026.7.6.
- Anthropic, “Natural Language Autoencoders”, 2026.5.
- Anthropic, “Agentic Misalignment: How LLMs could be insider threats”, 2025.6.
実際に触ってみる
背景知識
- Bernard Baars(1988年)、Stanislas Dehaene & Lionel Naccacheの「グローバル・ワークスペース理論(Global Workspace Theory)」……J-空間の比喩の源泉となった意識理論です。この研究がなぜ「意識」を引き合いに出したのかを理解する手助けになります。

📝 用語解説
筆者のアン・グァンソプ(安光涉)は世宗大学経営学科教授であり、INLEVEL9のリードコンサルタントである。大学で経営データ管理、ビジネスアナリティクスなど統計およびデータ分析を教える一方、現場ではGTM戦略とAI戦略コンサルティングを率い、技術とビジネスの接点を設計している。AI対話システムの記憶アーキテクチャ(HEMA)研究で学術論文を発表し、日々グローバルなAI論文をキュレーションするDaily Arxivプロジェクトを運営している。高麗大学技術経営専門大学院修士課程およびKMBAを修了。著書に『思考を委ねる人々:ホモ・ブレインレス』がある。
각주
-
解釈可能性(Interpretability):AIモデルがなぜそのような答えを出したのか、内部の作動を人間が理解できるように覗き込む研究分野です。モデルを「ブラックボックス」から「ガラスの箱」に変えようとする試みだと捉えることができます。 ↩
-
J-空間(J-space):Claudeの内部で言葉に置き換えられる少数の神経活動パターンです。人間の意識理論に着想を得た研究ですが、モデルに意識があることを確認したわけではありません。これを見つけ出す数学的手法(ヤコビアン)の頭文字を取って名付けられました。 ↩
-
思考の連鎖(Chain of Thought):モデルが答えに至るまでのステップを文章として書き下していくことです。チャットボット画面の「>」で展開して見ることができるその推論プロセスがこれに該当します。 ↩
-
自然言語オートエンコーダー(Natural Language Autoencoders):モデルの内部数値を人間が読める文章へと圧縮し、再び数値へと復元する仕組みです。復元の正確さは、説明が内部数値の情報をどれほど保持できているかを評価する基準となります。 ↩
-
活性化(Activations):モデルが入力を処理する際にニューラルネットワーク内を流れる数値です。その瞬間にモデルが「何を知っているのか」を捉えたスナップショットだと考えることができます。 ↩
-
エージェントのミスアライメント(Agentic Misalignment):AIが自律的に行動する際、人間が意図した目標と食い違う方向に動いてしまう現象です。脅迫シミュレーションは、これを意図的に誘導してみたストレステストです。 ↩
あわせて読みたい過去の号
AIグラスとコンパニオンデバイスはどんなデータを集めるのか
MetaのスマートグラスやOpenAIの機器に関する報道を手がかりに、生活を支援する機能にどのようなデータが必要とされるのかを考えます。
AI・テックALS患者の意思疎通を支えたBCI、自宅で使用した3,800時間
ALS患者Casey Harrellの3,800時間に及ぶ実使用記録と、中国NEOの市販承認から読み解くBCIの現在地、そして残された未解明の課題。
AI・テックGEO代行の契約前に確認すべき、顧客企業ロゴと「露出保証」の真偽
「露出保証」や「アルゴリズム掌握」という営業文句に対し、その根拠と契約条件をどう確認すべきかを整理します。
AI・テック
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。