

TurboQuantのメモリ圧縮と半導体需要
GoogleのTurboQuantが縮小するKVキャッシュは、HBMにも保存されます。論文が示す圧縮性能と、実際のメモリ需要に影響する条件を確認しました。
AI・テックTurboQuant発表後に下落したメモリ・ストレージ関連株
2026年3月25日、米国株式市場でメモリとストレージ関連株が揃って下落しました。Investing.comによる当日の場中報道によると、サンディスクは5.7%、ウェスタンデジタルは4.7%、シーゲイトは4%、マイクロンは3%下落しました。ナスダック100が上昇するなかで起きた動きでした。この記事は、Googleの圧縮アルゴリズムTurboQuantの発表を下落の背景として挙げています。
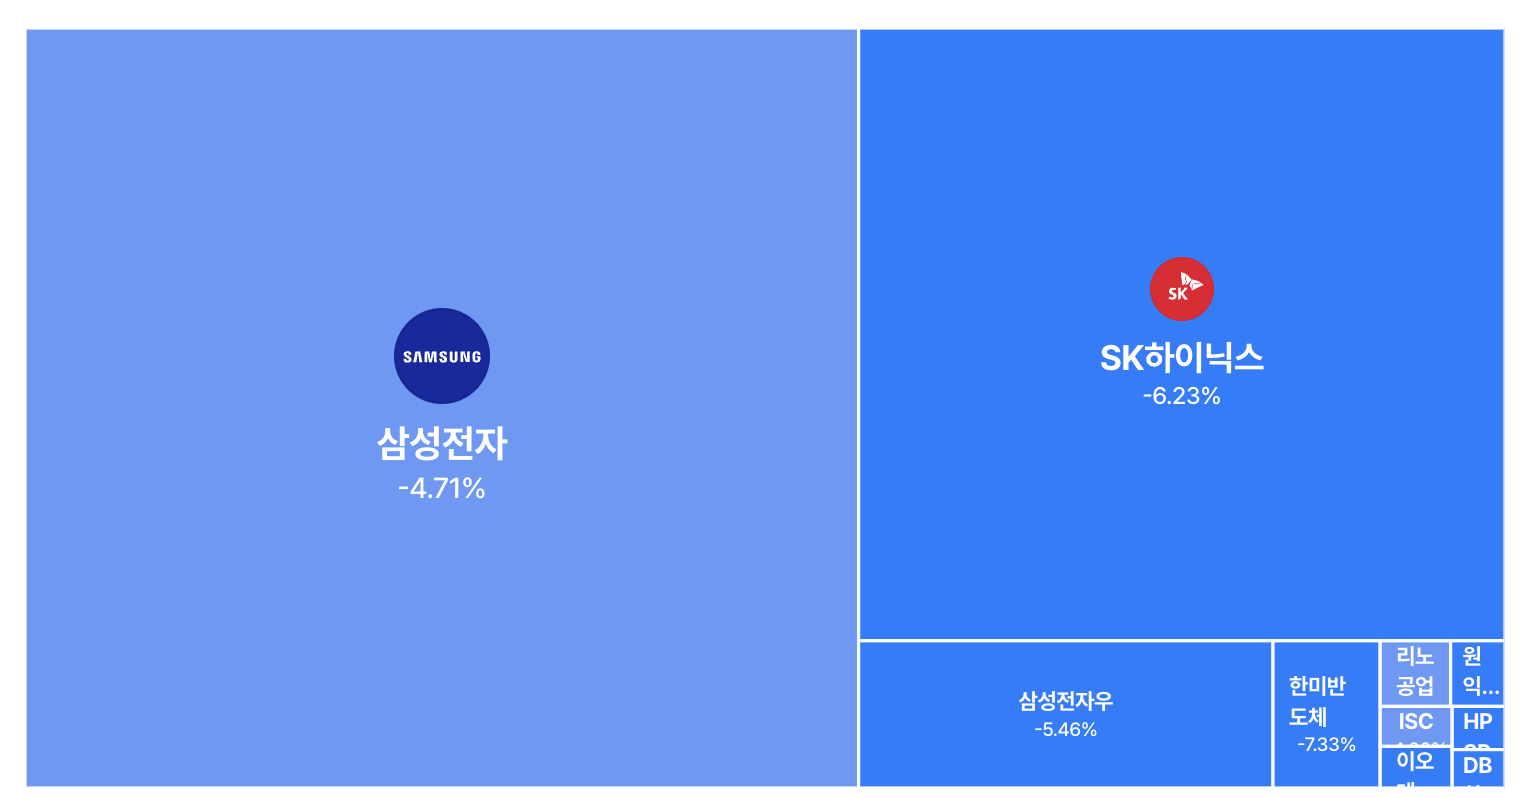
私も原稿を書いていた日の18時頃、韓国国内の株式画面を確認しました。サムスン電子、SKハイニックス、ハンミ半導体など半導体関連銘柄が下落していました。ただ、国内外の株価の動きをこの技術ひとつの影響として説明するのは難しいです。
TurboQuantは、AIが以前の計算を再利用するために保存するKVキャッシュを圧縮します。このキャッシュはGPUのHBM1にも保存されるため、圧縮はHBMの使用量に影響を与える可能性があります。ただし、1件のリクエストを処理するのに必要なメモリが減ることと、市場全体のメモリ購入量が減ることは、別に見る必要があります。
TurboQuantが実際に行っていること
AIが次の文章を生成する際には、それ以前に入力された内容に関する計算結果を再利用します。このとき保存しておくキーとバリューのデータをKVキャッシュ2と呼びます。同じモデルと保存形式であれば、すべてのトークンを保持するキャッシュはおおむねトークン数に比例して大きくなります。長い文書を扱ったり、複数のリクエストを同時に処理したりするほど、メモリの負担も増えます。
TurboQuantは、これらの数値をより少ないビット数で保存する量子化3技術です。元の論文では、まずランダム回転と呼ばれる数学的変換を適用し、各数値の分布を予測しやすくします。そのうえで、あらかじめ計算しておいた基準に従って近い代表値に置き換えて保存します。入力データごとに圧縮基準を新たに学習しなくてよいという利点があります。
数値を簡略化して保存すると誤差が生じます。特に、AIがデータ間の関係を計算する内積演算では、結果が一方向に偏る可能性があります。論文はこれを補うため、残差誤差を扱うQJLという段階を提示しています。各成分を1ビットの符号で表す方法を用いて、内積の推定値に生じる偏りを取り除くよう設計されています。個々の計算の誤差がすべて消えるという意味ではありません。
論文のLongBench実験では、Llama-3.1-8B-Instructの平均スコアは、非圧縮と3.5ビット設定のいずれも50.06でした。2.5ビットでは49.44でした。3.5ビット設定では4.5倍以上の圧縮を報告しており、長文に隠された情報を探す実験でも非圧縮モデルと同等の性能を示しました。実験対象のモデルとタスクで得られた結果です。
圧縮基準をデータごとに学習する必要がないという特性は、ベクトル検索にも有用です。論文は、検索用インデックスの準備時間を短縮する結果を提示しています。ただし、検索インデックスの準備時間とチャットボットが回答を生成する時間は、それぞれ別の測定値です。
Googleのブログは、KVキャッシュを最小6倍縮小した実験と、最大8倍の演算速度向上を紹介しています。ここでいう8倍は、H100でアテンションロジットを計算する特定の段階における結果です。回答生成全体が8倍速くなったという意味に読んではいけません。論文の4.5倍以上と、ブログの6倍についても、モデルやビット数など実験条件を併せて確認する必要があります。私は、技術発表の大きな数字よりも、何を測定したのかを先に見るようにしています。
圧縮がHBM需要に与える影響
メモリの使用量が少なくても同じ処理ができるのであれば、AI事業者が想定より少ない設備で運用できる可能性が生まれます。メモリ企業の将来の売上に期待していた投資家がこの発表に注目した理由が理解できる部分です。
KVキャッシュは保存されるデータであり、HBMはそのデータを収めるメモリ半導体です。両者は実際のシステムでつながっています。KVキャッシュは、使用状況に応じてHBMにとどまることもあれば、CPU側のDRAMやSSDに移されることもあります。キャッシュの圧縮は、保存容量だけでなく、このデータを移動させる際に必要な転送量にも影響を与える可能性があります。
HBMにはKVキャッシュ以外にも、モデルの重みや演算に必要なデータが収められます。訓練にも使われます。そのため、キャッシュ容量が6分の1になったからといって、GPU全体のメモリやHBM市場が同じ比率で縮小するわけではありません。
市場全体の需要を見るには、節約効果と利用量の増加を併せて検討する必要があります。同じGPUでより多くのリクエストを処理し、追加購入を先延ばしにする可能性もあれば、コストが下がりAIの利用が増える可能性もあります。どちらの効果がより大きいかは、実際の導入範囲とサービス需要次第です。
NvidiaもKVキャッシュ圧縮を研究しています
ICLR 2026に採択されたNvidia研究チームによる**KVTC(KV Cache Transform Coding)**も、KVキャッシュの圧縮を扱っています。画像圧縮に用いられる変換符号化方式を応用し、再利用するキャッシュをGPUの内外に小さく保管する研究です。論文は、精度を維持しながら最大20倍、一部の用途では40倍以上の圧縮が可能だと報告しています。高い圧縮率では、精度とのトレードオフも必要になります。
KVTCは、事前の較正データを利用して変換基準を定め、重要度に応じてビット数を配分したうえで追加の圧縮を適用します。保管したキャッシュを再利用する際の復元コストまで併せて見る必要があります。TurboQuantとKVTCの圧縮率の数字だけを並べて性能の順位をつけるのは難しいです。
両研究は、推論コストを下げる手法が今も開発され続けていることを示しています。以前のニュースレターで扱ったジェヴォンズのパラドックス4のように、効率の改善がより多くの利用につながる可能性もあります。ただし、この効果が必ず節約量を上回ると決まっているわけではありません。
Oswarldの視点
私は今回の市場の反応を見て、AIインフラ投資の規模だけでなく、投資した設備でどれだけ稼げるかがより重要になってきていると感じました。性能が向上したというニュースが、設備を供給する企業とサービスを運営する企業にとって同じ意味を持つとは限らないからです。
業績自体は好調です。Nvidiaの2026会計年度の売上高は2,159億ドルで、前年比65%増でした。マイクロンが3月18日に発表した2026会計年度第2四半期の売上高は238億6,000万ドルで、売上総利益率はGAAP基準で74.4%、調整後基準で74.9%でした。両社の開示資料で確認できる数値です。
良い業績が出たとしても、今後の投資収益まで確定するわけではありません。AI企業が拡大させる設備投資に対して、サービス売上がどれだけ伸びるのか、価格が下がっても利益が残るのかを見る必要があります。AI投資の過熱をめぐる論争も、この問題とつながっていると考えています。
GTM戦略を見る私の視点では、設備を増やすことと、すでに購入した設備を効率的に使うことの両方を見る必要があります。TurboQuantやKVTCは後者の事例です。Google TPUやAmazon Trainiumのような自社チップ開発も、コストと性能を自ら管理しようとする試みと見ることができます。こうした変化が、AIインフラ投資の評価基準を変えつつあると考えています。
私は、効率化の研究が出てきたという理由だけで、AI産業の成長が終わったとは見ていません。コストを下げられてこそ、より多くのサービスでAIを使えるようになるはずです。ただし、効率改善の利益が誰に還元されるかは企業ごとに異なるでしょう。サービス運営コストが減ることと、半導体供給企業の売上が増えることは、同じ結果ではないからです。
発表前の需要見通しも参考になります。SKハイニックスの2026年1月付の市場見通し資料が引用したBofAの推定によれば、今年のHBM市場は546億ドル、前年比58%成長とされていました。当時、高い成長が見込まれていたことを示す資料ですが、今後起こりうるすべての技術変化まで織り込んだ確定売上ではありません。
効率化が設備の発注に反映される時期も、あらかじめ決めることはできません。圧縮技術を実際のサービスに適用する速度、節約した容量をより長い入力や同時リクエストに使う程度、すでに契約済みの設備の導入スケジュールが同時に作用するからです。私は今後の性能評価と、事業者の実際の発注の変化を確認していきたいと思います。
おわりに
TurboQuantの論文は2025年4月28日に初めて公開されました。今回のGoogleブログや市場報道より約11か月前の時点です。私は、研究が公開された時期と投資家が関心を示す時期がこれほど異なることがあるという点が興味深く感じました。
TurboQuantは、KVキャッシュを小さくして推論に必要なメモリを節約する技術です。その効果はHBMの使用量ともつながっています。今後見ていくべきは、実験室での圧縮率が実際のサービスでどれだけ再現されるのか、そして減ったコストの分だけ利用量が増えるのかという点です。この2つを確認してこそ、メモリ市場に及ぼす影響を判断できます。
論文の発表だけで株価下落の原因や産業全体の方向性を確定させるのではなく、こうした後続の変化を見ながら私自身の判断も更新していきたいと思います。
⚠️ このニュースレターは特定銘柄への投資勧誘ではありません。投資判断は必ずご自身の分析と専門家への相談を経たうえで行ってください。


参考資料と関連リンク
- Zandieh, A., Daliri, M., Hadian, M., & Mirrokni, V.、TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate、2025.04.28。圧縮方式やLongBenchなどの実験結果を確認できます。
- Google Research、TurboQuant: Redefining AI efficiency with extreme compression、2026.03。圧縮率と特定演算の速度向上を紹介しています。
- Staniszewski, K., & Łańcucki, A.、KV Cache Transform Coding for Compact Storage in LLM Inference、ICLR 2026。再利用するキャッシュを圧縮して保管する研究です。
- Louis Juricic、MU, WDC, SNDK fall: Why Google’s TurboQuant is rattling memory stocks、Investing.com、2026.03.25。本文中の米国株の下落率は、この記事の場中数値です。
- SKハイニックス、2026 Market Outlook、2026.01.05。BofAなど機関によるメモリ市場見通しを紹介しています。
- NVIDIA、2026会計年度決算発表、2026.02.25。
- Micron、2026会計年度第2四半期決算発表、2026.03.18。
筆者アン・グァンソプ(安光涉)は世宗大学校経営学科教授であり、INLEVEL9のリードコンサルタントである。大学では経営データ管理、ビジネスアナリティクスなど統計・データ分析を教える一方、現場ではGTM戦略とAI戦略コンサルティングを率い、技術とビジネスの接点を設計している。AI対話システムの記憶アーキテクチャ(HEMA)研究で学術論文を発表しており、毎日グローバルなAI論文をキュレーションするDaily Arxivプロジェクトを運営している。高麗大学校技術経営専門大学院修士課程とKMBAを修了した。著書に『思考を任せる人々:ホモ・ブレインレス』がある。

각주
-
HBM(High Bandwidth Memory):複数のDRAMチップを垂直に積層し、広いデータ接続を提供する高帯域幅メモリです。AIアクセラレーターの近くに配置され、モデルの重みやKVキャッシュなどを保存します。 ↩
-
KVキャッシュ(Key-Value Cache):言語モデルが以前のトークンから計算したキー・バリューのデータを保存し、再利用する仕組みです。会話内容を人間のように記憶する別個の装置という意味ではありません。 ↩
-
量子化(Quantization):数値をより少ないビット数で表現し、保存量と演算負荷を減らす手法です。どの程度減らすかによって誤差と性能が変わります。 ↩
-
ジェヴォンズのパラドックス(Jevons Paradox):資源を使う効率が高まったにもかかわらず利用がさらに増え、総消費量がかえって増加する現象を指します。すべての効率改善で必ず現れる結果ではありません。 ↩
あわせて読みたい過去の号
Sora終了発表とChatGPTショッピング刷新から見るOpenAIの戦略
Sora終了計画、組織改編、ショッピング機能の変更と企業顧客獲得の動きを併せて見ていきます。どこに資源を使い、どの顧客に販売しようとしているのかに注目しました。
AI・テックNvidia GTC 2026:売上予測と推論コストの読み方
Nvidiaが示した1兆ドルの事業予測とGroq技術統合を見つつ、AIインフラの性能とコストをどの条件で比較すべきか整理します。
AI・テックAIモデル70種類以上が、オープンエンドな質問に似た答えを出しました
異なるAIに聞いても似たようなアイデアが出てくることがあります。Artificial Hivemind研究の実験条件と、文章執筆への示唆を見ていきます。
AI・テック
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。