

Nvidia GTC 2026:売上予測と推論コストの読み方
Nvidiaが示した1兆ドルの事業予測とGroq技術統合を見つつ、AIインフラの性能とコストをどの条件で比較すべきか整理します。
AI・テックGTC 2026で私が注目したこと
Nvidia GTC 2026が3月16日から19日まで米国サンノゼで開催されました。ジェンスン・フアンCEOはSAPセンターで行われた基調講演で、ベラ・ルビン(Vera Rubin)プラットフォームとGroq技術を活用した推論装置を紹介しました。
1兆ドルという予測と新製品の性能が大きな注目を集めました。私はそれと合わせて、NvidiaがGPU、ネットワーク、ストレージとソフトウェアを一体で提案する方式に着目しました。個々のチップをどれだけうまく作るかに加えて、顧客のデータセンターをどう構成し運用するかまで販売する戦略として読み取れました。
ジェンスン・フアンはAIデータセンターを、トークンを生産する工場に例えました。トークンとは、AIが文章を処理・生成する際に使う単位です。この比喩でNvidiaが強調しているのは、定められた電力と設備でどれだけ多くのリクエストを処理でき、その結果として顧客がどれだけ稼げるかという点です。以下では事業予測、Groq統合、コスト計算の順に見ていきます。
1兆ドルとはどのような予測か
ジェンスン・フアンは、ブラックウェルとベラ・ルビン関連事業で2027年までに少なくとも1兆ドル規模を見込んでいると明らかにしました。これはすでに計上された売上や確定受注残高として開示された数値とは性質が異なります。 以前に示した5,000億ドルという予測は2026年までを対象としていたため、この2つの数字の差を同じ期間の売上が2倍になったという意味に読んではいけません。
DCDが伝えたコレット・クレスCFOの説明によれば、この予測にはブラックウェル・ルビン製品と関連ネットワーキングが含まれます。新しい独立型CPUやGroq LPUなどは別枠です。追加製品が売上機会を広げる可能性はありますが、販売規模と導入率はそれぞれ確認する必要があります。
顧客構成も重要です。ジェンスン・フアンは、事業の約60%が上位5社のハイパースケーラー、すなわち大規模クラウド・データセンター事業者から生まれていると説明しました。残りには一般企業や産業顧客、各国のAIインフラ事業である主権AI1などが含まれます。
ロボット・自動運転・製造分野でAI活用が増えれば、顧客層を広げられます。今回のGTCでも、BYD・Geely・いすゞ・日産によるDRIVE Hyperionの採用が発表されました。ただし提携発表がそのまま大規模な売上につながるわけではありません。実際の車両への適用とサービス運用がどれだけ進むかを見る必要があります。
すでに発表されている実績はこうです。2026年1月に終了したFY2026の年間売上は2,159億ドルで、前年より65%増加しました。そのうちデータセンター売上は1,937億ドルです。同社は次四半期にあたるFY2027第1四半期の売上を780億ドル、誤差範囲±2%と予測しました。この予測には中国のデータセンターコンピューティング売上は含まれていません。
GPUとGroq装置が推論作業を分担する
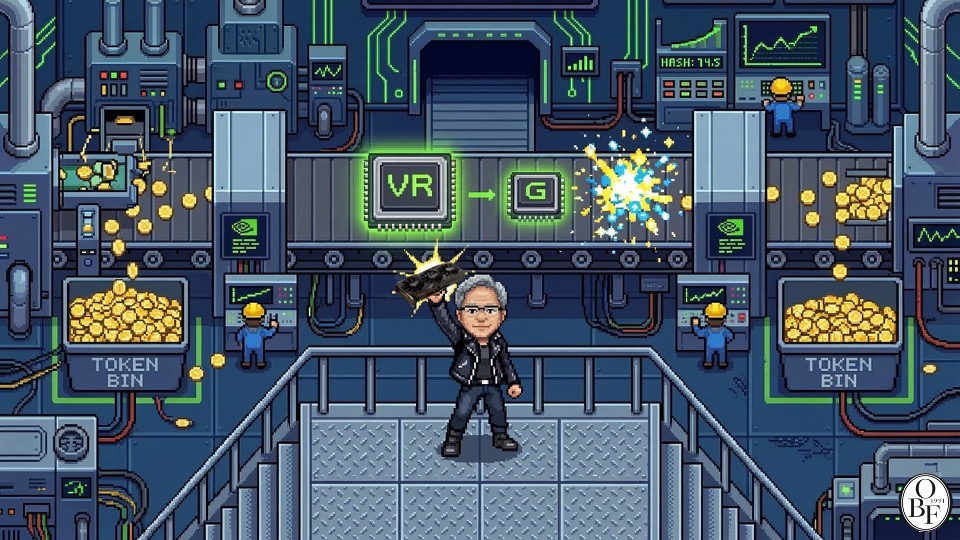
Groq技術がNvidia製品に組み込まれた点も目を引きました。2025年12月24日にGroqが公式発表した取引は、非独占的な技術使用契約と一部人員のNvidia入社です。メディアは取引規模を約200億ドルと報じましたが、Groqは独立企業とGroqCloudサービスを維持すると明らかにしました。
AIが答えを生成する過程は、入力内容を処理するプリフィルと、出力トークンを続けて作るデコードに分けて説明できます。この2つの段階は必要な計算とメモリの使い方が異なります。Nvidiaは各作業に適した装置を連結して効率を高めようとしています。
ルビンGPUは大きなメモリを活用して多くのリクエストを処理し、GroqのLPU2はチップ内の高速なSRAM3を活用してトークン生成の遅延を減らすことに焦点を合わせています。どちらの装置が無条件に優れているというより、任せる作業の性格が異なるということです。
ルビンGPUがプリフィルを処理し、デコードではGPUとLPUが共同で働きます。文脈を参照するアテンション演算4はGPUが、FFNのようなニューラルネットワーク計算の一部はLPUが担うよう構成します。Dynamoソフトウェアが2つの装置間の作業とデータ受け渡しを調整します。
Nvidiaが打ち出した「最大35倍」は、ユーザーあたり毎秒400トークンを生成する条件下で、GB200 NVL72と比べた電力あたりの全体推論スループットを比較した数値です。同じ電力でより多くのリクエストを処理できるという説明であって、すべての質問の回答時間が35分の1に縮まるという意味ではありません。
顧客は自社サービスが求める応答速度と同時ユーザー数を基準に比較する必要があります。素早い応答が必要なコーディングエージェントと、夜間に大量の文書を処理する作業とでは、適した構成が異なる場合があります。
Groq 3 LPXとベラ・ルビンベースの製品は、GTC発表時点で2026年下半期の供給が予定されていました。発表資料の性能を実運用でも得られるかどうかは、出荷後の顧客環境で確認すべき部分です。
設備価格とトークン処理コストを併せて見る
今回のGTCで私が最も注目したのは、Nvidiaが設備の価値を説明する方法です。設備1台の価格だけでなく、電力と時間をどれだけ使って求める応答を作るかまで計算しようという話です。Nvidiaはこれをトークンエコノミクスと呼んでいます。
顧客の立場からすれば、高価な設備であっても同じ品質の作業をより低コストで処理できるなら検討する理由があります。ただし、設備価格に電力・冷却・運用コストを加え、実際の稼働率と使用期間まで考慮する必要があります。最大性能だけで購入の経済性を判断することはできません。
生成AIは、保存された結果をそのまま表示するサービスとは異なり、リクエストが来るたびにモデルを実行して答えを作ります。リクエストが長い、あるいは複数の段階を経る場合は演算量が増える可能性があります。答えを何度も検討したりツールを呼び出したりする作業であれば、その過程にかかるコストまで合算する必要があります。
エージェントの使い方もコストに影響します。機能を分けると次のとおりです。
- 生成:ユーザーの要求に合わせて文章やコードを作る。
- 推論:答えを作るために中間の計算や検討を追加で行う。
- エージェント作業:ツールを呼び出し結果を確認しながら、ユーザーが任せた仕事を複数の段階で進める。
これらの機能は1つのサービスの中でも併用されることがあります。エージェントが何度もモデルを呼び出したり下位タスクを作ったりすると、一度きり答えるチャットボットよりトークンを多く使う場合があります。そのため、企業が業務ごとにAI利用予算を定めることが重要になります。すべてのリクエストが数十のエージェントを生み出すわけではないので、実際の業務における呼び出し回数とコストを測定する必要があります。
Nvidiaが価格を擁護する論理もここにあります。チップが安いというだけで運用コストまで低いとは言えない、というわけです。私はこの主張には説得力があると見ていますが、顧客が確認すべき単位はトークン数にとどまるべきではないと考えます。求める品質の作業を1件完了するのにいくらかかるかを見る必要があります。役に立たない答えを速く大量に生成しても、事業の助けにはならないからです。
Oswarldの視点
今回のGTCは、Nvidiaが顧客に販売する範囲を広げているという点で重要に見えます。GPUだけでなく、CPU・推論装置・ネットワークと、それらを運用するソフトウェアまで併せて提供します。複数の製品をつなぐ手間を減らしてくれる代わりに、顧客が他社に乗り換える際に変えなければならない部分も増える可能性があります。私はこの乗り換えコストに注意を払って見ています。
Groqとの契約は、競争構図を見るうえでも意味があります。GPUの代替として注目されていた推論技術を、Nvidiaが自らのプラットフォームの中に組み込んだからです。ただし、Groqという独立企業や他の推論チップ企業が残っているため、競合を完全に排除したとは言い難いです。どの製品を顧客が個別に選べて、どの機能が抱き合わせで提供されるのかを見守る必要があります。
中国事業も変数です。ジェンスン・フアンは3月17日の記者会見で、米国の輸出許可と中国顧客の注文を受けてH200の生産を再開していると明らかにしました。ロイターは別途、中国向けに販売できるGroqベースの製品を準備中であり、5月の供給を見込んでいるという関係筋の説明を報じています。後者は確定した発売発表ではありません。私はこれを中国需要をつなぎとめようとする動きと読んでいますが、実際の供給は両国の承認と製品ごとの条件に左右されます。
メモリ企業の投資も続いています。SKハイニックスは2月、龍仁第1ファブとクリーンルーム2~6期の建設に約21兆6,000億ウォンの追加投資を決定しました。チェ・テウォン会長はGTC現場で、ウエハー供給不足が2030年まで続く可能性があると見通しを示しました。投資決定と長期予測はそれぞれ確認する必要がありますが、これを半導体需要や収益がこれからも保証されるという意味に受け取ってはいけません。
私に残る問いは、この投資をエンドユーザーがどれだけ支えられるかということです。クラウド企業が設備投資を減らしたり、AIサービスの有料需要が期待に届かなかったりすれば、Nvidiaの予測も変わり得ます。統合製品の利便性が顧客の選択権や競争にどう影響するかも、引き続き見ていく必要があります。
おわりに
今回の発表を見て、私は3つのことを確かめようと思います。1兆ドルの予測が実際の出荷と売上につながるのか、GPUとLPUの分業が顧客業務でコストを減らすのか、そしてAIサービスを使う顧客がそのコストに見合う価値を得るのか、という点です。
Nvidiaはチップ事業を土台に、データセンター全体の構成と運用までを提案しています。この戦略を評価する際は、製品の最大性能と顧客が実際に得る成果を併せて見るのがよさそうです。
発表内容をご自身で確認したい場合は、以下の基調講演と公式技術資料をご覧ください。性能グラフを読む際は、比較対象やユーザーあたりの応答速度といった測定条件も併せて確認してください。


参考資料と関連リンク
- NVIDIA、GTC 2026基調講演、2026.03.16:製品と事業予測を紹介した発表です。
- NVIDIA、FY2026決算発表、2026.02.25:年間売上と次四半期ガイダンスの公式資料です。
- NVIDIA、Vera Rubin Opens Agentic AI Frontier、2026.03.16:プラットフォーム構成と供給計画を説明しています。
- NVIDIA、Inside NVIDIA Groq 3 LPX:GPU・LPUの分業と「35倍」性能比較の条件を説明しています。
- Groq、NVIDIAとの非独占的技術使用契約、2025.12.24:人員入社と独立事業維持に関する公式発表です。
- DCD、Jensen Huangの1兆ドル予測とCFOによる範囲の説明、2026.03.16。
- NVIDIA、BYD・Geely・Isuzu・NissanによるDRIVE Hyperionの採用、2026.03.16。
- Reuters、H200生産再開に関するジェンスン・フアン発言、2026.03.17;中国向けGroq製品準備の報道、2026.03.17~18。
- 聯合ニュース、SKハイニックス龍仁ファブ追加投資、2026.02.25;Reuters、チェ・テウォン会長のウエハー供給見通し、2026.03.16。
筆者アン・グァンソプ(安光涉)は世宗大学校経営学科教授であり、INLEVEL9リードコンサルタントを務める。大学では経営データ管理、ビジネスアナリティクスなど統計およびデータ分析を教える一方、現場ではGTM戦略とAI戦略コンサルティングを率い、技術とビジネスの接点を設計している。AI対話システムの記憶アーキテクチャ(HEMA)研究で学術論文を発表し、毎日グローバルなAI論文をキュレーションするDaily Arxivプロジェクトを運営している。高麗大学校技術経営専門大学院修士課程とKMBAを修了した。著書に『考えを委ねる人々:ホモ・ブレインレス』がある。

각주
あわせて読みたい過去の号
AIモデル70種類以上が、オープンエンドな質問に似た答えを出しました
異なるAIに聞いても似たようなアイデアが出てくることがあります。Artificial Hivemind研究の実験条件と、文章執筆への示唆を見ていきます。
AI・テックEメールに1ウォンの切手を貼れば、スパムは消えるのか
メッセージの送信に少額または計算コストを課せば、スパムを減らせるのでしょうか。古くからある提案の利点と、実際の導入における難しさを見ていきます。
AI・テック予測市場では取引記録が残っていても、インサイダーの特定は難しい
企業の解雇、取引所の懲戒、刑事起訴はそれぞれ異なる措置です。予測市場の疑わしい取引を立証するために何が必要なのか、2026年初めの事例から見ていきます。
AI・テック
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。