

北朝鮮の学報に登場したGPT-4、論文公開と技術格差の関係
金日成綜合大学の学報がGPT-4とREALMの論文を引用しました。公開された研究を読むことと、AIモデルを実際に開発・運用するために必要な能力の違いを考えてみました。
ビジネス金日成綜合大学学報に登場したGPT-4とREALM
金日成綜合大学学報「情報科学」2026年第72巻第1号に、「知能検索体系における質問推薦モデルの訓練資料構築方法」という論文が掲載されました。NK経済が紹介した学報の画像には、GPT-4とClaude-2について説明した箇所があり、参考文献にはOpenAIのGPT-4技術報告書とGoogle研究陣のREALM論文が並んで記載されています。
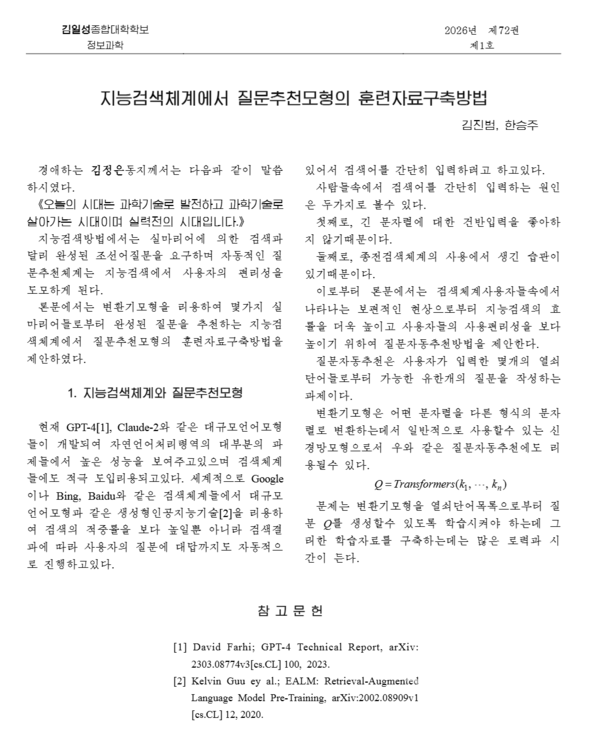
北朝鮮の研究者が海外のAI論文を読んでいるという事実自体は、驚くべきことではありません。両方の資料ともインターネット上に公開されているからです。今回の報道では、北朝鮮の検索システム研究が海外の言語モデル研究をどのように参考にしているかを見ることができました。
私はこの事例を見て、公開された研究と実際の開発能力の違いについて考えました。ちなみに私は大韓民国陸軍の兵長として満期除隊し、予備軍を終えた民防衛隊員です。北朝鮮の軍事的脅威を軽視しようという意図ではありません。この文章では、公開された論文から確認できる技術的な内容に焦点を当てたいと思います。
論文のテーマと引用された文献
論文の著者はキム・ジンボム、ハン・スンジュです。ユーザーがいくつかの単語を入力すると、それらの単語から質問文を推薦するモデルを研究しました。検索意図を文章として表現できるよう助ける機能だと理解すればよいでしょう。日常で目にする検索語推薦と目的は似ていますが、GoogleやNAVERが使用している方式と同一だという意味ではありません。
研究陣はトランスフォーマーモデルで質問文を作るための訓練資料構築方法を提案しました。公開された最初のページでは、この研究の背景として海外の大規模言語モデルを紹介しています。
導入部では、GPT-4とClaude-2が自然言語処理タスクで高い性能を示し、検索システムにも導入されていると説明しています。
続いて、Google、Bing、Baiduが検索に生成AIを組み合わせる動向に言及しています。ただし、この説明と参考文献だけで、研究陣がGPT-4を直接使用したり、同規模のモデルを開発したと見ることはできません。
参考文献から確認できる範囲についても区別しておく必要があります。
GPT-4技術報告書は2023年にarXivで公開されました(arXiv:2303.08774)。REALMは2020年のICMLで発表された論文です(学会原文)。どちらも別途秘密資料を入手しなければ読めない文献ではありません。
2026年の学報が2023年の論文を引用したからといって、北朝鮮の技術水準が3年遅れていると計算できるわけではありません。引用の時点は研究者が最初に読んだ時点と異なる場合があり、読んだ内容を再現したかどうかも示してくれません。技術格差を判断するには、同じタスクで測定した性能と学習・運用条件が必要です。
公開報告書で分かることと分からないこと
GPT-4は報告書が公開されましたが、その報告書だけで同じモデルを再現できるように開発情報がすべて公開されたわけではありません。
報告書は、モデルサイズと詳細な構造、使用したハードウェアと学習に用いた計算量、データセットの構成と学習方法の詳細を明らかにしないと明記しています。競争上および安全上の理由を挙げています。
その代わりに、評価結果や限界、安全性の検討を公開しました。人間のフィードバックを用いた強化学習(RLHF)1を適用したという説明も含まれています。後続の研究者はこうした資料から、どのタスクが重要で何を評価すべきかを参考にできます。しかし、同じ結果を得るために必要なデータと実装方法までは手に入りません。
REALMは、外部文書を検索しながら言語モデルを学習する方法を扱った研究です。今日のRAG2につながる初期の研究のひとつですが、検索と言語モデルを組み合わせたすべての手法の最初の発明だとは言いがたいです。学習過程においても検索器を一緒に改善した点が、この論文の貢献です。
研究の公開は、他の研究者が手法を検討し、後続の研究を続けられるようにします。企業も研究成果を知らせ、人材を集めるうえで助けになります。同時に、公開した情報は競合他社も読むことができます。企業ごとにどこまで公開するかの選択が異なる理由です。
AI分野では、論文に加えてコードやモデルの重み(ウェイト)を公開する場合もあります。重みは学習によって得られた数値であり、これを公開すると他の開発者がモデルを実行したり追加学習したりできます。研究の方向性だけを紹介する報告書と、実行可能なモデルの公開とでは、後続の開発に与える助けが異なります。
モデルを読み、作り、運用するために必要な能力
公開資料が増えても、大型モデルを最初から学習させるコストがなくなるわけではありません。データの収集と精製、計算機器、電力、学習中に発生するエラーを解決する人員が同時に必要です。
北朝鮮の開発能力を判断する際にも、こうした条件を見る必要があります。ただし、外部で確保できる資料が限られているため、北朝鮮がどのような機器を何台保有しているかまで断定するのは難しいです。
38 Northの2024年の研究は、北朝鮮の学術誌や公開資料から音声・文字認識、監視、軍事シミュレーションなど複数のAI研究を確認しました。同時に、制裁によって機器の確保が制約を受ける可能性があり、実際の能力を評価するのは難しいと説明しています。公開論文があるからといって、大規模なサービス運用まで確認されたわけではないという意味です。
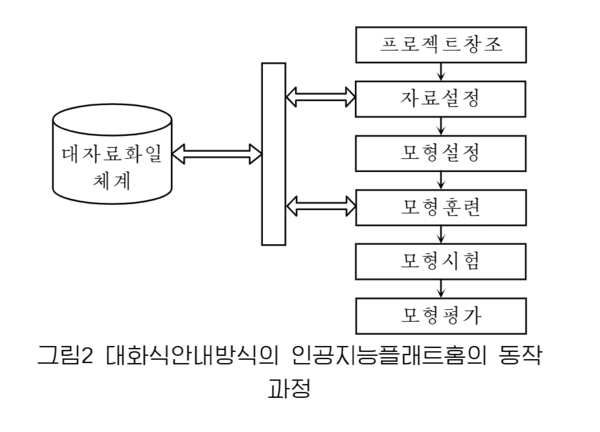
企業の競争力を見る際にも、以下の要素を別々に検討する必要があります。
研究と実装の知識: 公開論文は研究の方向性を共有しますが、実験を成功させるために必要な詳細な経験や実装まですべて伝えるわけではありません。
学習インフラ: H1003のようなAIアクセラレーターだけでなく、機器間の通信、電力と冷却、障害対応が必要です。特定のチップを数万枚確保しなければすべての言語モデルを作れないというわけではなく、目標とするモデルの規模によって必要条件が変わります。
データと評価: 望む分野の資料を確保し精製する作業や、モデルの回答を評価する作業にもコストと専門性がかかります。合成データを使えるとしても、そのデータの品質を確認する必要があります。
サービス運用: ユーザーが望む機能を把握し、エラーを修正しながら安定的に提供する能力です。ユーザー数が多いほどフィードバックを得る機会も増えますが、すべての対話が自動的に学習に使われたり、モデルが毎日更新されたりするわけではありません。
公開モデルを活用する可能性と確認された事実
北朝鮮が言語モデルを開発できるかどうかを、単純な可能・不可能の問題として問うのは難しいです。小さな検索補助モデルと世界最高水準の汎用モデルとでは、必要な資源が大きく異なるからです。
大規模な学習には安定した電力供給が必要です。 電力不足は北朝鮮の開発規模を制約する要因として挙げられます。ただし、特定の研究機関の電力と設備を確認していない状態で、すべてのデータセンター運用が不可能だと断定することはできません。
モデルを最初から学習することと、既存のモデルを活用することは異なります。 推論はすでに学習済みのモデルで答えを生成する作業であり、ファインチューニング4は既存のモデルを特定のタスクに合わせて追加学習する作業です。必要な機器はモデルサイズ、処理量、学習方式によって変わります。コンシューマー向けGPUがあるという情報だけで、可能なモデルサイズを確定することはできません。
私は、資源が不足している開発組織であれば、公開されたモデルを活用する案も検討するだろうと考えています。中国のQwenやDeepSeekのように重みを公開したモデルがその例です。しかし、これは可能な開発方式についての私の推測です。今回の学報が実際にどの公開モデルを使用したのかは、別途確認する必要があります。
Qwen2.5の公式紹介は、韓国語を含む29以上の言語のサポートを明示しています。しかし、韓国語のサポートが北朝鮮の語彙や検索環境で十分な性能を保証するわけではありません。また、中国の朝鮮族人口が多いという事実だけで、どの資料がどれだけ学習されたかを推定することもできません。
公開モデルを活用すれば、新しいモデルを最初から学習する負担を減らすことができます。それでも、適切な資料を用意し、質問推薦の結果を評価する作業は残ります。コストが何分の一に減るのか、特定のGPU数量で目標を達成できるのかは、実際の実験条件がなければ判断できません。
今回の学報から明確に確認できるのは、海外の言語モデル研究を背景に質問推薦の方法を研究したという点です。GPT-4と同等のモデルを作ったという宣言でも、中国製の公開モデルを採用したという証拠でもありません。
Oswarldの視点
私はこれまで複数の市場進出戦略を立てる中で、技術を保有することと、顧客が継続的に使い続けるサービスを作ることが異なるという点をよく見てきました。技術が公開されて立ち上げのコストが下がっても、顧客の業務に合わせて安定的に運用することは依然として難しいものです。
AIプロダクトもモデルの性能だけで競争力を説明することは難しいです。同じ公開モデルを利用しても、どのような資料を連携させ、どのような業務を支援し、エラーが発生したときにどう対応するかによって顧客の体験は変わります。今回の北朝鮮の学報の事例は、こうした違いについて考えさせられました。ただし、論文1本で国家や企業の間の技術格差が何ヶ月縮まったと言うことはできません。
OpenAIのような企業を評価する際にも、私はモデルの性能と併せて、サービスの安定性、顧客の要求を反映する速度、企業向けカスタマーサポートを見るようにしています。こうした運用能力は、論文を読んだりモデルをダウンロードしたりするだけでは得にくいものです。だからといって、研究開発能力の重要性が下がったと断定する必要はありません。
また、大型の汎用モデルを自前で開発できないからといって、AI活用の影響までが小さいと見ることはできません。38 Northが分析した監視や軍事シミュレーションのような特定目的の応用も、別途検討する必要があります。
韓国企業にも同じ判断が当てはまります。韓国語をサポートするという点だけでなく、特定の顧客の業務や資料をどれだけよく理解しているか、実際の使用中に発生する問題をどれだけうまく解決できるかが、事業機会を分けると考えています。
おわりに
今回の事例を読む際に区別すべき点は3つあります。
- 金日成綜合大学学報にGPT-4とREALMの論文が引用された。引用の事実だけで、実装方式や技術格差を知ることはできない。
- 大型モデルの事前学習、公開モデルの追加学習、モデルを実行する推論は必要な資源が異なる。北朝鮮の実際の選択は、追加の資料がなければ判断できない。
- 企業のAI競争力も、モデルの性能とデータ、開発・運用能力を合わせて見る必要がある。
ちなみに、上記の報道を行ったNK経済が創刊8周年を迎えてセミナーを開催するそうなので、興味のある方はぜひ足を運んでみてください。私は日程が合わず参加できませんが、「人工知能(AI)時代、北朝鮮のデジタル転換の現状」というテーマで、北朝鮮専門家の方々が北朝鮮でIT技術がどのように受け入れられ、使われているかを教えてくださるそうです。
NK経済創刊8周年セミナー参加申し込み○ 2026年6月17日午後、NK経済が創刊8周年セミナーを開催します。参加をご希望の方は、下記のフォームに沿ってお申し込みください。


参考資料と関連リンク
主要出典
- カン・ジンギュ、「グローバルLLMを追いかける北朝鮮…金日成総合大学学報でオープンAI、グーグルの論文引用を捕捉」、NK経済、2026年。:金日成大学学報の原文画像と引用文献の表記を直接確認できる報道です。
- OpenAI、「GPT-4 Technical Report」、arXiv:2303.08774、2023年。:北朝鮮の学報が引用した、まさにその報告書です。何が公開され、何が伏せられているのかを直接比較してみる価値があります。
- Kelvin Guu、Kenton Lee、Zora Tung、Panupong Pasupat、Ming-Wei Chang、「REALM: Retrieval-Augmented Language Model Pre-Training」、ICML 2020(arXiv:2002.08909)、2020年。:外部文書の検索を言語モデルの学習と結びつけた初期の研究です。紹介された学報の画像には、タイトルのREALMがEALMと表記されています。
背景知識
- 「Sanctions Built North Korea’s AI Playbook: How Pyongyang Boosts Performance Without Nvidia’s H100」、KMJ、2026年。:コンピューティングインフラの制約の下で、北朝鮮のAIがなぜ効率・軽量化の方向に固まったのかを整理した分析です。
- 「North Korea’s Risky Bet on Military AI」、The Diplomat、2026年3月。:38 Northの分析を引用し、「電力出力がデータセンター稼働に不足している」という点を指摘しています。北朝鮮のAI開発と電力制約を扱った分析です。
- Qwen Team、「Qwen2.5 Technical Report」、arXiv:2412.15115、2024年。:中国製オープンソースLLMが韓国語をどのような方式で学習・評価しているかを確認できる一次資料です。
- 「Emerging Applications and Implications of Artificial Intelligence in North Korea」、Asian Politics & Policy、2025年。:北朝鮮のAI政策に関する学術的分析が必要な場合、この論文はよい出発点になります。
각주
-
RLHF(Reinforcement Learning from Human Feedback):人間の評価者が「この回答のほうが良い/悪い」と付けたフィードバックを報酬信号として、AIモデルを強化学習で調整(アライメント)する手法です。ChatGPTが私たちに馴染みのある形で応答するようになった重要な秘訣です。 ↩
-
RAG(Retrieval-Augmented Generation):AIが回答する際に、外部の文書データベースから関連資料を先に検索し、その検索結果を参考にして答えを作る方式です。関連する根拠や出典を提示するのに役立ちますが、検索や回答が誤る可能性は残ります。 ↩
-
H100:Nvidiaが開発したデータセンター向けのAIアクセラレーターです。大規模モデルの学習と実行に使われる機器のひとつです。すべての言語モデルがH100を必要とするわけではありません。 ↩
-
ファインチューニング(Fine-tuning):すでに事前学習された巨大モデルの上に、特定のドメインや言語、タスクに合わせたデータを追加で学習させ、モデルを専門化する過程です。最初からモデルを学習する負担を減らせますが、その削減幅はモデルサイズ、データ、学習方式によって変わります。 ↩
あわせて読みたい過去の号
プレスリリースの成長率を確認する方法、AI検証サービスの限界
成長率を理解するには、基準となった数値と測定方法が必要です。AIで報道を検証するObjectionは、この問題をどこまで解決できるのでしょうか。
ビジネスMeta広告に加算される2〜5%の手数料、デジタル税は誰が負担するのか
Metaが6カ国向け広告に別途手数料を課すと予告しました。広告主にとって増える費用と、最終消費者価格への影響は分けて見る必要があります。
ビジネスマスクのOpenAIモデル活用認定、蒸留にどんな基準を適用すべきか
マスクは、xAIがOpenAIモデルを蒸留したかという質問に「部分的に」そうだと答えました。この発言で確認された事実と、まだ分からない点、競合モデル活用に必要な一貫した基準を整理します。
ビジネス
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。