

即使解开了难题,也无法判断是否是真正的专家了
被称为数学界诺贝尔奖的菲尔兹奖的25位得主发表的宣言,与咨询市场31%的数据,讲述着同一个故事
商业宣言中出现了“代理指标”这个词
2026年9月11日,25位菲尔兹奖得主在一份联合宣言上署名。宣言指出,AI企业把攻克数学难题当作性能指标的做法,与数学这门学科的目标严重背离。签名者从1978年得主皮埃尔·德利涅(Pierre Deligne)到2026年得主Wei Deng(音译),跨越了几代人,韩裔数学家许埈珥教授也在名单之中。
宣言的核心不是批评,而是一句定义。它写道,解题本身只是一种工具、一种代理指标1,用来衡量是否达到了概念性理解这个真正的目标。如果把工具误认成目标,工具就会伤害目标本身。
两天后,截至9月13日,签名人数已增加到4,432人。签名页面需要通过ORCID登录或所属机构邮箱验证,姓名才能被列入名单。就连这份宣称代理指标已经崩溃的文件本身,也另外设置了确认签名者是否为真实研究者的机制。
我没能把这份宣言仅仅当作数学界内部的事件来读。因为我早已在另一个市场里看到过同样的故障。
难题曾是数学界的测量工具
数学中著名的难题一直同时承担着两件事。一件是内部的事。难题被攻克,意味着在这个过程中诞生了新的方法和概念,数学家们通过发表、讨论与整理,把这些想法转化为公共工具。
另一件是外部的事。虽然我说不清楚伽罗瓦表示(Galois representation)是什么,但我知道费马大定理已经被证明了。难题就是那把即使不懂数学的人也能借以判断实力高低的刻度。
宣言真正质疑的,不是AI攻克难题这件事本身,而是解法被仓促公开的过程中,缺少了正规的整理、对先行研究的引用,也缺少了把想法提炼打磨的过程。签署者写道,这正是归属与剽窃问题产生的根源。结果出来了,但如果理解并接续这个结果的人消失了,刻度会留下来,而刻度原本要衡量的东西却不复存在。
说得简单一点,数学家们所说的危险,是指如果不断跳过所有中间过程、只顾着抓住答案,这样的过程反复发生,数学的本质与原理就会变得模糊不清。
比方说,如果一道数学题的正确答案是-1、0、1三者之一,那么蒙对的概率就是33.3%,但真正有实力解开这道题的学生会用公式和论述来作答,而有些人则会靠猜答案蒙过去;如果人工智能式的解题方式大行其道,那以后还有谁会去学数学呢?
数学只是这件事表现得最明显的地方。而在标好价格的市场里,裂痕其实早就已经存在了。
<<<OZ_BODY>>>
咨询市场早就是靠自我申报运转的
有一个叫做专家网络2的市场。投资公司和咨询公司在这里向特定行业的从业者购买一小时的通话。Guidepoint 宣称拥有 200 万名以上的专家资源池,GLG 则表示拥有超过 100 万名专家。
2025 年 12 月 4 日,一家研究该行业的调研公司公布了对参与咨询的 1,368 名专家进行问卷调查的结果。约 31% 的受访者表示自己曾参与过并非自身专长领域的通话。1,368 人中约有 420 人。报告指出了三个原因:专业能力由本人自行申报、必须在 24~48 小时内完成需求匹配的交付期限,以及依靠关键词来筛选人选的匹配方式。
这里有一点需要指出来。**在导致资质不符通话产生的原因清单中,AI 根本不在其列。**验证机制并不是被 AI 破坏的,它从一开始就依赖于自我申报。同一项调查显示,客户每次支付 1,200 美元,而专家拿到的报酬不到该费用的 20%,这中间的差额,站在购买者的角度看,其实就是为验证所支付的费用。由于这是针对行业参与者的自我报告式问卷调查,数字应当宽泛地看待,但没有理由怀疑其方向是错的。
专家网络在通话前后运行的合规程序相当严密。但那是用来防止未公开重大信息外泄的装置,并不是用来衡量这个人当时是否真的做过那件事、此刻所说的是否是他本人的判断的装置。
<<<OZ_BODY>>>
买方与卖方都在同时转向模型
从需求端看,变化更快。Guidepoint宣布截至2026年3月26日,专家访谈记录已突破10万份,5月5日又通过MCP3将该资料库接入了Claude。8月26日,又将12万份以上的记录接入了Gemini Enterprise。由于每月新增5,000份的结构,规模会随时间不断扩大。AlphaSense和Tegus都在宣传由AI而非真人主持的专家通话,价格比以往便宜70%,GLG也提供由AI主持的通话服务。
向真人提问所得到的答案变成录音记录,录音记录成为模型的输入数据,而下一个问题则不再问真人,而是问模型。曾经买过的一小时,正在变成可以被反复出售的资产。
价格会朝哪个方向变动,也不难猜到。对于已有录音记录就能给出答案的问题,已经没有购买通话的理由,因此常见问题的通话单价会先下降。相反,对于资料库中没有的问题——也就是尚无人留下记录的判断——则会被标出价格。这并非各公司公布的事实,而是我根据当前结构所作出的推测。
供给端也在朝同一方向移动。相当一部分咨询是以书面形式进行的,而这种形式恰恰是模型最擅长应答的形式。即便改为视频通话,情况也不会有太大不同。因此买方很难判断自己买到的究竟是真人还是模型,卖方也没有恰当的方法证明自己是真人。尽管双方都因此蒙受损失,交易却依旧照常发生。
那么,究竟能证明什么呢
走到这一步,剩下的答案只有一个。不是正确答案,而是亲身经历过的事情。可问题是,认证经验的方法相当模糊。分成三层来看,就能看出哪里是空白的。
| 层级 | 能证明的内容 | 由谁确认 |
|---|---|---|
| 归属与年限 | 曾在哪里待过多少年 | 公司、学校、机构 |
| 判断的记录 | 何时决定了什么、什么地方判断错了 | 如今只有本人 |
| 结果的归因 | 那项成果是否因为我的判断 | 没有确认体系 |
第一行可以确认,但说明不了实力。第三行能说明实力,却无法确认。所以真正的验证,其实是在第二行分出胜负。对研究者来说,ORCID 和引用记录填补了这个空位,但对实务工作者来说,并没有这样的东西。
**同样的原理,在咨询通话之外也照样起作用。**履历表、提案书、作品集、面试回答,全都是代理指标,如今光靠做得漂亮已经无法筛选出任何东西了。写得好的文档曾是实力证据的那个时代,很快就结束了。像韩国这种以书面资料和一次性发表来评估人的惯例根深蒂固的市场,会更直接地迎面撞上这个变化。
如果是买方,最省钱的应对方式就是换个问法。市场展望或结构性说明,模型往往更快、也常常更准确。但如果换成问对方当时反对过的决定、失败过的案例以及之后修改的标准、以及现在这个答案里最有可能出错的地方,得到的答案性质就会不一样。因为在特定时点、以自己名字担保做出的选择及其代价,是搜索不出来的。如果是卖方,把那种选择与代价以带时间戳的形式留存下来,本身就会变成资产。
也有人把这份宣言解读为“红旗法”
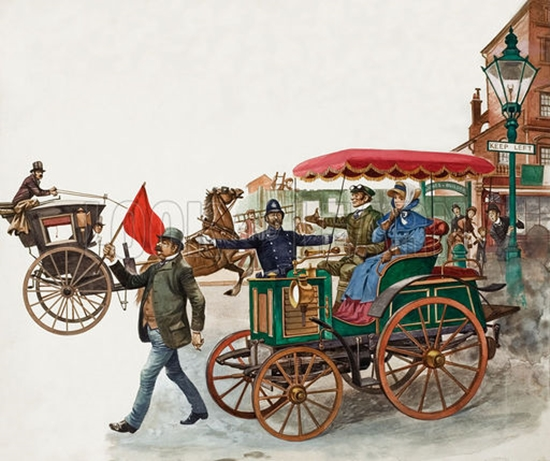
也出现了相反的解读。1865年,英国制定法律,规定汽车前方必须有人举着红旗步行引路。这被称为马车利益集团拖慢新技术速度的代表性案例。也有人这样解读菲尔兹奖得主们的宣言:这终究是即将失去位置的一方发出的抗议。此外,还有人主张,今后解数学题会像国际象棋一样,仅仅作为一种智力游戏留存下来。
时间点也值得推敲。2002年,一位名叫Paul Lockhart的数学教师写了一篇题为《一个数学家的叹息》的文章。他写道,学校数学剔除了发现的过程,只剩下结果。三角形面积等于底乘高的一半,这个事实本身不是数学,得出这个事实的那一句灵感才是数学,可学校却只是让学生背公式了事。数学课上没有数学——这就是他的结论。**同样的抱怨在24年前就已经存在,而那时候的对手不是AI,而是数学界自己制定的课程。**这也是很难把这次的宣言看作是新技术出现后仓促拿出的防御反应的原因。
不过,一旦请出Lockhart,数学界那边也不会轻松。 我也是因为这个原因,在创办咨询公司时首先做的一件事,就是宣布不卖报告。反正报告人工智能很快就能写出来。倒不如把那段时间用来搭建可运行的PoC/MVP,或者开办工作坊,这样更划算。
游戏论这一方反而支撑了这篇文章的论点。 人们花钱观看比计算机弱的棋手比赛。解题变成游戏,意味着它在那一刻褪去了证明实力的功能,而这恰恰就是代理指标消失的过程。区别只在于,咨询市场没有人愿意为观赏付钱。
Oswarld视角
我目前他们说,自从LLM普及之后,几乎没有办法区分专家了。书面咨询会被AI代答,即便是视频咨询,也有很多前沿模型可以实时作答,这是事实。
所以现在验证专家的方式只剩下经验,而我一直卡在这一点上:认证这份经验的方法很模糊。我在某家公司待过多久是可以确认的,但当时做了什么判断、那个判断是否正确,除了我自己的话之外没有别的依据。除了自己把上面表格的第二行填好之外,我还没找到眼下能用的手段。
有一点看起来是明确的:菲尔兹奖得主们想要守护的东西,和顾问负责人所烦恼的问题,本质上是同一类问题。两者都不是在失去对成果质量的判断,而是在失去辨认出创造成果之人的能力。只不过数学界已经有论文、引用和所属机构这样的验证机制,而实务专家市场只剩下自我申报。所以我认为,这个市场会更早、也更悄无声息地崩塌。
<<<OZ_BODY>>>
结语
代理指标本来就是在无法直接衡量实力时暂时借用的工具。解题、写好书面答案、流畅地讲解,都是如此。如今这个临时工具被模型拿走了,剩下的是亲身经历过的事和当时做出的选择。问题在于,目前还没有能够证明这一点的体系。
如果读者您正处在需要判断某人专业能力的位置,短期内比起答案的质量,问对方答案是如何形成的会更稳妥。这个问题会不会让越来越多的人真的答不上来,我也会持续关注下去。
💬 最近您在判断某人的专业能力时,是看什么来做决定的?如果有失效的判断标准,也很想听听。
📨 如果身边有需要请顾问或外部专家的同事,请把这篇文章转给他们。哪怕只是换一套提问清单,也能立刻派上用场。


参考资料与延伸阅读
核心来源
- Math and AI,“A Severe Misalignment of AI in Mathematics”,2026 年 9 月 11 日。……声明原文、25 位早期签署者名单以及签署流程都在同一页上。
- Terence Tao,“A Severe Misalignment of AI in Mathematics”,What’s new,2026 年 9 月 11 日。……签署者本人附上了一段关于声明是如何形成的简短说明。
- Woozle Research,“The State of the Expert Economy 2025”,2025 年 12 月 4 日。……资格不足回应占比 31% 的分母构成与原因分析都在其中。
- Guidepoint,“Guidepoint Launches MCP on Claude”,2026 年 5 月 5 日。……公司亲自说明了专家通话录音转文字如何成为模型输入的结构。
背景知识
- GLG,“Expert Calls”。……可以确认合规流程审查的是什么、又不审查什么。
- Paul Lockhart,“A Mathematician’s Lament”,2002。……这是一篇 25 页的原文,光读从音乐教育噩梦讲起的前两页,就能看出这次声明的根源所在。
- Guidepoint,“Guidepoint Accelerates Enterprise AI Transformation with Gemini Enterprise”,2026 年 8 月 26 日。……可以对比录音转文字的规模在五个月间是如何增长的。

你的观点会成为下一期的线索
欢迎留下你的经验与看法。