

難問を解いても、本物の専門家かどうかわからなくなりました
数学のノーベル賞と呼ばれるフィールズ賞受賞者25人の宣言と、コンサルティング市場の31%が同じ話をしています
ビジネス宣言文に「代理指標」という言葉が出てきます
2026年9月11日、フィールズ賞受賞者25人が共同宣言文に名前を連ねました。AI企業が数学の難問を解くことを性能指標にしているやり方が、数学という学問の目標から大きく外れているという内容です。1978年受賞者のピエール・ドリーニュから2026年受賞者のウェイ・ダンまで世代をまたいでおり、韓国系数学者のホ・ジュニ(許埈珥)教授も名簿に名を連ねています。
宣言文の核心は批判ではなく、一行の定義です。問題を解くことは、概念的理解という本当の目標に到達したかどうかを測るための道具であり、代理指標1にすぎないという一文です。道具を目標だと錯覚すれば、道具そのものが目標を損なうということです。
2日後の9月13日時点で、署名者は4,432人まで増えました。署名ページはORCIDログインか所属機関のメールアドレス確認を経なければ名前が登録されません。代理指標が崩れたと述べる文書自体にも、署名した人物が本当に研究者であるかを確認する仕組みが別途組み込まれているわけです。
私はこの宣言を、数学界の中だけの出来事として読むことができませんでした。同じ故障を、別の市場で先に見ていたからです。
難問は数学界の測定ツールでした
数学において有名な難問は、二つの役割を同時に担ってきました。一つは内側の役割です。難問が解かれたということは、その過程で新しい方法や概念が生まれたという信号であり、数学者たちは発表と議論と整理を経て、そのアイデアを共有の道具に変えてきました。
もう一つは外側の役割です。私はガロア表現が何かを説明できなくても、フェルマーの最終定理が解かれたことは知っています。難問は、数学を知らない人でも実力を見極められるようにしてくれる目盛りでした。
宣言文が問題視しているのは、AIが難問を解くという事実そのものではありません。解答が急いで公開される過程で、まともな整理も、先行研究の引用も、アイデアを取り出して洗練させる作業も欠けてしまう点です。署名者たちは、ここに帰属と剽窃の問題が生じると記しています。結果は出たのに、その結果を理解し引き継ぐ人がいなくなれば、目盛りだけが残り、目盛りが測っていたものは消えてしまいます。
簡単に言えば、数学者たちが危険だと言っているのは、途中の過程をすべて飛ばして答えだけをぽんと手に入れるやり方が繰り返されると、数学の本質と原理が曖昧になってしまうということです。
たとえば正解が-1、0、1のいずれかである数学の問題があるとすれば、答えを当てる確率は33.3%でしょうが、この問題を解く実力のある学生は公式と記述によって解答するはずで、誰かは単答で当て推量して解くはずです。AI式の解き方が広まってしまえば、これからいったい誰が数学を勉強するのか、という話です。
数学は、それが最も目立つ場所であるにすぎません。値付けされた市場では、すでにずっと前からひびが入っていました。
アドバイザリー市場はすでに自己申告で回っていた
エキスパートネットワーク2という市場があります。投資会社やコンサルティングファームが、特定の業界の実務者に1時間の電話を買う場所です。ガイドポイントは200万人以上、GLGは100万人を超える専門家プールを持っていると公表しています。
2025年12月4日、この業界を研究するリサーチファームが、アドバイザリーに参加した専門家1,368人を対象にした調査結果を発表しました。回答者の約31パーセントが、自分が十分な資格を持っていないテーマの通話に参加したことがあると答えました。1,368人中420人余りに当たります。報告書は原因として三つを挙げています。専門性を本人が申告する仕組みであること、依頼を24〜48時間以内に埋めなければならない納期、そしてキーワードで人を選ぶマッチングです。
ここで一度確認しておきたいことがあります。資格不足の通話が生まれた原因のリストに、AIは入っていません。 検証はAIが壊したのではなく、そもそも自己申告に依存していたのです。同じ調査では、顧客が1件あたり1,200ドルを支払う一方で、専門家が受け取る取り分は請求額の20パーセントに満たないと出ていますが、その差額は買う側からすれば検証に対して支払った対価だったわけです。業界参加者を対象にした自己回答式の調査なので数値は幅を持って読むべきですが、方向性まで疑う理由はありません。
エキスパートネットワークが通話の前後に走らせるコンプライアンス手続きは緻密です。しかしそれは未公開の重要情報がやり取りされるのを防ぐための仕組みです。この人物がその時期にその仕事を実際にしていたか、今語っている内容が本人の判断なのかを測る仕組みではありません。
買い手と売り手が同時にモデルへと変わっている
需要側から見ると、変化のスピードは速いです。ガイドポイントは2026年3月26日、専門家インタビューの録音書き起こしが10万件を超えたと発表し、5月5日にはそのライブラリをMCP3でClaudeに接続しました。8月26日には12万件以上をGemini Enterpriseにつなげています。毎月5,000件ずつ積み上がる構造なので、時間が経つほど大きくなります。AlphaSenseとTegusは人間の代わりにAIが進行する専門家通話を、従来比70パーセント安いと案内していますし、GLGもAIが進行する通話を提供しています。
人に尋ねて得た答えが書き起こしになり、書き起こしがモデルの入力になり、次の質問は人ではなくモデルに向かいます。一度買った一時間が、繰り返し売られ続ける資産に変わるわけです。
価格がどちらに動くかも、難なく見当がつきます。すでに蓄積された書き起こしで答えが出る質問には通話を買う理由がないので、よくある質問の通話単価から下がっていきます。逆に、ライブラリにない質問、つまりまだ誰も記録として残していない判断には値がつきます。これは各社が発表した事実ではなく、いまの構造を見て私が立てた予想です。
供給側も同じ方向に動いています。アドバイザリーの相当部分は書面でやり取りされますが、この形式こそモデルが答えるのに最も適した形式です。ビデオ通話に変えても事情は大きくは変わりません。だから買い手は人を買ったのかモデルを買ったのか分かりにくく、売り手は自分が人間であることを証明する手立てがありません。双方が損をしているのに、取引はそのまま起きています。
それで何を証明できるのか
ここまで来ると、残る答えは一つです。正解ではなく、経験した事実です。ただ、その経験を証明する方法がなかなか曖昧です。三つの層に分けてみると、どこが空白になっているかが見えてきます。
| 層 | 証明できること | 誰が確認するか |
|---|---|---|
| 所属と期間 | どこに何年いたか | 会社、学校、機関 |
| 判断の記録 | いつ何を決め、何が誤っていたか | 現時点では本人のみ |
| 結果の帰属 | その成果が自分の判断によるものか | 確認する仕組みがない |
一行目は確認できますが、実力を語ってはくれません。三行目は実力を語ってくれますが、確認ができません。したがって、実際の検証は二行目で分かれます。研究者にはORCIDや引用記録がこの部分を埋めてくれますが、実務者にはそういうものがありません。
同じ原理は、アドバイザリー通話の外でも変わらず働いています。 経歴書、提案書、ポートフォリオ、面接での回答は全部代理指標であり、もはや上手にまとめられているというだけでは何も見分けがつきません。よく書かれた文書が実力の証拠だった時代は、短く終わってしまったわけです。書面資料と一度限りの発表で人を評価する慣行が強い韓国のような市場は、この変化をより直接的に受けることになります。
買う側であれば、質問を変えることが最も安上がりな対応です。市場見通しや構造の説明であれば、モデルのほうが速く、しかもしばしばより正確です。そうではなく、その時点で本人が反対した決定、失敗した案件とその後変更した基準、そして今この答えの中で最も外れる可能性が高い部分を尋ねてみると、答えの性質が変わってきます。特定の時点で自分の名前を賭けて行った選択とその代償は、検索では出てこないからです。売る側であれば、その選択と代償を、時点が刻まれた形で残しておくことが、そのまま資産になります。
この宣言を赤旗法として読む視線もあります
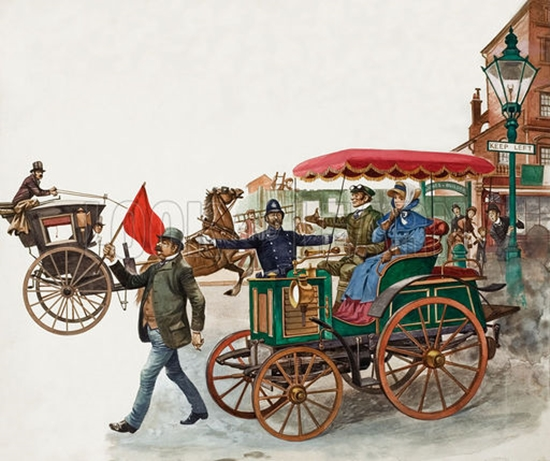
反対の解釈も出ています。1865年、イギリスは自動車の前を赤い旗を持った人が歩くよう法律を定めました。馬車側の利害が新技術の速度を遅らせた代表的な事例として語られる話です。フィールズ賞受賞者たちの宣言も、結局は居場所を失う側の抗議だという読み方です。これに加えて、数学の問題解きはこれからチェスのように知的遊戯として残るだろうという主張もあります。
時点も引っかかります。2002年にポール・ロックハートという数学教師が書いた『ある数学者の嘆き』という文章があります。彼は学校数学が発見の過程を取り除き、結果だけを残したと書きました。三角形の面積が底辺かける高さの半分だという事実ではなく、その事実にたどり着く一行のアイデアこそが数学なのに、学校は公式を暗記させて終わらせているというのです。数学の授業に数学がないというのが彼の結論でした。**同じ不満は24年前にすでに存在していて、その時の相手はAIではなく、数学界自身が作った教育課程でした。**新しい技術が現れたから急いで持ち出した防御だと見るのが難しい理由です。
ただし、ロックハートを持ち出すと数学界の側も楽にはなりません。 私もそれで、コンサルティングファームを立ち上げる際に最初にやったのが、レポートを売らないと決めることでした。どうせレポートはAIがすぐに書いてしまいますから。その時間で動くPoC/MVPを作っておいたり、ワークショップを運営したりするほうがいいわけです。
遊戯論の側はむしろこの文章の論旨を後押しします。 コンピューターより弱い棋士の対局を人々がお金を払って見ているわけです。問題解きが遊戯になるということは、その場で実力証明の機能が剥がれ落ちるということであり、それこそが代理指標が消えていく過程です。アドバイザリー市場には観戦料を払う人がいないという点が異なるだけです。
Oswarldの視点
私はLLMが広まった後、専門家を見分ける方法がほとんどなくなったという話でした。書面での相談はAIで答えられてしまい、ビデオで進めてもリアルタイムで答えるフロンティアモデルが増えているのが実情だからです。
そのため今、専門家を検証する方法は経験しかないのですが、私はその経験を証明する方法が曖昧だという点でずっと引っかかっています。私がどの会社にどれだけいたかは確認できますが、その時どんな判断をして、その判断が正しかったかは、私の言葉以外に根拠がありません。上の表の二行目を自分で埋めておくこと以外に、今すぐ使える手段をまだ見つけられていません。
一つだけ、はっきりしていることがあります。フィールズ賞受賞者たちが守ろうとしているものと、助言担当者が悩んでいるものは、同じ種類の問題だということです。どちらも、成果物の品質ではなく、その成果物を作った人を見抜く能力を失っていく最中にあります。ただ、数学界には論文と引用と所属という検証装置がすでにあり、実務専門家市場には自己申告しかないという違いがあります。だから私は、この市場のほうがより先に、より静かに崩れていくと見ています。
おわりに
代理指標は、もともと実力を測る代わりに使っていた暫定的な道具でした。問題を解くこと、書面で上手に答えること、流暢に説明すること、すべてそうでした。その暫定的な道具をモデルが持っていった今、残るのは経験したことと、その時に下した選択です。問題は、それを証明する体系がまだないということです。
読者さんが誰かの専門性を判断しなければならない立場にいるなら、当分の間は答えの品質ではなく、答えが作られた経路を尋ねるほうが安全です。その質問に答えが詰まる相手が実際に増えているかどうかは、私も引き続き見ていこうと思います。
💬 最近、誰かの専門性を判断しなければならなかったとき、何を見て決めましたか。失敗した基準があれば、それも知りたいです。
📨 顧問や外部の専門家を使う同僚がいれば、この記事を送ってください。質問リストだけ変えても、すぐに使えます。


参考資料と関連リンク
主要出典
- Math and AI、「A Severe Misalignment of AI in Mathematics」、2026年9月11日。···声明の原文と25人の初期署名者リスト、署名手続きまでが1ページにまとまっています
- Terence Tao、「A Severe Misalignment of AI in Mathematics」、What’s new、2026年9月11日。···この声明がどのように作られたかについて、署名者本人による短い説明が付いています
- Woozle Research、「The State of the Expert Economy 2025」、2025年12月4日。···資格不十分な回答が31パーセントという数字の分母と原因分析が示されています
- Guidepoint、「Guidepoint Launches MCP on Claude」、2026年5月5日。···専門家との通話の書き起こしがモデルの入力として使われる仕組みを、当該企業自身が説明しています
背景知識
- GLG、「Expert Calls」。···コンプライアンス手続きが何を検証し、何を検証していないかが確認できます
- Paul Lockhart、「A Mathematician’s Lament」、2002年。···25ページの原文です。音楽教育の悪夢から始まる最初の2ページを読むだけでも、今回の声明のルーツが見えてきます
- Guidepoint、「Guidepoint Accelerates Enterprise AI Transformation with Gemini Enterprise」、2026年8月26日。···書き起こしの規模がわずか5ヶ月でどれほど増えたかを比較できます

あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。