写不出一行文字的AI,却让开发者蜂拥而至
Jev为“判断”标出的价格,以及我为什么要做一个只会五种行为的模型
AI与科技一天之内就有13%的付费团队用上的模型,却写不出文字
读者,9月15日,美国初创公司TypeSafe AI结束了两年的秘密开发,公开了首款模型Jev。同时公布的还有DCVC领投的4000万美元种子轮融资。创始人Diogo Almeida(音译)曾是OpenAI的研究员,也是InstructGPT论文的共同作者之一——那正是让ChatGPT能够很好地遵循人类指令的方法论。
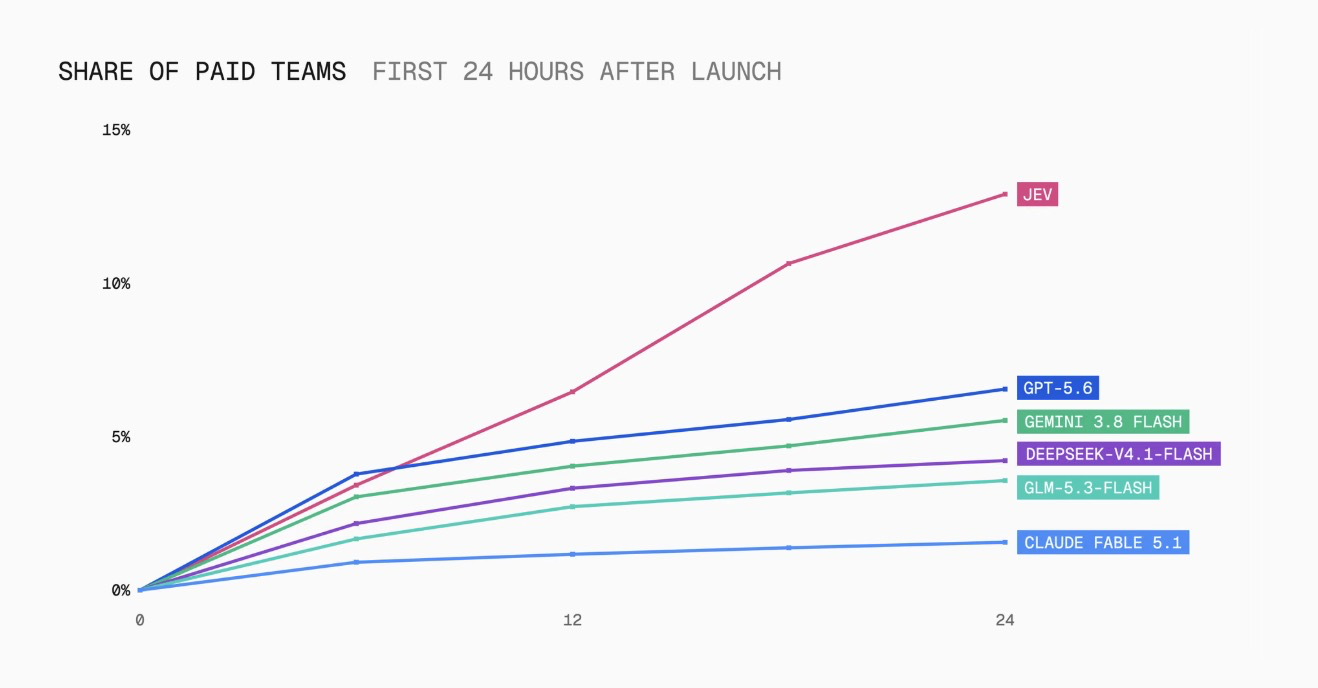
反应很快。Vercel宣布,自己在AI网关上线Jev仅24小时后,约13%的付费团队就用上了这个模型。按同一标准计算,这个数字是GPT-5.6系列的2倍,是Fable 5.1的6倍以上,据称是该网关历史上采用速度最快的模型。短短几天内,它也登上了Cloudflare和OpenRouter的模型列表。
我先是把这个故事写成了一篇ZDNet专栏。因为篇幅有限,省略了很多说明,今天就把这些都补上。包括Jev到底在做什么、该如何解读公司公布的这些数字,以及我正在进行的端侧项目KASI打算把同样的原理带到哪里去。
我一直有一句常说的话——**并不是所有事情都需要超级智能。**Jev就是把这句话变成一张价目表的案例。
Jev不写答案,只做选择
发送给Jev的东西只有两种。一种是状态(state),也就是客户咨询、发票数据、Agent执行记录之类需要做判断的文本。另一种是格式固定的问题。问题只有三种类型。
| 问题类型 | 询问的内容 | 返回的内容 |
|---|---|---|
| Noul | 该陈述是否为真 | 为真的概率(0~1) |
| Choice | 候选项中是哪一个(最多255个) | 所选候选项、各候选项的概率、置信度 |
| Score | 在预设等级中处于什么位置 | 分数、各等级的概率、置信度 |
Almeida(音译)本人在Hacker News上的解释最好理解。他说,Choice对应代码里的match语句,Score对应排序,Noul对应if语句。Noul是伯努利(Bernoulli)的缩写。也就是说,接收Jev答案的一方不是人,而是代码。
Turing Post Korea团队凭借提前获得的访问权限试跑出的例子,很好地展示了这套结构。情景是这样的:某用户报修了Wi-Fi故障,一周多都没收到回复,于是又问了一句“我的报修现在怎么样了?”。就这一条消息,同时抛出了四个问题。
- 优先级(Score):medium 83%
- 负责团队(Choice):IT帮助台 100%
- 是否提及截止日期(Noul):5%
- 应使用的工具(Choice,候选约200个):ticket-status 73%,wifi-troubleshoot 25%
最后这个答案很关键。只看字面用词的话,很容易选中Wi-Fi维修工具,但用户问的并不是怎么修,而是已经提交的报修处理到了什么阶段。Agent完成一项任务的过程中,这样的分叉会出现几十次。
还有一点值得留意。Jev并没有直接查询工单,它只是选择了要用哪种工具,真正的执行是由接收这个结果的软件来完成的。这种把“选择”与“执行”分开的做法,后面讲到KASI时还会再次出现。
之所以又快又便宜,是因为跳过了写作这一步
如果向普通的 LLM1 提问“这条咨询属于退款、配送还是技术支持”,过程会很漫长。模型要逐个生成 token2,写出句子或 JSON,然后软件再把这段文字重新解析一遍,从中提取出值。答案本来只有三选一,但为了得到那一个答案,却要走完整套写作流程。
如果答案的候选项已经预先确定,那就根本不需要写文字。只要读取模型给每个候选项打出的概率就够了。省去了生成这一步,速度自然快;而且输出不可能超出既定格式之外,也就不会出现解析错误。就算一次性发送多个问题,它们也会各自独立、同时进行计算,所以就算问题数量增加,响应时间也几乎不会变长。公开的价格是每 100 万输入 token 收费 0.042 美元,输出不计费。响应时间在 0.07 秒到 0.5 秒之间。
Typesafe 并未公开内部结构。目前只透露了新架构、并行采样器,以及一个名为“面向校准判断的强化学习(RLCD)”的名称,既没有权重也没有论文。不过原理本身并不是什么秘密。公开后不久,独立项目 OpenJev 就用同样的思路复现了这一行为:只读取公开模型为每个选项打出的 logit3,再做归一化处理。在一份共 102 行的评测子集上,参数量为 40 亿的 Qwen3.5 4B 一致率为 84.5%,同一子集下公开的 Jev 数值为 88.3%。而 6 亿参数的模型则只有 40.7%。文中附有说明:样本量较小,且浏览器版构建经过了量化4处理,数值可能因此有所出入。
Continuing translation of fragment 3/14 — this fragment consists entirely of HTML/CSS with no visible Korean text requiring translation, and no Hangul content to render.
Jev不写答案,而是选答案
我们把文字说明容易搞混的三件事做成了可以亲手体验的形式:为什么快、193倍是和谁比较得出的数字、置信度又是怎么算出来的。
用两种方式处理同一条咨询试试
选好咨询并执行后,两个模型会同时出发。时钟会按真实时间流逝。耐心等到最后,你就能亲身感受到差异。
两个时钟的到达时间(10.1秒、0.4秒)是Typesafe评测网站公布的四项任务平均值。左边是准确率相同的GPT-5.6 Terra的数值。画面上出现的概率和输出文本是为了说明结构而设计的虚拟示例,并不会真正调用API。置信度是本页面简单计算出的、表示分布向某一侧倾斜程度的数值。
换一个比较对象,倍数就会变
Jev的数值保持不变,只需选择分母。所有数字均取自Typesafe公开的评测表。
柱状图采用对数刻度,一格代表十倍。表中公布的Jev数值(0.4秒、0.0004美元)经过四舍五入,因此倍数为估算值,与官网上的193.6倍、444.6倍略有出入。准确率并非与人工标注的正确答案相符的比例,而是与GPT-6 Astra和Claude Fable 5.1的平均回答一致的比例。来源:evals.typesafe.ai,2026年9月20日查阅。
拖动基准线,划分出三条路径
一个点代表一次判断。越靠右,表示模型对这个判断越有信心。降低自动处理的标准,工作量会减少,但空心点(错误判断)也会进入自动处理区间。
18 个点及其正确与否,是用于说明的虚构数据。实际使用时,需要用自己业务的数据和人工标注的正确答案来绘制这张图,才能确定基准线。至于模型说“0.85”的那些判断是否真的有约 85% 的准确率,这样的校准曲线,Typesafe 目前还没有公开。
这里能读出两点。第一,Jev 展现出的效率,很大一部分来自将问题转化为封闭选项的设计,而这种设计在小型开源模型上也同样有效。第二,也不能就此断定 Jev 只是给小模型套了一层包装。有一位开发者从 MMLU-Pro 中抽取 1,000 道题目让 Jev 运行,得到了 83% 的成绩,而同样的问题在 Qwen 系列的两个开源模型上只有 60% 左右。这意味着在简单分类任务上差距较小,而在难题上差距会拉大。
在 Typesafe 的评测网站上,我更关注的是另一个数字。他们把同一项任务分别用一个整体式提示词来完成,以及拆分成多个窄问题、其余交给代码处理,对所有模型都做了这两种方式的对比。以四项任务的平均值来看,拆分方式无一例外地更准确、更便宜、也更快。就连 Claude Opus 5,用整体提示词是 64.8%,用拆分工作流则是 73.1%。这是无论用不用 Jev,都可以带走的结论。
193 倍是与谁相比得出的数字
TypeSafe 的官网上写着“快 193.6 倍,便宜 444.6 倍”。这个倍数得先确认分母是谁,再往下读。评测网站公布的四项任务平均值如下。
| 模型(工作流方式) | 准确率 | 单次成本 | 单次耗时 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4秒 |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9秒 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1秒 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1秒 |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3秒 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8秒 |
以准确率相同的 Terra 为基准计算,Jev 大约快 25 倍、便宜约 76 倍。若与成本最低的 Luna 相比,成本差距会缩小到约 8 倍左右。190 倍和 440 倍上下的数字,只有把表中最慢的 Sonnet 5 和最贵的 Opus 5 分别当作分母才能算出来。25 倍、76 倍本身就已经是相当大的差距了,却偏偏选了最有利的基准来放大倍数。公平地说一句,TypeSafe 在发布文中也自己写明,这个数字很可能是实际收益中偏上限的那一端。
关于准确率,还有一条更重要的线索。这次评测的“标准答案”并不是人工制作的。他们把 GPT-6 Astra 和 Claude Fable 5.1 的回答取平均,当作基准标签。所以 67.8% 与其说是正确率,不如说是与两个顶级模型意见一致的比例。
按业务类型看,差异也不小。在客户应答任务中,Jev 是 76.0%,最高分的 Sol 是 78.3%,相差 2.3 个百分点。在发票处理任务中,Jev 是 61.8%,Sol 是 79.1%,差距拉大到 17.3 个百分点。发票处理需要核对金额、日期、数量,而这恰恰是 Jev 文档中自己承认的薄弱环节。
“没有幻觉”这句话也该用同样的方式来理解。它的意思是输出不会脱离设定好的格式。 TypeSafe 自己也说明,0% 这个数值并非实测结果,而是结构上必然保证的值。符合格式的错误答案依然会出现。把技术咨询归类为“付款”,类型是对的,但意思是错的。
0.85 真的意味着 85% 吗
最大的未经验证项目是概率的质量。
TypeSafe 文档建议将置信度分成三个区间来使用。高的话自动处理,中等的话要求用户确认或标记为待审核对象,低的话不执行,转交给人或其他系统。看文档的示例代码就会发现,像余额查询这样的轻量任务会直接放行,而像提款批准这样的高风险操作,只有当置信度超过 0.9 时才会进入下一步。这是一种把“模型不知道”这一事实不弃之不用、而是当作分支条件来使用的设计。
这个设计只有在概率可信时才成立。把 Jev 回答为 0.85 的判断汇总起来,实际正确率应该也要在 85% 左右才对。TypeSafe 并未公开能够证明这一点的校准(calibration)5曲线,也还没有第三方用人工标注数据进行验证的结果。
有一份值得参考的独立使用报告。运营价格比较引擎的开发者 paddo,把连人工都不敢轻易去审核的 9,081 件低置信度商品匹配任务交给了 Jev。花费 32 美分,耗时 13 分钟。 Jev 驳回了 49%,确认了 21%,另有 30% 判断被搁置。需要人工查看的清单从 9,081 件缩减到了 2,686 件。他亲自抽查了 50 件,其中 48 件是合理的。同时他也写道,50 件样本不足以验证 0.85 是否真的意味着 85%,因此他只把这个判定记录在参考列,尚未挂载任何实际动作。我认为这种态度是对的。
文档所公开的弱点中,还有一个是打算处理概率的人一定要看的。有一个示例是,针对重复扣款投诉,若问“是否在要求退款”得到 0.72,若问“是否在要求退款以外的事项”得到 0.47。两者相加为 1.19。同一个问题反过来问出的两个概率并不能正好凑成 1。文档给出的建议是,不要期待这种算术关系成立,一项判断只用一种方式去问。
关于韩语,也要单独说明一下。有一个独立解读网站整理指出,Jev 的主要训练语言是英语。文档披露的第一个弱点就是照字面理解的习惯,而韩语工作场景中的句子往往充满委婉的拒绝和省略。在“我们会研究一下”这种说法本身就可能意味着拒绝的语言环境里,唯一的办法就是用自己的数据亲自重新验证一遍。
把同样的原理带进设备内部
从这里开始是我自己的故事。我在做一个叫 KASI(Kernel Action Schema Intelligence)的设备端 AI 项目。源代码以 Apache 2.0 许可证公开在 GitHub 上,对研究和个人用途免费,对企业和机构收费提供。
KASI 做的事情也只有一件。它接收韩语请求和 JSON 工具模式6,把它转换成五种结构化行为中的一种。
| 行为 | 含义 | 由谁决定 |
|---|---|---|
| call | 携带参数调用工具 | 模型提议,包装层验证 |
| clarify | 反问缺失的信息 | 模型或包装层 |
| confirm | 在执行危险工具前征求同意 | 仅由包装层 |
| refuse | 拒绝未知工具、模糊或危险的请求 | 模型或包装层 |
| respond | 把工具执行结果传达给用户 | 模型(仅在收到执行结果之后) |
表中的“包装层”是位于模型和设备之间的普通代码。它是可以被读懂、可以被测试的那一侧。
面对“把客厅灯调暗一点”这句话,模型没有理由用一句话来回答。它需要做的,是决定该调用哪个工具、用什么参数、要不要反问、要不要拒绝。这和 Jev 的出发点相同,都是把输出空间收窄。
信息不足与许可不足
设计过程中,我纠结最久的,是如何区分 clarify 和 confirm。“把烤箱打开”缺了温度这个信息。“把大门打开”参数全都齐了,但也不能就这么直接执行。前者是信息不足,后者是许可不足。从设备的角度看,两者需要的界面也不一样:信息不足需要重新输入数值,而征求同意只需要一个“是/否”按钮就够了。
所以 confirm 不是由模型来选择的。它是包装层把模型提出的调用建议同工具的风险等级对照之后决定的。风险等级信息在传给模型之前就已经从模式中剥离出去。模型可能会猜测“开门这种操作应该挺危险的”,但这种猜测不具备任何权限。同意记录是设备的状态,不是模型的口才。模型也不会直接执行工具,最终的执行权限留在主机应用程序那一侧。
我没有把“转交给更大的模型或人”设为第六种行为,原因和 Jev 的那部分内容是相连的。因为每一种行为都带有置信度,是否转交,主机看那个数字就能决定。这和 Jev 文档里那三个区间是同一种想法。当置信度没有达到该工具按风险等级划定的门槛时,包装层就会放弃这个提议,转成“请再说一次”的 clarify。设计上的默认值是:低风险 0.65、中风险 0.80、高风险 0.95。这道关口设在同意关口之前,因为不能拿着没有把握的提议去向用户征求同意。
这个模型的论文预计将在今年年底公开。
不同之处在于位置
Jev 只能通过 Typesafe 的云端 API 使用,权重不公开,也没有办法自行安装运营。它那 0.1 秒级的响应,也是建立在连着网络这个前提之上的。
在家电、工厂设备、车辆这类即便断开连接也必须运作、且难以把数据往外传输的环境里,判断必须在设备内部结束。KASI 的目标设备分三档:Arduino 级微控制器、Raspberry Pi 级单板计算机、以及小型 PC。目前的基准模型参数约为 4,500 万个,目标是把模型文件控制在 16MiB、运行内存控制在 32MiB 以内。KASI 想要确认的问题,是把选项进一步收窄、并针对韩语和工具调用做专门优化之后,模型究竟能缩小到什么程度。我的目标是把输出收窄成五种行为,从而在没有网络的小型设备上也能给出 0.1 秒级的响应。
在小型设备上,仅仅减少写作量还不够,所以我又加了两道机制。一道是语法约束解码。它从当下声明的工具模式中提取语法规则,让模型根本无法生成列表之外的工具名或超出范围的值。这和 Jev 所说的“没有类型错误”是同一种保证,因此局限也相同——形式是否正确和意义是否正确,要分开来衡量。另一道是输入规范化。用韩语输入法打字时,常会混入像“22度”这样的全角数字,这会被折算成 22 加以统一。反过来,对于必须原样传递用户输入字符的字符串参数,会被还原回原始字节。除了韩语,也接受英语、中文、日语。
尚未能展示的部分
局限也要如实说明。目前公开的仓库里没有模型权重,仓库中也已经写明,因此不对质量或资源性能做出任何主张。公开基准评测、以及在真实设备上的速度与内存测量,都还没有完成。用此前的检查点在开发用的 Mac 上、只取出模型核心部分重新测量的内存,在声明五个工具时约为 33.4MiB 上下,已经超过了 32MiB 的目标值。
关于置信度,我要更坦诚地说明。这是尚未校准过的数字。在两次开发阶段的抓取记录中,共 191 条被完整生成的响应里,一次是 179 条、另一次是全部 191 条都打出了 1 分。前面我曾要求 Jev 拿出校准曲线,同样的作业也原样摆在我自己的桌上。所以我把 0.65、0.80、0.95 称为设计默认值,而不是运营值。目前能告诉大家的,只到设计方向这一步。
Oswarld视角
我在Jev身上关注的,与其说是模型本身,不如说是这个模型所预设的工作划分。目前企业通过LLM API处理的调用中,混杂着两种性质不同的工作。一种是像撰写报告、生成代码、总结摘要那样答案开放的工作;另一种是像询问分类、代理下一步路径选择、付款审批与暂停、是否转交人工处理那样答案候选已经确定的工作。后者本不需要写作能力,却一直被交给同一个模型、按同样的单价处理。代理越多,后一种调用就越多。因为代理为了写一次文字,要做数十次判断。Jev的定价表明,这种判断的价格有可能比现在低两位数的倍数。
Jev这个名字来自经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。就是那个蒸汽机效率提高后,煤炭消耗反而增加的悖论。这个名字里蕴含着这样的期待:判断的价格一旦变便宜,AI就会进入到那些现在人们甚至想都不会想去调用AI的微小决策之中。paddo的案例正是如此。他在6月就设计好了那个审核环节,却先把它搁置了,说要先测算一下成本。结果算下来9,000件只需32美分,于是这就变成了值得每晚运行的事。正如他所说,价格改变的不是准确度,而是设计。
结语
在决定要不要引入 Jev 之前,还有一件事值得先做。数一数在自家的 LLM 调用记录中,答案候选项已经确定的调用占多少比例。这个比例就是可以节省成本的上限。接下来要做的是,为那项业务哪怕收集数百条经过人工标注的数据也好。不仅是准确率,还要用自己的数据核实模型所说的概率与实际命中率是否一致,只有这样才能定出自动处理的基准线。如果是韩语业务,更是如此。
对于实际生产设备的公司来说,还有一个问题:这个判断是否可以放在云端进行。只要在连接、延迟、数据外流当中任何一项上卡住,把带有封闭行动空间的小型模型装进设备里,就成了值得考虑的方案。
Jev 用价格证明了一件事:判断可以成为与写作分离的独立产品。至于这个判断该在哪里执行、经过谁的验证来执行,则要各自根据自己的业务数据来决定。
💬 你现在使用的 LLM 调用中,有哪些是“其实只需要在选项里挑一个”的工作?欢迎在评论区留下你想到的业务。
📨 如果身边有同事正在为智能体成本或端侧 AI 苦恼,请把这篇文章分享给他们。


参考资料与延伸阅读
核心来源
- Diogo Almeida,“Introducing System One Models & Jev”,TypeSafe AI,2026.9.15。……这是发布公告。每条主张下面都有一项名为“Nuance”的说明,是公司自己写的免责条款,可以一并参考。
- TypeSafe AI,“Workflow evals”。……这是正文表格的原始出处。按具体任务逐一查看,能看出不同模型之间的差异有多大。
- TypeSafe AI 文档,“Introduction”“Confidence”“Jev 1.13 jaggedness”。……这里有三种问题类型、三档确信度区间,以及公司自己公开的弱点清单。如果正在考虑引入该模型,建议先读弱点文档。
- Vercel,“Jev is the fastest-adopted model in AI Gateway history”,2026.9。……这是24小时内付费团队采用率的出处。
- paddo,“The Thirty-Cent Judge”,2026.9.19。……这是9,081 件使用案例。作者本人对哪些地方尚未得到验证写得最为细致。
延伸阅读
- “You could have built Jev”,sgnt.ai。……整理了多个基于读取logit方式的复现项目,以及与MMLU-Pro的比较。
- 安光涉,“[安光涉的AI辩证法] 写不好文章的AI为何走红,Jev给“判断”标出的价格”,ZDNet Korea,2026.9.20。……这是本文的浓缩版。
📝 术语说明
각주
-
LLM(大规模语言模型):通过学习海量文本,以预测下一个词的方式生成文字的模型。ChatGPT、Claude等服务都以此为基础。 ↩
-
Token(词元):模型读写文字的最小单位。可以理解为比单词更细碎的片段。API计费也按这个单位计算。 ↩
-
logit(逻辑值):模型在转换为概率之前,为每个候选项打出的原始分数。将这些分数归一化后,就得到各候选项的概率。 ↩
-
量化:将模型中的数值压缩成更少比特来存储的方式。这样能换来容量和速度的提升,但精度可能会有所变化。 ↩
-
校准(calibration):指模型所说的概率与实际命中率之间的吻合程度。如果把所有预报“降雨概率70%”的日子放在一起统计,实际下雨的天数应该占到十分之七左右,这样才算校准良好的预报。 ↩
-
JSON工具模式(schema):以机器可读的方式记录工具名称、接受的参数以及允许取值范围的说明书。模型正是依据这份说明书来决定调用哪个工具、如何调用。 ↩