文章が一行も書けないAIに開発者が押し寄せた
Jevが付けた「判断」の価格、そして私が五つの行動しかしないモデルを作る理由
AI・テック1日で有料チームの13%が使ったモデルは文章が書けない
読者さん、去る9月15日、米国のスタートアップTypeSafe AIが2年間の非公開開発を終え、初のモデルJevを公開しました。DCVCが主導した4,000万ドルのシード投資の発表も同時でした。創業者のディオゴ・アルメイダはOpenAIの研究者出身で、InstructGPT論文に共同著者として名を連ねた人物です。ChatGPTが人の指示によく従うようにした、まさにその方法論の側の人ですね。
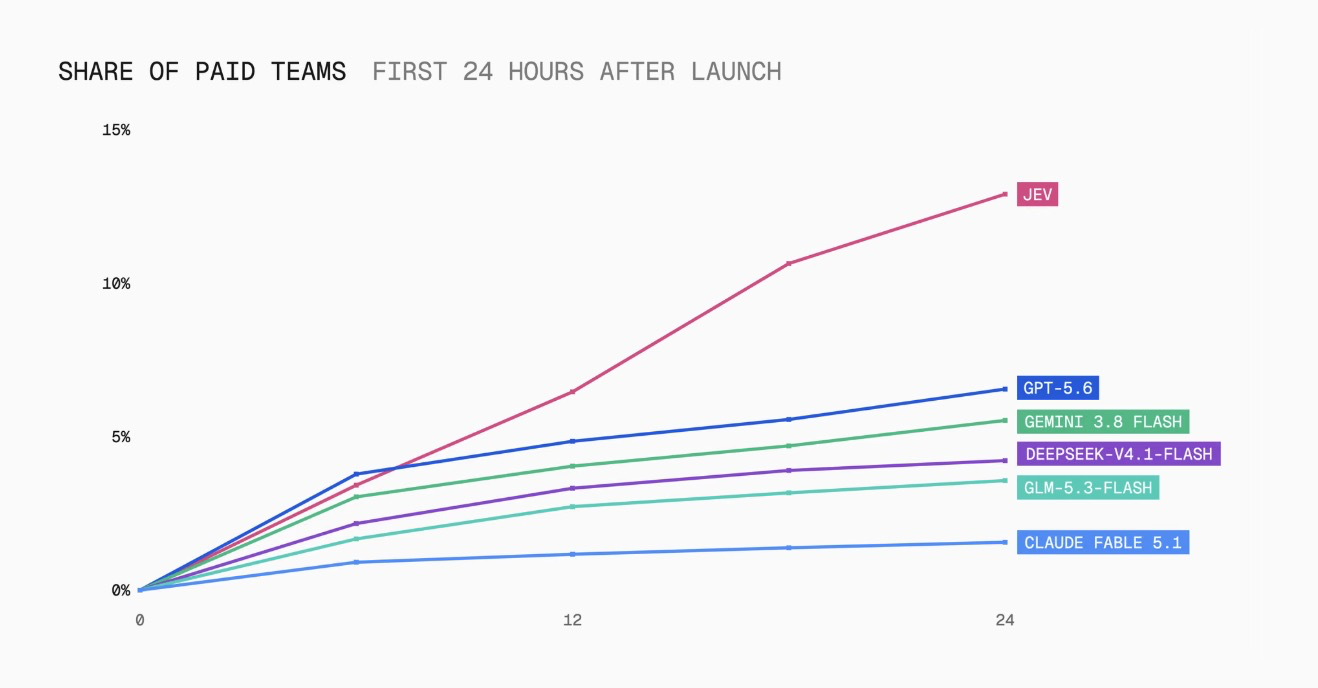
反応は早かったです。Vercelは自社のAIゲートウェイにJevを追加してから24時間で、有料チームの約13%がこのモデルを使ったと発表しました。同じ基準でGPT-5.6シリーズの2倍、Fable 5.1の6倍を超え、ゲートウェイ史上最も早く採用されたモデルだそうです。CloudflareとOpenRouterのモデル一覧にも数日のうちに登録されました。
この話は、まずZDNetのコラムで書きました。紙幅が短くて省いた説明が多かったのですが、今日はそれをすべて解きほぐしてみます。Jevが正確に何をするのか、会社が掲げた数字をどう読むべきか、そして私が進めているオンデバイスプロジェクトKASIが同じ原理をどこへ持っていこうとしているのかまで、お話しします。
私がいつも言っていることが一つあります。**すべての仕事に超知能が必要なわけではありません。**Jevはその言葉を価格表として示した事例です。
Jevは答えを書かず、選ぶ
Jevに送るものは二つです。一つは状態(state)です。顧客からの問い合わせ、請求書データ、エージェントの実行記録のように、判断の対象となるテキストです。もう一つは形式が定められた質問です。質問はわずか三種類しかありません。
| 質問タイプ | 問うこと | 返すもの |
|---|---|---|
| Noul | この陳述は真か | 真である確率(0~1) |
| Choice | 候補のうちどれか(最大255個) | 選んだ候補、候補ごとの確率、確信度 |
| Score | 定めた等級のどこに位置するか | 点数、等級ごとの確率、確信度 |
アルメイダがHacker Newsで直接した説明が一番わかりやすいです。Choiceはコードのmatch文、Scoreはソート、Noulはif文に対応するという説明です。Noulはベルヌーイ(Bernoulli)を短くした名前です。つまり、Jevの答えを受け取る側は人間ではなくコードなのです。
チューリングポスト・コリアのチームが事前アクセス権を得て試した例が、この構造をよく示しています。Wi-Fiの故障を報告した後、1週間以上回答が来なかった利用者が「私の報告はどうなっていますか」と再び問い合わせた状況です。このメッセージ一つに対して、質問を四つ同時に投げかけました。
- 優先度(Score):medium 83%
- 担当チーム(Choice):ITヘルプデスク 100%
- 期限の言及有無(Noul):5%
- 使うべきツール(Choice、候補約200個):ticket-status 73%、wifi-troubleshoot 25%
最後の答えが重要です。言葉だけを見るとWi-Fi修理ツールを選びやすいのですが、利用者が聞いているのは修理方法ではなく、すでに出した報告の処理状況だからです。エージェントが一つの仕事を終えるまでに、こうした分岐点が数十回も現れます。
もう一つ見ておくべき点があります。Jevはチケットを直接照会したわけではありません。どのツールを使うかを選んだだけで、実行はその値を受け取ったソフトウェアが行います。選ぶ側と実行する側を分けるこの区分は、後でKASIを説明する際に再び出てきます。
速くて安い理由は文章生成を省いているからです
一般的なLLM1に「この問い合わせは返金、配送、技術サポートのどれに該当しますか」と尋ねると、プロセスが長くなります。モデルはトークン2を一つずつ生成して文章やJSONを書き、ソフトウェアはその文章を改めて解釈して値を取り出します。答えは3つのうちのどれかなのに、その一つを得るために文章生成の過程全体を経由するわけです。
答えの候補があらかじめ決まっているなら、文章を書く必要はありません。モデルが各候補に割り当てた確率だけを読めばよいのです。生成段階を飛ばすので速く、出力が決まった形式の外に出ることがないので解釈エラーも生じません。質問を複数まとめて送っても、それぞれ別々に、同時に計算されるので、質問を増やしても応答時間はほとんど変わりません。公開されている価格は入力100万トークンあたり0.042ドルで、出力は無課金です。応答は0.07秒から0.5秒の間です。
TypeSafeは内部構造を公開していません。新アーキテクチャ、並列サンプラー、「較正済み判断のための強化学習(RLCD)」という名称だけが示され、重みも論文もありません。ただし原理自体は秘密ではありません。公開直後に登場した独立プロジェクトOpenJevは、公開モデルが選択肢ごとに割り当てたロジット3だけを読んで正規化する方式で、同じ挙動を再現しました。102行の評価サブセットにおいて、パラメータ40億個のQwen3.5 4Bの一致率は84.5%、同じサブセットで公開されているJevの値は88.3%です。6億個のモデルは40.7%にとどまりました。サンプル数が少なく、ブラウザ向けビルドは量子化4されているため数値が変わりうるという注記が付いています。
This fragment contains only CSS/HTML code with no translatable Korean text, and is already identical to the source. No changes needed.
Jevは答えを書かずに選びます
文章で読むと分かりにくい3つのことを、実際に触って確かめられるようにしました。なぜ速いのか、193倍とは誰と比較した数字なのか、確信度をどう使うのかということです。
同じ問い合わせを二つの方式で処理してみましょう
問い合わせを選んで実行すると、二つのモデルが同時にスタートします。時計は実際の時間のとおりに進みます。最後まで待ってみると、その差を体感できます。
二つの時計の到着時間(10.1秒、0.4秒)は、タイプセーフの評価サイトが公開した4つの業務の平均値です。左側は、精度が同じだったGPT-5.6 Terraの値です。画面に表示される確率と出力文は、構造を説明するために作った仮想の例であり、実際にAPIを呼び出してはいません。確信度は、分布がどちらかに偏った度合いを、このページで単純計算した値です。
比較対象を変えると倍数が変わります
Jevの値はそのままにして、分母だけを選んでみましょう。数値はすべて、タイプセーフが公開した評価表から取得しています。
バーは対数目盛りです。1マスが10倍です。表に公開されているJevの値(0.4秒、0.0004ドル)が四捨五入されているため、倍数は概算値であり、ホームページの193.6倍、444.6倍とは少し異なります。精度は、人間が作った正解と一致した割合ではなく、GPT-6 AstraとClaude Fable 5.1の平均応答と一致した割合です。出典:evals.typesafe.ai、2026年9月20日確認。
しきい値を動かして三つの経路に分けてみましょう
点一つが一件の判断です。右にあるほど、モデルが確信している判断です。自動処理の基準を下げると仕事は減りますが、中が空いた点(誤った判断)が自動処理の区間に入ってきます。
点18個と正誤の判定は説明用の仮想データです。実際にはこの図を自分の業務データと人がつけた正解ラベルで描いてみて初めて、しきい値を決めることができます。モデルが0.85と言った判断が本当に85%くらい合っているかを示す較正曲線を、Typesafeはまだ公開していません。
ここから読み取れることは2つあります。1つ、Jevが見せた効率のかなりの部分は問題を閉じた選択肢に変える設計から来ていて、その設計は小さな公開モデルでも機能します。2つ、だからといってJevが小さなモデルに包装だけ施したものだと断定することもできません。あるデベロッパーがMMLU-Proの問題1,000問を抽出してJevで回してみたところ83%が出て、同じ問題でQwen系の公開モデル2つは60%前後だったそうです。簡単な分類では差が小さく、難しい問題では広がるという意味です。
タイプセーフの評価サイトで私がもっと注目した数字は別にあります。同じ業務を1本の丸ごとプロンプトでやらせた場合と、狭い質問複数に分けて残りをコードに任せた場合を、すべてのモデルについて比較したところ、4つの業務の平均では、分割した方が例外なくより正確で、より安く、より速かったのです。Claude Opus 5もプロンプトでは64.8%、分割したワークフローでは73.1%です。Jevを使うにせよ使わないにせよ、持ち帰れる結果です。
193倍とは誰と比較した数字なのか
TypeSafeのホームページには「193.6倍速く、444.6倍安い」と書かれています。この倍数は分母が誰なのかを確認してから読むべきです。評価サイトが公開した4つの業務の平均値を転載すると次のようになります。
| モデル(ワークフロー方式) | 精度 | 件当たりコスト | 件当たり時間 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4秒 |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9秒 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1秒 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1秒 |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3秒 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8秒 |
精度が同じTerraを基準に計算すると、Jevは約25倍速く、約76倍安くなります。最も安い部類のLunaと比べるとコスト差は8倍程度まで縮まります。190倍や440倍前後という数字は、表の中で最も遅いSonnet 5と最も高価なOpus 5をそれぞれ分母にしないと出てきません。25倍、76倍だけでも十分に大きな差なのに、最も有利な基準を選んで倍数を膨らませたわけです。公平を期して付け加えると、TypeSafe自身も発表文の中で、この数字は実際の利得の上限側だろうと明記しています。
精度についてはもっと重要な手がかりがあります。この評価の正解データは人間が作ったものではありません。GPT-6 AstraとClaude Fable 5.1の応答を平均して基準ラベルとしています。つまり67.8%は正答率というより、最上位モデル2つと意見が一致した割合なのです。
業務別のばらつきも大きいです。カスタマー対応ではJevが76.0%、最高点のSolが78.3%で、差は2.3ポイントです。請求書処理ではJevが61.8%、Solが79.1%で、差は17.3ポイントに広がります。請求書は金額と日付と数量を突き合わせる必要がある業務で、それはJevの文書自身が弱点として認めている領域です。
「ハルシネーションがない」という文言も同じように読めばいいでしょう。出力が定められた形式を外れないという意味です。 TypeSafeも0%という数値は実測ではなく構造上保証される値だと明らかにしています。形式に合った誤答は出てきます。技術的な問い合わせを「決済」に分類すれば、タイプは合っていても意味は間違っているわけです。
0.85は本当に85%なのか
最大の未検証項目は、確率の品質です。
TypeSafeの文書は、確信度を三段階に分けて使うよう勧めています。高ければ自動処理し、中程度ならユーザー確認を受けるか検討対象として表示し、低ければ実行せずに人間や他システムに引き渡すというものです。文書のサンプルコードを見ると、残高照会のような軽い作業はそのまま進め、出金承認のような高リスク作業は確信度が0.9を超えたときだけ次の段階に進みます。モデルが「わからない」という事実を捨てずに、分岐条件として使う設計です。
この設計は、確率が信頼できる場合にのみ成り立ちます。Jevが0.85と答えた判断を集めたとき、実際に85%くらい正解している必要があります。それを示すキャリブレーション(較正)5曲線をTypeSafeは公開しておらず、人間がラベル付けしたデータで第三者が検証した結果もまだありません。
参考になる独立した使用レポートが一つあります。価格比較エンジンを運営する開発者paddoは、人間が検討する気になれなかった低信頼度の商品マッチング9,081件をJevに任せました。かかったのは32セント、13分でした。Jevは49%を却下、21%を確定させ、30%は判断を保留しました。人間が見るべきリストは9,081件から2,686件に減ったことになります。彼が50件を自分で読んでみたところ、48件は妥当でした。同時に彼は、50件では0.85が85%を意味するかどうかは検証できないと書いており、そのためこの判定は参考用の列に記録するだけにとどめ、まだ何の動作にも結びつけていないとのことです。私は、この姿勢は正しいと思います。
文書が公開した弱点のうち、確率を扱う人が必ず見ておくべきものがもう一つあります。重複決済に関する問い合わせに対して「返金を要求しているか」と問うと0.72、「返金以外の何かを要求しているか」と問うと0.47という結果が出た例です。二つを足すと1.19になります。同じ質問を裏返して聞いた二つの確率が、1にきちんと収まりません。文書の勧告は、こうした算術的な関係を期待せず、一つの判断は一つの聞き方だけで問うべきだというものです。
韓国語についても触れておきます。ある独立系の解説サイトは、Jevの主な学習言語は英語だとまとめています。文書が明かした最初の弱点は、額面通りに読んでしまう癖ですが、韓国語の業務文には婉曲な断りや省略が多く見られます。「検討してみます」が断りを意味しうる言語では、自分のデータで直接検証してみるしかありません。
同じ原理を機器の内側に持ち込むと
ここからは私の話です。私はKASI(Kernel Action Schema Intelligence)というオンデバイスAIプロジェクトを進めています。ソースコードはGitHubにApache 2.0ライセンスで公開しており、研究と個人目的には無料で、企業と機関には有料で提供しています。
KASIがやることも一つです。韓国語のリクエストとJSONツールスキーマ6を受け取って、五つの構造化された行動のいずれかに変換します。
| 行動 | 意味 | 誰が決めるか |
|---|---|---|
| call | ツールを引数とともに呼び出す | モデルが提案し、ラッパーが検証 |
| clarify | 不足している情報を聞き返す | モデルまたはラッパー |
| confirm | 危険なツール実行前に同意を求める | ラッパーのみ |
| refuse | 未知のツール、曖昧または危険な要求を拒否 | モデルまたはラッパー |
| respond | ツール実行結果をユーザーに伝える | モデル(実行結果を受け取った後のみ) |
表にあるラッパーは、モデルと機器の間に置かれる普通のコードです。読めてテストできる側です。
「リビングの電気を少し落として」という言葉に、モデルが文章で答える理由はありません。必要なのは、どのツールをどんな引数で呼ぶか、聞き返すか、拒否するかという決定です。Jevと出発点は同じです。出力空間を閉じることです。
情報が足りないことと許可が足りないこと
設計しながら私が一番長く悩んだのは、clarifyとconfirmを分けることでした。「オーブンをつけて」には温度が抜けています。「玄関のドアを開けて」は引数がすべて揃っていても、そのまま実行してはいけません。前者は情報が足りないことで、後者は許可が足りないことです。機器側から見ると、必要な画面も違います。情報は値を改めて入力してもらう必要がありますが、同意は「はい・いいえ」のボタン一つで済みます。
そのため、confirmはモデルが選びません。モデルが出した呼び出し提案とツールの危険度レベルを照らし合わせて、ラッパーが決めます。危険度レベルの情報は、モデルに渡す前にスキーマから切り離します。モデルが「ドアを開けるのは危険だろう」と推測することはあり得ますが、その推測には何の権限もありません。同意の記録は機器の状態であって、モデルの話術ではないからです。モデルはツールを直接実行することもありません。最終的な実行権限はホストアプリケーション側に残ります。
「より大きなモデルや人間に引き渡す」を六つ目の行動として入れなかった理由は、Jevの話とつながっています。すべての行動に確信度が付くので、引き渡すかどうかはホストがその数字を見て決めればよいのです。Jevの文書にあった三つの区間と同じ考え方です。ラッパーは、確信度がツールの危険度レベル別の基準に満たない場合、提案を捨てて「もう一度おっしゃってください」というclarifyに切り替えます。設計上のデフォルト値は、危険度低で0.65、中で0.80、高で0.95です。この関門は同意の関門より前にあります。確信のない提案を持ってユーザーに同意を求めるわけにはいかないからです。
このモデルの論文は今年末に公開される予定です。
違う点は位置です
Jevはタイプセーフのクラウド APIでしか使えず、重みは非公開で、自分で設置して運用する方法がありません。0.1秒台の応答も、ネットワークがつながっている場合の話です。
家電、工場設備、車両のように、接続が切れても動作しなければならず、データを外に送りにくい環境では、判断が機器の内側で完結する必要があります。KASIが目標とする機器は、Arduino級のマイクロコントローラー、Raspberry Pi級のシングルボードコンピューター、小型PCの三段階です。現在の基準モデルはパラメーター約4,500万個で、モデルファイル16MiB、実行メモリ32MiB以内に収めることを目標にしています。選択肢をさらに絞り込み、韓国語とツール呼び出しに特化すれば、モデルをどこまで縮小できるかというのが、KASIが確かめようとしている問いです。私の目標は、出力を五つの行動に閉じることで、ネットワークのない小型機器でも0.1秒台の応答を出すことです。
小型機器では、文章を書くことを減らすだけでは不十分なので、仕掛けをさらに二つ設けました。一つは文法制約デコーディングです。その瞬間に宣言されたツールスキーマから文法を抜き出し、モデルがリストにないツール名や範囲外の値をそもそも生成できないようにします。Jevの「型エラーがない」と同種の保証であり、だからこそ限界も同じです。形式が合っていることと意味が合っていることは、別々に測る必要があります。もう一つは入力の正規化です。韓国語の入力方式(IME)で打っていると、「22度」のように全角数字が混じって入ってくることがありますが、これを22に畳んで揃えます。逆に、ユーザーが打った文字をそのまま渡す必要がある文字列引数は、元のバイトに戻します。韓国語のほかに英語、中国語、日本語も受け付けます。
まだお見せできていないもの
限界も明らかにしておきます。現在公開しているリポジトリにはモデルの重みがなく、リポジトリにはそのため品質や資源性能を主張しないと明記してあります。公開ベンチマーク評価と、実機での速度・メモリ計測は残された課題です。以前のチェックポイントを開発用Macでモデルコアだけ取り出して再計測したメモリは、ツール五つを宣言した状態で33.4MiB前後で、目標値の32MiBをすでに超えています。
確信度についてはもっと率直に申し上げなければなりません。まだ較正していない数字です。二回の開発キャプチャで最後まで生成された応答191件のうち、一回は179件、もう一回は191件全部に1が付きました。先ほどJevに較正曲線を出すよう求めましたが、同じ宿題が私の机の上にもそのまま残っているわけです。そのため、0.65、0.80、0.95を運用値ではなく設計上のデフォルト値と呼んでいます。今申し上げられるのは、設計の方向性までです。
Oswarldの視点
Jevで私が注目しているのは、モデルそのものよりも、そのモデルが前提とする業務の分け方です。今、企業がLLM APIで処理している呼び出しには、性質の異なる二種類の仕事が混ざっています。レポート作成、コード生成、要約のように答えが開かれている仕事と、問い合わせの分類、エージェントの次の経路選択、決済の承認と保留、人に引き継ぐかどうかのように答えの候補が決まっている仕事です。後者は文章を書く必要がないのに、同じモデルに同じ単価で任されてきました。エージェントが増えるほど後者の呼び出しは増えます。エージェントは文章を一回書くために何十回も判断するからです。Jevの価格は、その判断の値が今よりも二桁単位で下がりうることを示しています。
Jevという名前は経済学者ウィリアム・スタンリー・ジェヴォンズに由来します。蒸気機関の効率が良くなると石炭消費がむしろ増えたという、あの逆説です。判断の値段が安くなれば、今はAIを呼ぶことすら考えないような小さな意思決定にまでAIが入り込むだろうという期待が、この名前には込められています。paddoの事例がまさにそうです。彼は6月にその検討段階を設計しておきながら、まずコストを測ってみようと後回しにしていました。9,000件で32セントになるなら、毎晩回すに値する仕事になったわけです。彼の言う通り、価格が変えたのは精度ではなく設計です。
おわりに
Jevを導入するかどうかより先にやるべきことがあります。自社のLLM呼び出し履歴の中で、答えの候補があらかじめ決まっている呼び出しが何パーセントを占めるかを数えてみることです。その比率が削減できるコストの上限になります。次にやるべきは、その業務について人がラベリングしたデータを、数百件でもいいので確保することです。精度だけでなく、モデルが述べた確率と実際の的中率が一致しているかを自社データで確認して初めて、自動処理の基準線を定めることができます。韓国語の業務であればなおさらです。
実機を作る会社にはもう一つ問いがあります。その判断はクラウド上で行われてもよいのか、という問いです。接続性、遅延、データの持ち出しのいずれかに問題があるなら、閉じた行動空間を持つ小型モデルを機器に組み込む方向が検討対象になります。
Jevは、判断が文章生成とは切り離された別個の商品になり得ることを、価格という形で示しました。その判断をどこで、誰の検証を経て実行するかは、それぞれが自社の業務データをもとに決めることです。
💬 今お使いのLLM呼び出しの中で「実は選ぶだけでいい仕事」にはどんなものがありますか。思い浮かんだ業務をコメント欄に残してください。
📨 エージェントのコストやオンデバイスAIについて悩んでいる同僚がいたら、この記事をシェアしてください。


参考資料と関連リンク
主要出典
- Diogo Almeida, “Introducing System One Models & Jev”, TypeSafe AI, 2026.9.15. ……発表文です。各主張の下にある「Nuance」の項目に、会社自身が書き添えた留保があるので合わせて見てください。
- TypeSafe AI, “Workflow evals”. ……本文表の元データです。業務別に見ていくと、モデルごとのばらつきの大きさが分かります。
- TypeSafe AI 文書、「Introduction」「Confidence」「Jev 1.13 jaggedness」。……3種類の質問タイプ、確信度の3区分、会社が公開した弱点リストです。導入を検討しているなら、弱点文書から先に読むことをおすすめします。
- Vercel, “Jev is the fastest-adopted model in AI Gateway history”, 2026.9. ……24時間以内の有料チーム採用率の出典です。
- paddo, “The Thirty-Cent Judge”, 2026.9.19. ……9,081件の使用記です。何が検証されていないのかを本人が一番几帳面に書き残しています。
関連リンク
- “You could have built Jev”, sgnt.ai. ……ロジット読み取り方式の再現プロジェクトと、MMLU-Proとの比較がまとめられています。
- アン・グァンソプ(安光涉), 「[アン・グァンソプのAIジンテーゼ] 文章が書けないAIが熱い理由、Jevが付けた『判断』の値段」, ZDNet Korea, 2026.9.20. ……この記事の圧縮版です。
📝 用語解説
각주
-
LLM(大規模言語モデル):膨大なテキストで学習し、次に来る言葉を予測する方式で文章を生成するモデルです。ChatGPT、Claudeといったサービスの基盤です。 ↩
-
トークン:モデルが文章を読み書きする際の最小単位です。単語より少し細かく刻んだ断片だと考えてください。APIの料金もこの単位で計算されます。 ↩
-
ロジット(logit):モデルが確率に変換する直前に、各候補に付ける生のスコアです。このスコアを正規化すると、候補ごとの確率になります。 ↩
-
量子化:モデルの数値をより少ないビット数に縮めて格納する圧縮方式です。容量と速度を得られる一方で、精度が多少変わることがあります。 ↩
-
キャリブレーション(calibration):モデルが述べた確率と実際の的中率がどれだけ一致しているかを指す言葉です。降水確率70%と予報した日を集めたとき、実際に10日中7日雨が降っていれば、よくキャリブレーションされた予報だと言えます。 ↩
-
JSONツールスキーマ:ツールの名前、受け取る引数、許容される値の範囲を、機械が読み取れる形式で記した仕様書です。モデルはこの仕様書を見て、どのツールをどう呼び出すかを決めます。 ↩
あわせて読みたい過去の号
シャオミ1.22TB/sとアップル1.2TB/s、範囲が違います
シャオミの1.22TB/sはO100チップの近接メモリ帯域幅、アップルの1.2TB/sは512GB統合メモリ全体にかかる帯域幅です
AI・テックノートPCが考え込むばかりで止まってしまいました
Qwen 3.8 27BをノートPCで実行して返答を得られなかった体験を取り上げました。高い推論デフォルト値と実行ツールのコンテキスト上限が、結果にどのような影響を与えるのかを検証します。
AI・テックAI半導体のボトルネックが演算からメモリへと移行しました
Nvidiaによる15%のサーバー値上げとメモリ階層の分化、韓国製NPUの商機について整理しました。
AI・テック