

シャオミ1.22TB/sとアップル1.2TB/s、範囲が違います
シャオミの1.22TB/sはO100チップの近接メモリ帯域幅、アップルの1.2TB/sは512GB統合メモリ全体にかかる帯域幅です
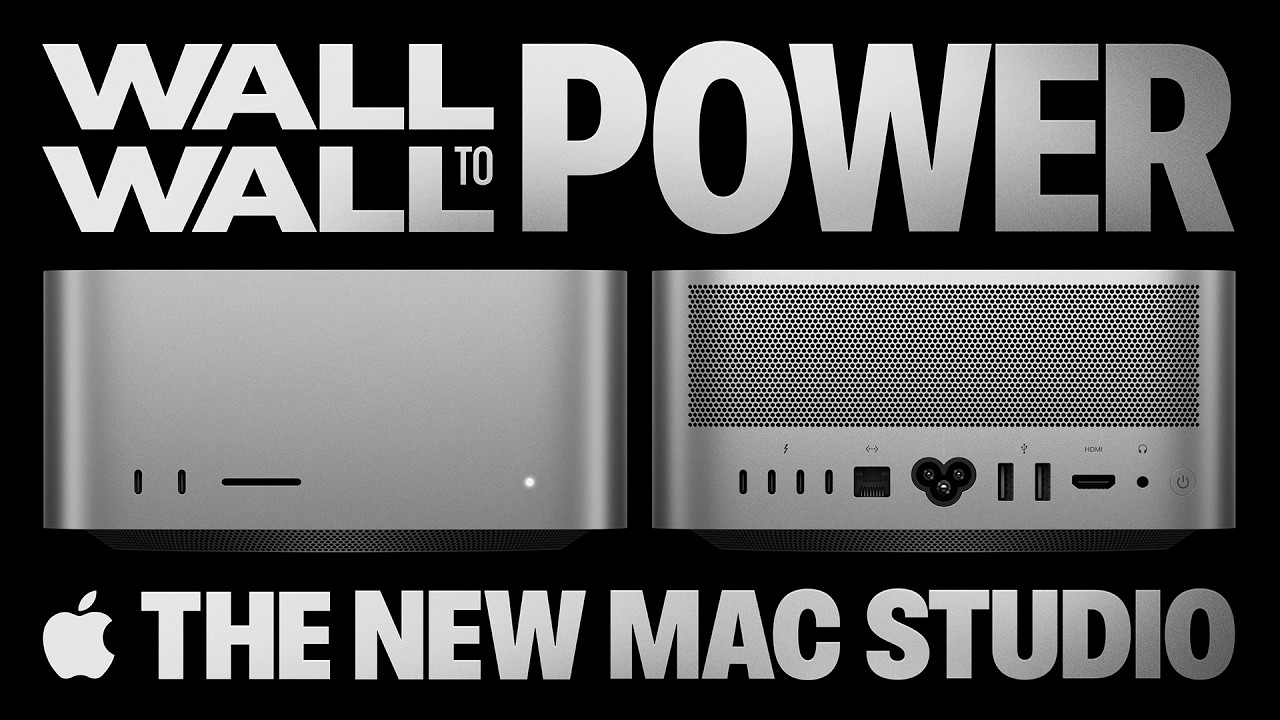
AI・テック同じ週に出たシャオミのAIキューブと新型Mac Studio
8月24日、シャオミが玄戒(シュエンジエ)チップの技術説明会で自社開発チップ3種と、それらをまとめた「AIキューブ」ミニPCのプロトタイプを公開しました。それから数日も経たないうちに、アップルがM5 MaxとM5 Ultraを搭載した新型Mac Studio、M6とM5 Proを搭載した新型Mac miniを発表しました。予約注文は8月27日、出荷は9月22日です。
同じ週に、机の上に置くAIボックスが2種類登場したことになります。しかも両者の発表には、ほぼ同じ数字が出てきました。シャオミは1.22TB/s、アップルは1.2TB/sです。
ただし、この2つの数字は適用範囲が違います。そして両社にはもう一つ、より重要な共通点があります。どちらもチップ設計だけを自社で行い、製造とメモリは外部から調達しているのです。 その調達リストには、韓国のメモリ企業も入っています。
両製品の発表スペック整理
まず発表内容を正確に整理してみます。数字が絡み合っていて誤解しやすい部分があるからです。
Xiaomi 玄戒 O3はフラッグシップスマートフォン向けSoCです。3ナノプロセスにトランジスタ240億個、ダイ面積133mm²。10コアCPUが最大4.35GHzで動作し、GPUは16コア、NPUは200TOPSです。目を引くのは業界初のLPDDR61対応という点です。速度10,667Mbps、帯域幅113.8GB/sで、LPDDR5X 9600比48%広くなりました。
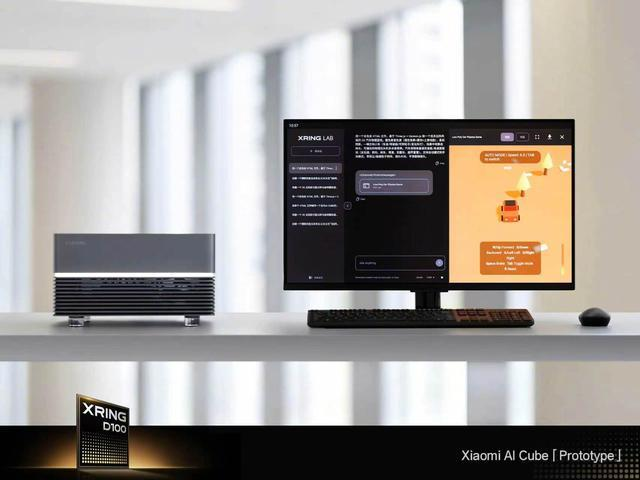
玄戒 O100は大規模モデル加速用チップです。6ナノプロセスに3Dウェハーレベル積層パッケージングを採用し、有効データライン28,672本で近接メモリ演算2 帯域幅最大1.22TB/sを出すとしています。
玄戒 D100はスマートドライビング向けチップです。3ナノに20コアCPUと16コアNPU、最大160GBメモリ対応。量産は2027年とされています。
AIキューブはこの3つをまとめた箱です。150W持続性能、最大160GB統合メモリ、3Bから120Bまでローカル駆動。航空宇宙級アルミに33,874個のCNC穿孔を施した、あからさまに見せるための外観です。価格も発売日もありません。エンジニアリングプロトタイプです。
1.22TB/sと1.2TB/s、どの範囲にかかる数字か
シャオミの1.22TB/sと160GBは、つなげて読んではいけない数値です。
1.22TB/sはO100の近接メモリ帯域幅で、160GBはD100が対応するメモリ容量です。互いに異なるチップの、異なる数値です。「160GBを1.22TB/sで読み出す」というシステムは、発表のどこにも存在しません。
Appleの1.2TB/sは性格が異なります。512GB統合メモリ全体にかかる帯域幅です。1つのチップ、1つのメモリプールの話です。
| 最大メモリ | メモリ帯域幅 | 適用範囲 | 価格 | 状態 | |
|---|---|---|---|---|---|
| シャオミAIキューブ | 160GB(D100) | 1.22TB/s(O100) | チップ別に分離 | 未公開 | プロトタイプ |
| Mac Studio M5 Ultra | 512GB | 1.2TB/s | 統合メモリ全体 | 949万ウォン〜 | 9/22出荷 |
| Mac Studio M5 Max | 128GB | 614GB/s | 統合メモリ全体 | 429万ウォン〜 | 9/22出荷 |
| Mac mini M5 Pro | 64GB | 307GB/s | 統合メモリ全体 | 299万ウォン〜 | 9/22出荷 |
| Mac mini M6 | 32GB | 170GB/s | 統合メモリ全体 | 149.9万ウォン〜 | 9/22出荷 |
| NVIDIA DGX Spark | 128GB | 273GB/s | 統合メモリ全体 | 3,999ドル | 販売中 |
表に並べると、今回の発表の本当の意味が見えてきます。大きなモデルをそのままメモリに載せて、その全体を1.2TB/sで読み出す。それができるのは、現時点ではAppleだけです。
これが、異種チップをつなぎ合わせた構造が払う代償です。性格の異なる3つのチップをつなぎ合わせてはいますが、各チップの帯域幅と容量をそのまま合算して使えるわけではありません。チップ間でデータを移動させる工程も必要になるため、各チップの発表数値をシステム全体の性能として読んではいけません。
Appleが良くてシャオミが悪いという話ではありません。発表資料から一番大きな数字だけを抜き出して比較すると両者は同格に見えますが、実際にはまったく種類の異なる製品だ、ということです。
工程とメモリはどこから来るのか
ここからは共通点を見ていきましょう。
シュアンジエ O3はTSMCのN3P工程で生産されています。設計は小米(シャオミ)、製造は台湾です。メモリはさらに興味深いところがあります。O3が業界初対応をうたうLPDDR6、その最初の供給元として有力視されているのがSKハイニックスです。3月に10ナノ級第6世代(1c)工程の開発を終え、下半期の量産出荷を計画しています。同社は顧客企業を確認していませんが、業界では最初のロットが小米の次世代フラッグシップ向けになるとみられています。サムスン電子も1月に1b工程のLPDDR6を発表し、同じ供給競争に加わっています。
ところがAppleも事情は変わりません。Appleはファウンドリを持っていません。Mシリーズは TSMC で製造されています。統合メモリと呼んではいますが、そのDRAMも外部メモリメーカーから購入しています。Appleが自前で握っているのは設計とシステム統合、そしてその上に載せるソフトウェアです。
整理すると、両社の構造は驚くほど似通っています。
- 設計:各社自前
- 製造:TSMC
- メモリ:外部DRAMメーカー
つまり、設計だけを自前で行い、製造とメモリを外部から調達する方式は、小米だけの事情ではなくこの産業の標準戦略なのです。 Appleが20年かけて証明してきたことであり、小米も今、同じ方式をなぞっています。
ここでファーウェイとの違いが分かれます。ファーウェイは制裁対象であるためTSMCの最先端工程にアクセスできず、SMICの工程と自前調達のメモリでAscendを作らなければなりません。そのためファーウェイのチップは技術自立の象徴であると同時に、工程制約の産物でもあります。小米は制裁の枠外にいるため、最高のファウンドリと最高のメモリをただ買うことができます。小米がファーウェイより進んだ工程のチップを出せる理由は、技術力の差ではなく、制裁対象かどうかの差なのです。
O100が6ナノで3D積層を用いたのも、同じロジックで読み解けます。HBM3は高価で、供給量が事実上データセンター向けGPUに縛られています。個人用ボックスに搭載するのは難しいのです。そこでウェハーレベルで演算チップとメモリを直接積み重ね、距離を縮める迂回策を選びました。最先端が不要な領域では、一世代遅れた工程でコストを抑えています。
自律走行用D100がデスクトップAIボックスに入った理由
この発表で私が最も長く見入ったのはD100でした。
D100はスマートドライビング用チップですが、それがデスクトップAIボックスに入っています。最初は奇妙に見えますが、要求仕様を並べてみると納得がいきます。車載用AIチップは大容量メモリを搭載できなければならず、発熱と電力が制御されていなければならず、常時電源が入った状態で安定して動作しなければなりません。ローカルLLMボックスの要求仕様とほぼ同じです。
つまりシャオミは新しいカテゴリのために新しいチップを作ったわけではありません。**自動車用にすでに作っていたチップの用途を一つ増やしただけなのです。**スマートフォン、車、家電、そしてPCを一つのチップファミリーにまとめる構図です。Appleが iPhone用のAシリーズを育ててMacに移した経路とは方向が違うだけで、構造は同じです。
正直に付け加えると、AI Cubeはまだプロトタイプです。価格も発売日もなく、D100の量産が2027年であることを踏まえると、この箱が実際に販売される商品になるのは早くても再来年の話です。一方のMac Studioは来月には出荷されます。AI Cubeは早くても再来年、Mac Studioは来月というこの発売時期の差こそが、今の両社の実際の差です。
Oswarldの視点
私はこの発表を「中国の半導体崛起」と読むことに反対します。むしろ、最先端プロセスとメモリを依然として外部から買ってこなければならないという事実が、今回の発表でより鮮明になりました。ただ、それはApple も同じことです。
私が注目しているのは、設計だけを自社で手がけても新しいカテゴリーを開けるという点です。GTM戦略を練る中で私が繰り返し目にしてきたのも、新しいカテゴリーは部品を発明した会社ではなく、既存の部品の組み合わせを新たに定義した会社が開くという事実でした。
そうであれば、Xiaomiの勝負所は性能ではなく価格です。Appleは512GB統合メモリと1.2TB/sの帯域幅を949万ウォンから販売しています。Xiaomiがこの市場で意味を持つには、同程度の性能を半額で出すか、Appleがまったく手を出さない下位帯を取りにいく必要があります。Xiaomiがここ15年間で最も得意としてきたのが、まさにそのことです。
私自身もローカルAIを実際に運用しています。Mac Studioを常駐推論サーバーとして置き、MacBookをクライアントとして使っていますが、コーディングエージェントをローカルモデルにつなぐことも今では実際にできます。ただ、「何の制約もなく」と言うのは慎重になります。二カ所で引っかかるからです。コンテキストが小さく設定されていると、対話が長くなった際に前半部分が警告なしに切り落とされますし、複数ファイルにわたる難しい推論では、リトライが目に見えて増えます。
そのため私の判断は、ローカルがクラウドを代替するのではなく、作業が二種類に分かれるということです。反復的で機密性の高い作業はローカルに移り、難しい判断が必要な作業はクラウドに残ります。両社が狙っているのはローカルに移っていく側の市場であり、そこでは性能ではなく、メモリ容量と価格が勝負所になる可能性が高いと考えています。
おわりに
3行でまとめます。
- シャオミの1.22TB/sとAppleの1.2TB/sは適用範囲が違います。 大きなモデルをまるごと載せて全体をその速度で読み込めるのは、今のところAppleだけです。
- 両社とも完全な自立ではなく、設計だけを自社で手がけ、残りは調達する方式です。どちらもTSMCの製造プロセスと外部DRAMメーカーのメモリに依存している点で構造は同じです。Huaweiにできないことをシャオミができる理由は、技術力ではなく制裁ラインの内側か外側かの違いです。
- ローカルAIハードウェアは新しいカテゴリーではなく、既存のチップファミリーの派生市場として開かれつつあります。シャオミにとっては自動運転チップが、Appleにとってはiフォンのチップがそのルーツです。
発表されたスペックを読むときは、各数値がどのチップの数値で、どの範囲に適用されるのかをまず切り分けてみることをお勧めします。性格の異なるチップを束ねた発表では、これだけでも誇張された比較をかなりの部分ふるい落とせます。
💬 ローカルモデルにコーディングエージェントをつないで使ってみた方はいらっしゃいますか? どの作業まではローカルで十分で、どこからクラウドに戻したか、モデル名とあわせてコメントで教えてください。事例が集まったら、次号で「ローカルに下ろしてよい作業リスト」としてまとめてみます。
📨 Mac Studioの構成で悩んでいる同僚がいたら、この記事を転送してあげてください。


参考資料と関連リンク
主要出典
- Appleニュースルーム、「Apple、M5 MaxとM5 Ultraを搭載した新しいMac Studioを発表」、2026年8月。 リンク ··· 512GB・1.2TB/s・949万ウォンという、この記事の比較基準線がすべてここにあります。
- Appleニュースルーム、「Apple、まったく新しいM6とM5 Proを搭載したさらに強力なMac miniを発表」、2026年8月。 リンク ··· ローカルAI入門クラスの価格と帯域幅を確認できます。M6の32GB・170GB/sが現実的な下限です。
- IT之家、「小米 AI Cube 原型机公布」、2026年8月24日。 リンク ··· 発表当日のスペックが最も詳細にまとまった原文です。3つのチップの数値を分けて見るならここから。
- Notebookcheck、「Xiaomi unveils AI Cube mini PC with three Xring chips and 150 W performance」、2026年。 リンク ··· D100の2027年量産計画がここにあります。
- HotHardware、「Xiaomi Taps TSMC For 3nm Xring O3 Chip With LPDDR6」、2026年。 リンク ··· N3Pプロセス、240億トランジスタ、133mm²ダイの出典です。組み立てテーゼの核心根拠でもあります。
- ヘラルド経済、「[独占]SKハイニックス、LPDDR6を下半期に量産…シャオミへ初供給」、2026年7月28日。 リンク ··· 韓国のメモリがこの構図のどこに入るかを確認できます。CXMTのシェアへの言及も一緒にあります。
- Money Today、「Fold8に似たシャオミのスマホが登場…『業界初のLPDDR6』自社チップで勝負」、2026年8月25日。 リンク ··· O3に関する韓国国内報道の中で数値が最も正確です。113.8GB/sと48%向上という数値をここで確認しました。
背景知識
- EXO Labs、「Combining NVIDIA DGX Spark + Apple Mac Studio for 4x Faster LLM Inference」。 リンク ··· DGX Spark 128GB・273GB/sのような座標を押さえるのに役立ちます。帯域幅と容量がなぜ別々に動くのか、感覚がつかめます。
- OllamaおよびCodex CLIのローカルモデル連携ガイド ··· コーディングエージェントをローカルモデルに接続する手順と、コンテキストが静かに切り詰められる問題の解決策がまとめられています。

📝 用語解説
각주
-
LPDDR6:スマートフォンやノートパソコンに使われる低電力DRAMの次世代規格です。前世代のLPDDR5Xより、同じ電力でより多くのデータを転送できます。AIモデルは計算そのものよりデータ転送でボトルネックが生じることが多いため、オンデバイスAIではこの規格の切り替えが性能の体感にそのまま直結します。 ↩
-
近接メモリ演算(Near-Memory Computing):演算チップとメモリを物理的にできるだけ近づけて、データが行き来する距離を縮める設計です。倉庫を工場の隣に移すようなものです。距離が短くなれば同じ時間でより多くのデータを運べ、消費電力も減らせます。 ↩
-
HBM(High Bandwidth Memory):DRAMを垂直に積み重ねて帯域幅を大幅に高めたメモリです。主にAIアクセラレーターに使われますが、価格が高く生産量も限られているため、個人向け機器に搭載するのはまだ難しい状況です。 ↩
あわせて読みたい過去の号
ノートPCが考え込むばかりで止まってしまいました
Qwen 3.8 27BをノートPCで実行して返答を得られなかった体験を取り上げました。高い推論デフォルト値と実行ツールのコンテキスト上限が、結果にどのような影響を与えるのかを検証します。
AI・テックAI半導体のボトルネックが演算からメモリへと移行しました
Nvidiaによる15%のサーバー値上げとメモリ階層の分化、韓国製NPUの商機について整理しました。
AI・テックアリババがCPUメモリに置いた510億パラメータのルックアップテーブル
510億パラメータのN-gramルックアップテーブルをGPUではなくサーバーのCPUメモリに配置した理由と、9分の1や8.6倍といった発表数値が何を測定した値なのかを整理しました。
AI・テック