

小米1.22TB/s与苹果1.2TB/s,统计范围不同
小米1.22TB/s是O100芯片的近端内存带宽,苹果1.2TB/s是512GB统一内存整体的带宽
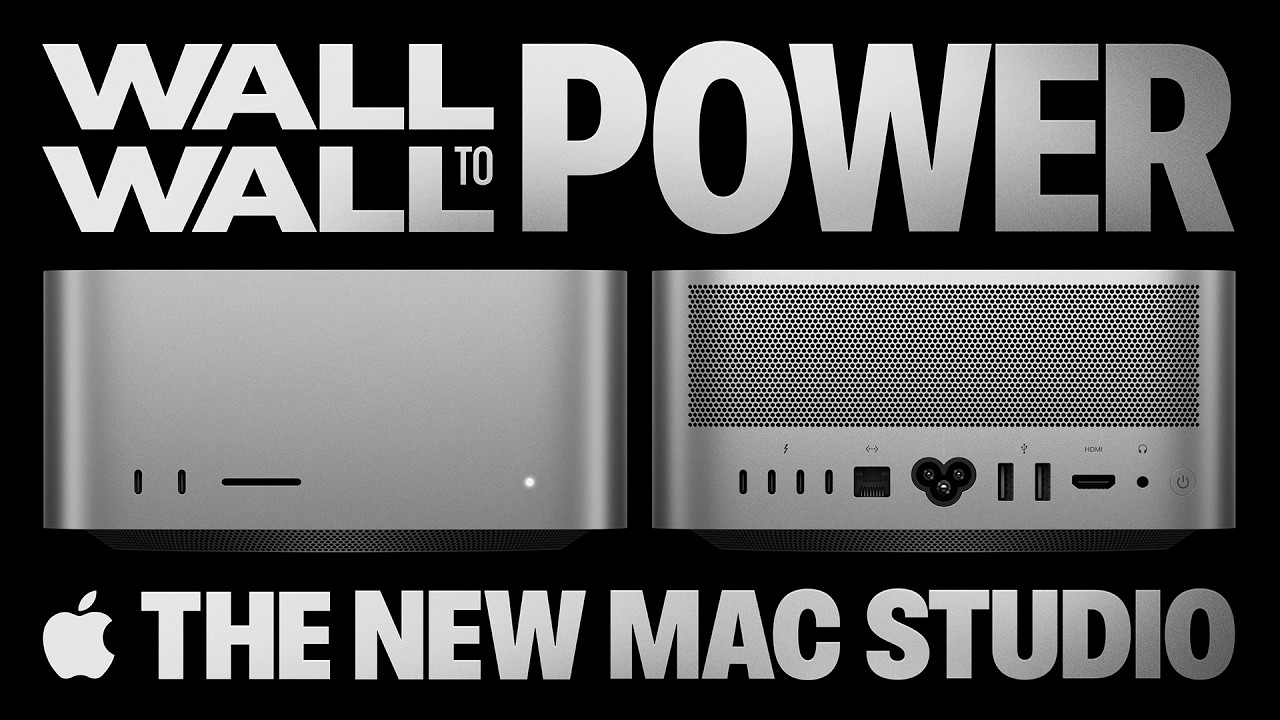
AI与科技同一周发布的小米AI Cube与新款Mac Studio
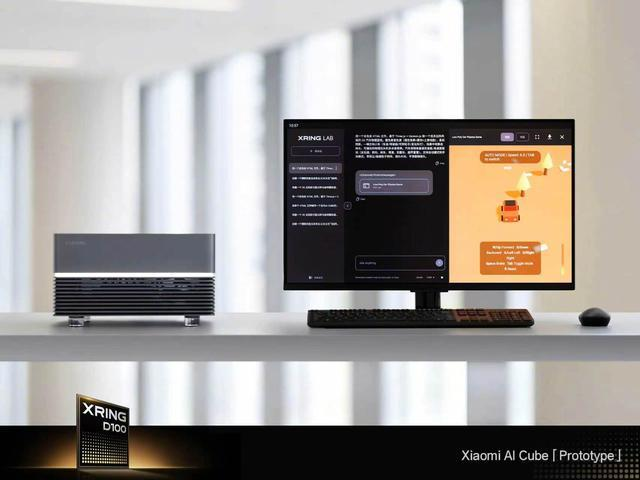
8月24日,小米在玄戒芯片技术说明会上,公开了自主研发的3款芯片,以及将其整合而成的“AI Cube”迷你PC原型机。没过几天,苹果就推出了搭载M5 Max与M5 Ultra的新款Mac Studio,以及搭载M6与M5 Pro的新款Mac mini。预订从8月27日开始,出货则在9月22日。
也就是说,同一周内出现了两种要摆在桌面上的AI盒子。而且两场发布会都提到了几乎相同的数字。小米是1.22TB/s,苹果是1.2TB/s。
不过,这两个数字所指的范围并不相同。而两家公司还有一个更重要的共同点:**两家都只是自主设计芯片,制造和内存都要向外部采购。**而这份供应名单里,就包含韩国的内存企业。
两款产品的发布规格整理
先来准确梳理一下发布内容。因为数字混杂在一起,容易产生误解的地方不少。
小米玄戒 O3 是面向旗舰智能手机的 SoC。采用 3 纳米工艺,晶体管数量 240 亿个,芯片面积 133mm²。10 核 CPU 最高可达 4.35GHz,GPU 为 16 核,NPU 算力为 200 TOPS。值得关注的是其号称业界首个支持 LPDDR61的芯片。速度达到 10,667Mbps,带宽为 113.8GB/s,相比 LPDDR5X 9600 提升了 48%。
玄戒 O100 是用于大模型加速的芯片。采用 6 纳米工艺,使用了 3D 晶圆级堆叠封装,有效数据线数量达 28,672 条,官方表示其近内存计算2带宽最高可达 1.22TB/s。
玄戒 D100 是智能驾驶用芯片。采用 3 纳米工艺,配备 20 核 CPU 和 16 核 NPU,最高支持 160GB 内存。据悉将于 2027 年量产。
AI Cube 是将这三款芯片打包在一起的机箱。持续性能为 150W,最高支持 160GB 统一内存,可本地运行从 3B 到 120B 的模型。外壳采用航空航天级铝材,打了 33,874 个 CNC 孔洞,是一款明显走炫技路线的外观设计。既没有公布价格,也没有公布上市日期,属于工程样机阶段。
1.22TB/s 与 1.2TB/s,各自覆盖的是什么范围
小米的 1.22TB/s 和 160GB 不能连在一起读。
1.22TB/s 是 O100 的近端内存带宽,160GB 是 D100 支持的内存容量。这是两颗不同芯片的两个不同数值。发布材料里没有任何地方提到“以 1.22TB/s 的速度读取 160GB”这样的系统。
苹果的 1.2TB/s 性质不同。这是加在 512GB 统一内存整体上的带宽。一颗芯片,一个内存池。
| 最大内存 | 内存带宽 | 适用范围 | 价格 | 状态 | |
|---|---|---|---|---|---|
| 小米 AI Cube | 160GB(D100) | 1.22TB/s(O100) | 按芯片分离 | 未公开 | 原型机 |
| Mac Studio M5 Ultra | 512GB | 1.2TB/s | 统一内存整体 | 949 万韩元起 | 9 月 22 日出货 |
| Mac Studio M5 Max | 128GB | 614GB/s | 统一内存整体 | 429 万韩元起 | 9 月 22 日出货 |
| Mac mini M5 Pro | 64GB | 307GB/s | 统一内存整体 | 299 万韩元起 | 9 月 22 日出货 |
| Mac mini M6 | 32GB | 170GB/s | 统一内存整体 | 149.9 万韩元起 | 9 月 22 日出货 |
| NVIDIA DGX Spark | 128GB | 273GB/s | 统一内存整体 | 3,999 美元 | 销售中 |
放进表格里,这次发布的真正含义就显现出来了。把一个大模型整个放进内存、再以 1.2TB/s 的速度读取整体,眼下只有苹果能做到。
这就是拼接异构芯片这种结构要付出的代价。虽然接在一起的是三颗性质不同的芯片,但各芯片的带宽和容量并不能原样相加使用。因为芯片之间还需要经过数据搬运的过程,所以不能把每颗芯片单独的发布数值直接当作整个系统的性能来读。
这并不是说苹果好、小米差。如果只从发布材料里挑出最大的数字来比较,两款产品看起来是同一个量级,但实际上它们是完全不同种类的东西。
制程与内存来自何处
现在该看共同点了。
玄戒 O3 由台积电的 N3P 制程生产。小米负责设计,台湾负责量产。内存则更有意思。O3 号称业界首款支持的那款 LPDDR6,最有力的首发供应商传言指向 SK 海力士。该公司已于 3 月完成 10 纳米级第 6 代(1c)制程开发,计划下半年量产出货。该公司并未确认客户名单,但业界普遍认为首批量产会供给小米的下一代旗舰机型。三星电子也在 1 月发布了 1b 制程的 LPDDR6,加入了同一场供应竞赛。
而苹果的情况其实并无不同。苹果没有自己的晶圆代工厂。M 系列芯片由台积电代工。虽然被称为统一内存,但那颗 DRAM 也是从外部内存厂商采购而来。苹果真正牢牢握在手中的,是设计、系统集成,以及架在其上的软件。
概括一下,这两家公司的结构相似得令人惊讶。
- 设计:各自独立完成
- 制造:台积电
- 内存:外部 DRAM 厂商
也就是说,**只亲自做设计、把制造与内存外包出去的模式,并非小米独有的处境,而是这个行业的标准策略。**苹果用二十年时间证明了这一点,小米如今也在走同样的路。
正是在这一点上,与华为分道扬镳。华为是制裁对象,无法接触台积电的最先进制程,只能用中芯国际的制程和自主采购的内存来打造昇腾。因此华为的芯片既是技术自立的象征,也是制程受限的产物。小米则处在制裁范围之外,可以直接购买最好的代工厂与最好的内存。小米之所以能推出制程领先于华为的芯片,靠的不是技术实力,而是是否属于制裁对象这一差别。
O100 在 6 纳米上采用 3D 堆叠,也可以用同样的逻辑来解读。HBM3价格昂贵,产能实际上几乎都被数据中心 GPU 占用,很难塞进个人用的主机里。于是小米选择了在晶圆级别直接堆叠运算芯片与内存、缩短距离的迂回方案。而在不需要最先进制程的领域,则用落后一代的制程来节省成本。
面向自动驾驶的D100为何进了桌面AI盒子
在这场发布会上,我看得最久的是D100。
D100是一款智能驾驶芯片,但它被装进了桌面AI盒子里。乍一看有些奇怪,但把需求一条条列出来就能理解了。车规级AI芯片必须能挂载大容量内存,发热和功耗必须受到控制,还必须能常开状态下稳定运行。这几乎和本地LLM盒子的需求一模一样。
也就是说,小米并不是为了一个新品类而重新造了一颗新芯片。**它只是把原本为汽车打造的芯片,多加了一个用途。**手机、汽车、家电、PC由一个芯片家族统一起来——这幅图景,与苹果把最初为iPhone打造的A系列芯片壮大后移植到Mac上的路径方向不同,但结构是一样的。
诚实地补一句,AI Cube目前还只是原型机。没有价格,也没有发售日期,考虑到D100要到2027年才量产,这个盒子真正成为一件可购买的商品,最快也要等到后年。而对面的Mac Studio下个月就要开始发货了。AI Cube最快后年,Mac Studio下个月——这一发布时间点上的差距,就是这两家公司眼下真实的差距。
Oswarld视角
我反对把这次发布解读为“中国半导体的崛起”。恰恰相反,最尖端制程和存储芯片仍然必须从外部采购,这一事实在此次发布中反而变得更加清晰。不过这一点苹果也是一样的。
我更关注的是:即便只做设计,也能开辟新品类。在制定GTM战略的过程中,我反复看到的一点是,开辟新品类的往往不是发明零部件的公司,而是重新定义现有零部件组合方式的公司。
那么小米的胜负手就不在性能上,而在价格上。苹果目前以 949 万韩元起售配备 512GB 统一内存与 1.2TB/s 带宽的产品。小米若想在这个市场上具有意义,要么以一半的价格推出相似量级的产品,要么去抢占苹果根本不在意的低端市场。而这恰恰正是小米过去 15 年来做得最好的事情。
我自己也在实际运行本地AI。我把 Mac Studio 用作常驻推理服务器,MacBook 当客户端,如今把编码代理挂在本地模型上也已经是能实际做到的事了。不过要说“完全没有限制”,我还是有所保留。因为在两个地方会卡住:如果上下文窗口设置得较小,对话变长时前面的内容会在没有任何提示的情况下被截断;而在涉及多个文件的高难度推理任务中,重试次数会明显增多。
所以我的判断是,本地并不会取代云端,而是任务会分化成两类。重复性强、且涉及敏感信息的任务会转移到本地进行,而需要复杂判断的任务则会留在云端。这两家公司瞄准的正是转向本地的那部分市场,而在那里,胜负手很可能不是性能,而是内存容量与价格。
结语
用三句话总结一下。
- 小米的 1.22TB/s 与苹果的 1.2TB/s 适用范围不同。 把大模型整体加载并以该速度整体读取,目前只有苹果能做到。
- 两家公司都不是完全自主研发,而是只负责设计、其余部分外包采购的方式。两者都依赖台积电工艺和外部 DRAM(内存)厂商的内存,这一点结构相同。华为做不到而小米能做的原因,不是技术,而是是否在制裁范围之内。
- 本地 AI 硬件不是一个全新的品类,而是作为现有芯片系列的衍生市场在展开。对小米而言,其根源是自动驾驶芯片;对苹果而言,其根源是 iPhone 芯片。
在阅读发布会公布的规格时,建议先区分每个数值属于哪款芯片、适用于哪个范围。在把性质不同的芯片捆绑在一起发布的场合,仅凭这一点区分,就能过滤掉相当一部分被夸大的比较。
💬 有没有把编码代理接到本地模型上使用过的朋友?哪些任务用本地模型就够用了,从哪个环节又不得不切回云端,欢迎连同模型名称一起在评论区分享。等案例积累多了,下一期我们打算整理一份“可以放心下放到本地的任务清单”。
📨 如果身边有同事正在纠结 Mac Studio 该怎么配置,欢迎把这篇文章转发给他们。


参考资料与延伸阅读
核心来源
- Apple 新闻室,《Apple 发布搭载 M5 Max 和 M5 Ultra 的全新 Mac Studio》,2026 年 8 月。 链接 ……512GB、1.2TB/s、949 万韩元,这篇文章的比较基准全部出自这里。
- Apple 新闻室,《Apple 发布搭载全新 M6 与 M5 Pro、性能更强大的 Mac mini》,2026 年 8 月。 链接 ……可以确认本地 AI 入门级别的价格和带宽。M6 的 32GB、170GB/s 是现实中的下限。
- IT之家,《小米 AI Cube 原型机公布》,2026 年 8 月 24 日。 链接 ……发布当天规格整理得最细致的原文。想分开看三颗芯片的数值,就从这里看起。
- Notebookcheck,《Xiaomi unveils AI Cube mini PC with three Xring chips and 150 W performance》,2026 年。 链接 ……D100 的 2027 年量产计划就在这里。
- HotHardware,《Xiaomi Taps TSMC For 3nm Xring O3 Chip With LPDDR6》,2026 年。 链接 ……N3P 工艺、240 亿个晶体管、133mm² 芯片面积的出处。也是“拼装论”的核心依据。
- 《赫尔德经济》,《[独家] SK海力士,LPDDR6 下半年量产……小米首发供货》,2026 年 7 月 28 日。 链接 ……可以确认韩国存储器在这幅图景中处于什么位置,同时也提到了 CXMT 的市场份额。
- Money Today,《酷似 Fold8 的小米手机将问世……“行业首款 LPDDR6”自研芯片的杀手锏》,2026 年 8 月 25 日。 链接 ……国内关于 O3 的报道中数值最准确的一篇。113.8GB/s 和提升 48% 的数字就是从这里确认的。
背景知识
- EXO Labs,《Combining NVIDIA DGX Spark + Apple Mac Studio for 4x Faster LLM Inference》。 链接 ……在标定 DGX Spark 128GB、273GB/s 这类坐标时很有用。能大致理解带宽和容量为何各走各的路。
- Ollama 及 Codex CLI 的本地模型连接指南……整理了把编程代理接到本地模型的流程,以及上下文被悄悄截断问题的解决方法。

📝 术语说明
注释
-
LPDDR6:智能手机和笔记本电脑所用低功耗 D 内存的下一代规格。相比上一代 LPDDR5X,能在相同耗电量下搬运更多数据。AI 模型的瓶颈往往不在计算本身,而在数据搬运上,所以在端侧 AI 中,这一规格的更换会直接转化为可感知的性能差异。 ↩
-
近存计算(Near-Memory Computing):一种把运算芯片和内存尽可能物理贴近、以缩短数据往返距离的设计。类似于把仓库搬到工厂旁边。距离缩短后,同样的时间内能搬运更多数据,耗电也更少。 ↩
-
HBM(High Bandwidth Memory):通过垂直堆叠 D 内存大幅提高带宽的内存类型。主要用于 AI 加速器,但价格昂贵、产量有限,目前还很难塞进个人设备。 ↩