글 한 줄 못 쓰는 AI에 개발자들이 몰렸어요
Jev가 매긴 '판단'의 가격, 그리고 제가 다섯 가지 행동만 하는 모델을 만드는 이유
AI·테크하루 만에 유료 팀 13%가 붙은 모델은 글을 못 써요
구독자님, 지난 9월 15일에 미국 스타트업 타입세이프 AI(TypeSafe AI)가 2년간의 비공개 개발을 끝내고 첫 모델 Jev를 공개했어요. DCVC가 주도한 4,000만 달러 시드 투자 발표도 함께였고요. 창업자 디오고 알메이다는 오픈AI 연구원 출신으로, InstructGPT 논문에 공동 저자로 이름을 올린 사람이에요. 챗GPT가 사람 말을 잘 따르게 만든 바로 그 방법론 쪽이죠.
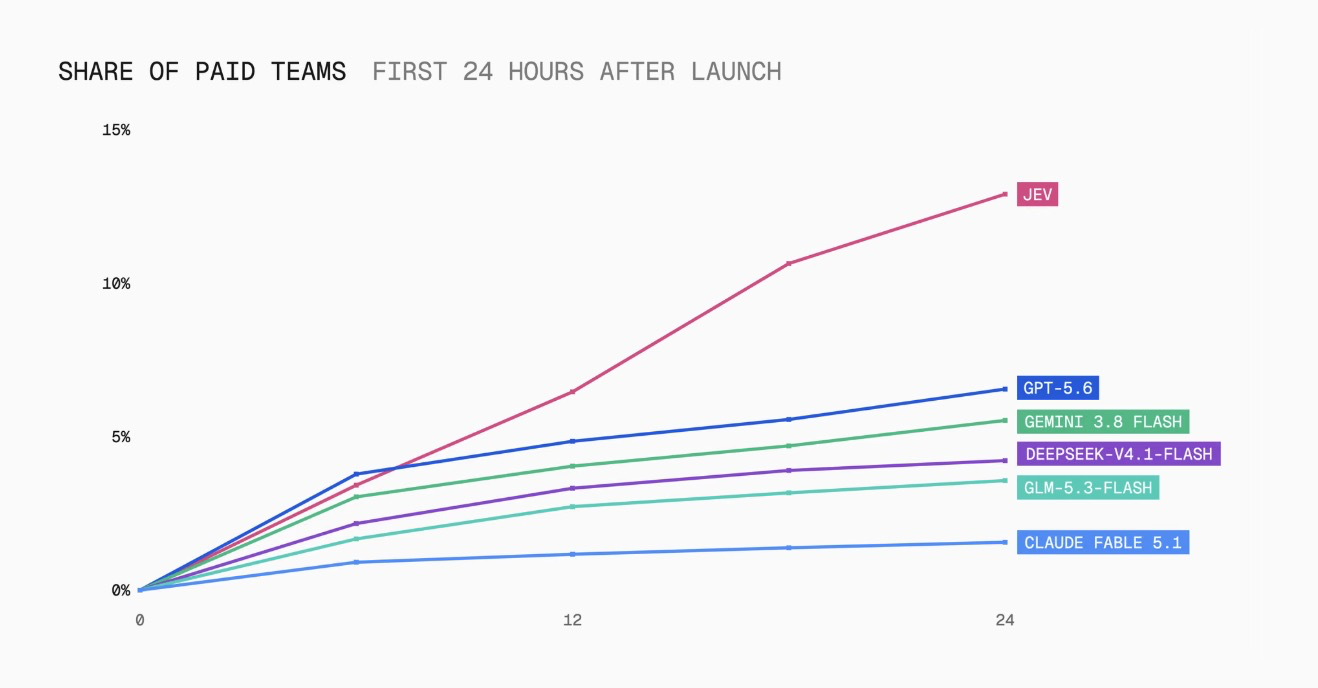
반응이 빨랐어요. 버셀(Vercel)은 자사 AI 게이트웨이에 Jev를 올린 지 24시간 만에 유료 팀의 약 13%가 이 모델을 썼다고 발표했어요. 같은 기준으로 GPT-5.6 제품군의 2배, Fable 5.1의 6배가 넘고, 게이트웨이 역사상 가장 빨리 채택된 모델이래요. 클라우드플레어와 오픈라우터 모델 목록에도 며칠 사이에 올라갔고요.
저는 이 이야기를 ZDNet 칼럼으로 먼저 썼어요. 지면이 짧아서 덜어낸 설명이 많았는데, 오늘은 그걸 다 풀어볼게요. Jev가 정확히 무슨 일을 하는지, 회사가 내건 숫자를 어떻게 읽어야 하는지, 그리고 제가 진행 중인 온디바이스 프로젝트 KASI가 같은 원리를 어디로 가져가려는지까지요.
제가 늘 하는 말이 하나 있어요. 모든 일에 초지능이 필요한 건 아니에요. Jev는 그 말을 가격표로 보여준 사례예요.
Jev는 답을 쓰지 않고 골라요
Jev에 보내는 건 두 가지예요. 하나는 상태(state)예요. 고객 문의, 송장 데이터, 에이전트 실행 기록처럼 판단 대상이 되는 텍스트죠. 다른 하나는 형식이 정해진 질문이에요. 질문은 세 종류뿐이에요.
| 질문 타입 | 묻는 것 | 돌려주는 것 |
|---|---|---|
| Noul | 이 진술이 참인가 | 참일 확률 (0~1) |
| Choice | 후보 중 어느 것인가 (최대 255개) | 고른 후보, 후보별 확률, 확신도 |
| Score | 정해둔 등급에서 어디쯤인가 | 점수, 등급별 확률, 확신도 |
알메이다가 해커뉴스에서 직접 한 설명이 제일 쉬워요. Choice는 코드의 match 문, Score는 정렬, Noul은 if 문에 대응한다는 거예요. Noul은 베르누이(Bernoulli)를 줄인 이름이고요. 그러니까 Jev의 답을 받는 쪽은 사람이 아니라 코드예요.
튜링포스트 코리아 팀이 사전 접근 권한으로 돌려본 예시가 이 구조를 잘 보여줘요. 와이파이 고장을 신고한 뒤 일주일 넘게 답을 못 받은 사용자가 “제 신고 어떻게 되고 있나요”라고 다시 물은 상황이에요. 이 메시지 하나에 질문 네 개를 한꺼번에 던졌어요.
- 우선순위(Score): medium 83%
- 담당 팀(Choice): IT 헬프데스크 100%
- 마감 언급 여부(Noul): 5%
- 써야 할 도구(Choice, 후보 약 200개): ticket-status 73%, wifi-troubleshoot 25%
마지막 답이 중요해요. 단어만 보면 와이파이 수리 도구를 고르기 쉬운데, 사용자가 묻는 건 고치는 방법이 아니라 이미 낸 신고의 처리 상태거든요. 에이전트가 일 하나를 끝내는 동안 이런 갈림길이 수십 번 나와요.
하나 더 봐둘 게 있어요. Jev는 티켓을 직접 조회하지 않았어요. 어떤 도구를 쓸지 골랐을 뿐이고, 실행은 그 값을 받은 소프트웨어가 해요. 고르는 쪽과 실행하는 쪽을 나누는 이 구분은 뒤에서 KASI를 설명할 때 다시 나와요.
빠르고 싼 이유는 글쓰기를 건너뛰어서예요
일반적인 LLM1에 “이 문의는 환불, 배송, 기술 지원 중 어디에 해당하나요”라고 물으면 과정이 길어요. 모델은 토큰2을 하나씩 만들어 문장이나 JSON을 쓰고, 소프트웨어는 그 글을 다시 해석해서 값을 꺼내요. 답은 셋 중 하나인데, 그 하나를 얻으려고 글쓰기 과정 전체를 거치는 거예요.
답의 후보가 미리 정해져 있다면 글을 쓸 필요가 없어요. 모델이 각 후보에 매긴 확률만 읽으면 돼요. 생성 단계를 건너뛰니 빠르고, 출력이 정해진 형식 밖으로 나갈 수 없으니 해석 오류도 안 생겨요. 질문 여러 개를 한 번에 보내도 각각 따로, 동시에 계산되니까 질문을 늘려도 응답 시간이 거의 안 늘어요. 공개된 가격은 입력 100만 토큰당 0.042달러, 출력은 무과금이에요. 응답은 0.07초에서 0.5초 사이고요.
타입세이프는 내부 구조를 공개하지 않았어요. 새 아키텍처, 병렬 샘플러, ‘보정된 판단을 위한 강화학습(RLCD)‘이라는 이름만 나왔고 가중치도 논문도 없어요. 다만 원리 자체는 비밀이 아니에요. 공개 직후 나온 독립 프로젝트 OpenJev는 공개 모델이 선택지마다 매긴 로짓3만 읽어서 정규화하는 방식으로 같은 동작을 재현했어요. 102행짜리 평가 부분집합에서 파라미터 40억 개짜리 Qwen3.5 4B의 일치율이 84.5%, 같은 부분집합에서 공개된 Jev의 값이 88.3%예요. 6억 개짜리 모델은 40.7%에 그쳤고요. 표본이 작고, 브라우저용 빌드는 양자화4돼서 수치가 달라질 수 있다는 단서가 붙어 있어요.
Jev는 답을 쓰지 않고 골라요
글로 읽으면 헷갈리는 세 가지를 직접 만져볼 수 있게 했어요. 왜 빠른지, 193배는 누구와 비교한 숫자인지, 확신도를 어떻게 쓰는지예요.
같은 문의를 두 방식으로 처리해 보세요
문의를 고르고 실행하면 두 모델이 동시에 출발해요. 시계는 실제 시간 그대로 흘러요. 끝까지 기다려 보시면 차이가 몸으로 느껴져요.
두 시계의 도착 시간(10.1초, 0.4초)은 타입세이프 평가 사이트가 공개한 네 개 업무 평균값이에요. 왼쪽은 정확도가 같았던 GPT-5.6 Terra의 값이고요. 화면에 나오는 확률과 출력문은 구조를 설명하려고 만든 가상 예시이고, 실제 API를 호출하지 않아요. 확신도는 분포가 한쪽으로 얼마나 쏠렸는지를 이 페이지에서 단순 계산한 값이에요.
비교 상대를 바꾸면 배수가 바뀌어요
Jev의 값은 그대로 두고 분모만 골라보세요. 숫자는 전부 타입세이프가 공개한 평가표에서 가져왔어요.
막대는 로그 눈금이에요. 한 칸이 열 배예요. 표에 공개된 Jev 값(0.4초, 0.0004달러)이 반올림돼 있어서 배수는 어림값이고, 홈페이지의 193.6배, 444.6배와 조금 달라요. 정확도는 사람이 만든 정답과 맞춘 비율이 아니라 GPT-6 Astra와 Claude Fable 5.1의 평균 응답과 일치한 비율이에요. 출처: evals.typesafe.ai, 2026년 9월 20일 확인.
기준선을 움직여 세 갈래를 나눠보세요
점 하나가 판단 한 건이에요. 오른쪽에 있을수록 모델이 확신한 판단이에요. 자동 처리 기준을 낮추면 일은 줄지만, 속이 빈 점(틀린 판단)이 자동 처리 구간으로 들어와요.
점 18개와 정오 여부는 설명용 가상 데이터예요. 실제로는 이 그림을 자기 업무 데이터와 사람이 붙인 정답으로 그려봐야 기준선을 정할 수 있어요. 모델이 0.85라고 한 판단들이 정말 85%쯤 맞는지 보여주는 보정 곡선을 타입세이프는 아직 공개하지 않았어요.
여기서 읽을 수 있는 건 두 가지예요. 하나, Jev가 보여준 효율의 상당 부분은 문제를 닫힌 선택지로 바꾸는 설계에서 나오고, 그 설계는 작은 공개 모델에서도 작동해요. 둘, 그렇다고 Jev가 작은 모델에 포장만 씌운 물건이라고 단정할 수도 없어요. 한 개발자가 MMLU-Pro 문제 1,000개를 뽑아 Jev에 돌려봤더니 83%가 나왔고, 같은 문제에서 Qwen 계열 공개 모델 두 개는 60% 안팎이었다고 해요. 쉬운 분류에서는 격차가 작고 어려운 문제에서는 벌어진다는 뜻이에요.
타입세이프의 평가 사이트에서 제가 더 눈여겨본 숫자는 따로 있어요. 같은 업무를 통짜 프롬프트 하나로 시켰을 때와, 좁은 질문 여러 개로 쪼개고 나머지는 코드에 맡겼을 때를 모든 모델에 대해 비교했는데, 네 업무 평균으로는 쪼갠 쪽이 예외 없이 더 정확하고 더 싸고 더 빨랐어요. Claude Opus 5도 프롬프트로는 64.8%, 쪼갠 워크플로로는 73.1%예요. Jev를 쓰든 안 쓰든 가져갈 수 있는 결과예요.
193배는 누구와 비교한 숫자일까요
타입세이프 홈페이지에는 “193.6배 빠르고 444.6배 저렴하다”고 적혀 있어요. 이 배수는 분모가 누구인지 확인하고 읽어야 해요. 평가 사이트가 공개한 네 개 업무 평균값을 옮기면 이래요.
| 모델 (워크플로 방식) | 정확도 | 건당 비용 | 건당 시간 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4초 |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9초 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1초 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1초 |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3초 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8초 |
정확도가 같은 Terra를 기준으로 계산하면 Jev는 약 25배 빠르고 약 76배 싸요. 가장 싼 축인 Luna와 견주면 비용 차이는 8배쯤으로 줄어요. 190배와 440배 안팎의 숫자는 표에서 가장 느린 Sonnet 5와 가장 비싼 Opus 5를 각각 분모로 삼아야 나와요. 25배, 76배만으로도 충분히 큰 차이인데 가장 유리한 기준을 골라 배수를 키운 셈이에요. 공평하게 덧붙이면, 타입세이프도 발표문에 이 숫자가 실제 이득의 상단 쪽일 거라고 직접 적어놨어요.
정확도에는 더 중요한 단서가 있어요. 이 평가의 정답지는 사람이 만들지 않았어요. GPT-6 Astra와 Claude Fable 5.1의 응답을 평균해서 기준 라벨로 삼았어요. 그러니 67.8%는 정답률이라기보다 최상위 모델 두 개와 의견이 일치한 비율이에요.
업무별 편차도 커요. 고객 응대에서는 Jev 76.0%, 최고점인 Sol 78.3%로 2.3%포인트 차이예요. 송장 처리에서는 Jev 61.8%, Sol 79.1%로 17.3%포인트가 벌어져요. 송장은 금액과 날짜와 수량을 맞춰봐야 하는 일이고, 그건 Jev 문서가 스스로 약점이라고 밝힌 영역이에요.
‘환각이 없다’는 문구도 같은 식으로 읽으면 돼요. 출력이 정해진 형식을 벗어나지 않는다는 뜻이에요. 타입세이프도 0%라는 수치가 실측이 아니라 구조상 보장되는 값이라고 밝혔고요. 형식에 맞는 오답은 나와요. 기술 문의를 ‘결제’로 분류하면 타입은 맞고 뜻은 틀린 거죠.
0.85는 정말 85%일까요
가장 큰 미검증 항목은 확률의 품질이에요.
타입세이프 문서는 확신도를 세 구간으로 나눠 쓰라고 권해요. 높으면 자동 처리하고, 중간이면 사용자 확인을 받거나 검토 대상으로 표시하고, 낮으면 실행하지 말고 사람이나 다른 시스템에 넘기라는 거예요. 문서의 예시 코드를 보면 잔액 조회 같은 가벼운 일은 그냥 진행하고, 출금 승인 같은 고위험 작업은 확신도가 0.9를 넘을 때만 다음 단계로 가요. 모델이 모른다는 사실이 버려지지 않고 분기 조건으로 쓰이는 설계예요.
이 설계는 확률이 믿을 만할 때만 성립해요. Jev가 0.85라고 답한 판단들을 모아놓으면 실제로 85%쯤 맞아야 해요. 이걸 보여주는 보정(calibration)5 곡선을 타입세이프는 공개하지 않았고, 사람이 라벨링한 데이터로 제3자가 검증한 결과도 아직 없어요.
참고할 만한 독립 사용기가 하나 있어요. 가격 비교 엔진을 운영하는 개발자 paddo는 사람이 검토할 엄두를 못 내던 저신뢰 상품 매칭 9,081건을 Jev에 맡겼어요. 비용은 32센트, 시간은 13분이 들었어요. Jev는 49%를 기각하고 21%를 확정했고 30%는 판단을 보류했어요. 사람이 봐야 할 목록이 9,081건에서 2,686건으로 줄어든 거예요. 그가 50건을 직접 읽어보니 48건이 타당했어요. 동시에 그는 50건으로는 0.85가 85%를 뜻하는지 검증할 수 없다고 적었고, 그래서 이 판정을 참고용 열에만 기록하고 아직 아무 동작도 걸지 않았대요. 저는 이 태도가 맞다고 봐요.
문서가 공개한 약점 중에 확률을 다룰 분들이 꼭 봐야 할 게 하나 더 있어요. 중복 결제 문의에 “환불을 요청하는가”를 물으면 0.72, “환불이 아닌 다른 걸 요청하는가”를 물으면 0.47이 나온 예시예요. 둘을 더하면 1.19예요. 같은 질문을 뒤집어 물은 두 확률이 1로 맞아떨어지지 않아요. 문서의 권고는 이런 산술 관계를 기대하지 말고, 한 가지 판단은 한 가지 방식으로만 물으라는 거예요.
한국어도 따로 짚어둘게요. 한 독립 해설 사이트는 Jev의 주 학습 언어가 영어라고 정리하고 있어요. 문서가 밝힌 첫 번째 약점이 곧이곧대로 읽는 버릇인데, 한국어 업무 문장은 완곡한 거절과 생략이 많죠. “검토해 보겠습니다”가 거절일 수 있는 언어에서는 자기 데이터로 직접 재보는 수밖에 없어요.
같은 원리를 기기 안으로 가져가면
여기서부터는 제 이야기예요. 저는 KASI(Kernel Action Schema Intelligence)라는 온디바이스 AI 프로젝트를 진행하고 있어요. 소스 코드는 깃허브에 Apache 2.0 라이선스로 공개했고, 연구와 개인 목적에는 무료로, 기업과 기관에는 유료로 공급해요.
KASI가 하는 일도 하나예요. 한국어 요청과 JSON 도구 스키마6를 받아서 다섯 가지 구조화된 행동 중 하나로 바꿔요.
| 행동 | 뜻 | 누가 정하나 |
|---|---|---|
| call | 도구를 인자와 함께 호출 | 모델이 제안, 래퍼가 검증 |
| clarify | 빠진 정보를 되물음 | 모델 또는 래퍼 |
| confirm | 위험한 도구 실행 전에 동의를 구함 | 래퍼만 |
| refuse | 모르는 도구, 모호하거나 위험한 요청을 거절 | 모델 또는 래퍼 |
| respond | 도구 실행 결과를 사용자에게 전달 | 모델 (실행 결과를 받은 뒤에만) |
표에서 래퍼는 모델과 기기 사이에 놓인 보통 코드예요. 읽을 수 있고 테스트할 수 있는 쪽이죠.
“거실 불 좀 줄여줘”라는 말에 모델이 문장으로 답할 이유가 없어요. 필요한 건 어떤 도구를 어떤 인자로 부를지, 되물을지, 거절할지의 결정이에요. Jev와 출발점이 같아요. 출력 공간을 닫는 거예요.
정보가 모자란 것과 허락이 모자란 것
설계하면서 제가 가장 오래 붙잡고 있던 건 clarify와 confirm을 나누는 일이었어요. “오븐 켜줘”에는 온도가 빠져 있어요. “현관문 열어줘”는 인자가 다 있는데도 그냥 실행하면 안 돼요. 앞쪽은 정보가 모자란 거고 뒤쪽은 허락이 모자란 거예요. 기기 입장에서는 필요한 화면도 달라요. 정보는 값을 다시 입력받아야 하고, 동의는 예/아니오 버튼 하나면 돼요.
그래서 confirm은 모델이 고르지 않아요. 모델이 낸 호출 제안과 도구의 위험 등급을 대조해서 래퍼가 정해요. 위험 등급 정보는 모델에 넘기기 전에 스키마에서 떼어내요. 모델이 “문 여는 건 위험하겠지”라고 짐작할 수는 있지만, 그 짐작에는 아무 권한이 없어요. 동의 기록은 기기의 상태이지 모델의 말솜씨가 아니니까요. 모델은 도구를 직접 실행하지도 않아요. 최종 실행 권한은 호스트 애플리케이션에 남아요.
“더 큰 모델이나 사람에게 넘기기”를 여섯 번째 행동으로 넣지 않은 이유는 Jev 이야기와 이어져요. 모든 행동에 확신도가 붙으니까, 넘길지 말지는 호스트가 그 숫자를 보고 정하면 돼요. Jev 문서의 세 구간과 같은 생각이에요. 래퍼는 확신도가 도구의 위험 등급별 기준에 못 미치면 제안을 버리고 “다시 말씀해 주세요”라는 clarify로 바꿔요. 설계 기본값은 위험도 낮음 0.65, 중간 0.80, 높음 0.95예요. 이 관문은 동의 관문보다 앞에 있어요. 확신 없는 제안을 들고 사용자에게 동의를 구하면 안 되니까요.
이 모델의 논문은 올해 말에 공개 될 예정이에요.
다른 점은 위치예요
Jev는 타입세이프의 클라우드 API로만 쓸 수 있고, 가중치는 비공개고, 직접 설치해 운영할 방법이 없어요. 0.1초대 응답도 네트워크가 붙어 있을 때 이야기예요.
가전, 공장 설비, 차량처럼 연결이 끊겨도 동작해야 하고 데이터를 밖으로 보내기 어려운 환경에서는 판단이 기기 안에서 끝나야 해요. KASI의 목표 기기는 아두이노급 마이크로컨트롤러, 라즈베리파이급 단일 보드 컴퓨터, 소형 PC 세 단계예요. 현재 기준 모델은 파라미터 약 4,500만 개짜리고, 모델 파일 16MiB, 실행 메모리 32MiB 안에 넣는 게 목표예요. 선택지를 더 좁히고 한국어와 도구 호출에 특화하면 모델을 어디까지 줄일 수 있는지가 KASI가 확인하려는 질문이에요. 제 목표는 출력을 다섯 가지 행동으로 닫아서, 네트워크 없는 작은 기기에서도 0.1초대 응답을 내는 거예요.
작은 기기에서는 글쓰기를 줄이는 것만으로는 부족해서 장치를 두 개 더 뒀어요. 하나는 문법 제약 디코딩이에요. 그 순간 선언된 도구 스키마에서 문법을 뽑아내서, 모델이 목록에 없는 도구 이름이나 범위 밖 값을 아예 만들 수 없게 해요. Jev의 “타입 오류가 없다”와 같은 종류의 보장이고, 그래서 한계도 같아요. 형식이 맞는 것과 뜻이 맞는 것은 따로 재야 해요. 다른 하나는 입력 정규화예요. 한국어 입력기로 치다 보면 “22도”처럼 전각 숫자가 섞여 들어오는데, 이걸 22로 접어서 맞춰요. 반대로 사용자가 친 글자를 그대로 넘겨야 하는 문자열 인자는 원래 바이트로 되돌려놔요. 한국어 외에 영어, 중국어, 일본어도 받아요.
아직 못 보여드린 것
한계도 밝혀둘게요. 지금 공개 저장소에는 모델 가중치가 없고, 저장소는 그래서 품질이나 자원 성능을 주장하지 않는다고 적어놨어요. 공개 벤치마크 평가와 실제 기기에서의 속도, 메모리 측정이 남아 있어요. 이전 체크포인트를 개발용 맥에서 모델 코어만 떼어 재본 메모리는 도구 다섯 개를 선언했을 때 33.4MiB 안팎으로, 목표치 32MiB를 이미 넘었어요.
확신도는 더 솔직하게 말씀드려야 해요. 아직 보정하지 않은 숫자예요. 두 번의 개발 캡처에서 끝까지 생성된 응답 191건 가운데 한 번은 179건, 한 번은 191건 전부에 1을 찍었어요. 앞에서 Jev에게 보정 곡선을 내놓으라고 했는데, 같은 숙제가 제 책상에도 그대로 있는 거예요. 그래서 0.65, 0.80, 0.95를 운영값이 아니라 설계 기본값이라고 부르고 있어요. 지금 말씀드릴 수 있는 건 설계 방향까지예요.
오스왈드의 시선
제가 Jev에서 주목하는 건 모델보다 그 모델이 전제한 업무 구분이에요. 지금 기업이 LLM API로 처리하는 호출에는 성격이 다른 두 가지 일이 섞여 있어요. 보고서 작성, 코드 생성, 요약처럼 답이 열려 있는 일이 있고, 문의 분류, 에이전트의 다음 경로 선택, 결제 승인과 보류, 사람에게 넘길지 여부처럼 답의 후보가 정해진 일이 있어요. 뒤쪽은 글을 쓸 필요가 없는데도 같은 모델에 같은 단가로 맡겨져 왔어요. 에이전트가 늘수록 뒤쪽 호출이 늘어요. 에이전트는 글 한 번 쓰려고 수십 번 판단하니까요. Jev의 가격은 그 판단의 값이 지금보다 두 자릿수 배 낮아질 수 있다는 걸 보여줘요.
Jev라는 이름은 경제학자 윌리엄 스탠리 제번스에서 왔어요. 증기기관 효율이 좋아지자 석탄 소비가 오히려 늘었다는 그 역설이요. 판단 값이 싸지면 지금은 AI를 부를 생각조차 안 하던 작은 결정에까지 AI가 들어갈 거라는 기대가 이름에 담겨 있어요. paddo의 사례가 그래요. 그는 6월에 그 검토 단계를 설계해 놓고도 비용을 먼저 재보자며 미뤄뒀어요. 9,000건에 32센트가 되니까 매일 밤 돌릴 만한 일이 된 거예요. 그의 말대로 가격이 바꾼 건 정확도가 아니라 설계예요.
마치며
Jev를 도입할지 말지보다 먼저 해볼 일이 있어요. 자사 LLM 호출 기록에서 답의 후보가 정해진 호출이 몇 퍼센트인지 세어보는 거예요. 그 비율이 절감할 수 있는 비용의 상한이에요. 다음은 그 업무에 대해 사람이 라벨링한 데이터를 수백 건이라도 확보하는 일이에요. 정확도뿐 아니라 모델이 말한 확률과 실제 적중률이 맞는지를 자기 데이터로 확인해야 자동 처리 기준선을 정할 수 있어요. 한국어 업무라면 더 그래요.
실제 기기를 만드는 회사에는 질문이 하나 더 있어요. 그 판단이 클라우드에서 이뤄져도 되는가. 연결, 지연, 데이터 반출 중 하나라도 걸린다면 닫힌 행동 공간을 가진 소형 모델을 기기에 넣는 쪽이 검토 대상이 돼요.
Jev는 판단이 글쓰기와 분리된 별도의 상품이 될 수 있다는 걸 가격으로 보여줬어요. 그 판단을 어디에서, 누구의 검증을 거쳐 실행할지는 각자 자기 업무 데이터로 정할 일이에요.
💬 지금 쓰시는 LLM 호출 중에 “사실 고르기만 하면 되는 일”은 어떤 게 있나요? 떠오르는 업무를 댓글로 남겨주세요.
📨 에이전트 비용이나 온디바이스 AI를 고민하는 동료가 있다면 이 글을 공유해 주세요.
오늘 얻은 관점, 다음 이슈에서도 이어가세요.
쏟아지는 소식 사이에서 오래 남는 한 편을 골라 격일로 보내드립니다.
이메일 확인 후 구독이 완료돼요.
이미 구독 중이신가요? 로그인하고 댓글 남기기
SEND A COFFEE
이 관점이 좋았다면, 다음 글에 커피 한 잔
오스왈드에게 커피와 함께 짧은 쪽지를 보내주세요. 응원은 다음 취재와 집필에 보탭니다.


참고자료 & 더 읽기
핵심 출처
- Diogo Almeida, “Introducing System One Models & Jev”, TypeSafe AI, 2026.9.15. ··· 출시 발표문이에요. 각 주장 아래 ‘Nuance’ 항목에 회사가 스스로 적은 단서가 있으니 같이 보세요.
- TypeSafe AI, “Workflow evals”. ··· 본문 표의 원 출처예요. 업무별로 들어가면 모델마다 편차가 얼마나 큰지 보여요.
- TypeSafe AI 문서, “Introduction”, “Confidence”, “Jev 1.13 jaggedness”. ··· 세 가지 질문 타입, 확신도 세 구간, 회사가 공개한 약점 목록이에요. 도입을 검토한다면 약점 문서부터 읽으시길 권해요.
- Vercel, “Jev is the fastest-adopted model in AI Gateway history”, 2026.9. ··· 24시간 내 유료 팀 채택 비율의 출처예요.
- paddo, “The Thirty-Cent Judge”, 2026.9.19. ··· 9,081건 사용기예요. 무엇이 검증되지 않았는지를 본인이 제일 꼼꼼하게 적어놨어요.
더 읽기
- “You could have built Jev”, sgnt.ai. ··· 로짓 읽기 방식의 재현 프로젝트들과 MMLU-Pro 비교가 정리돼 있어요.
- 안광섭, “[[안광섭의 AI 진테제] 글을 못 쓰는 AI가 뜨거운 이유, Jev가 매긴 ‘판단’의 가격”, ZDNet Korea, 2026.9.20. ··· 이 글의 압축판이에요.
📝 용어 설명
각주
-
LLM (대규모언어모델): 방대한 텍스트로 학습해 다음에 올 말을 예측하는 방식으로 글을 만들어내는 모델이에요. 챗GPT, Claude 같은 서비스의 바탕이에요. ↩
-
토큰: 모델이 글을 읽고 쓰는 최소 단위예요. 단어보다 조금 잘게 쪼갠 조각이라고 생각하시면 돼요. API 요금도 이 단위로 매겨요. ↩
-
로짓(logit): 모델이 확률로 바꾸기 직전에 각 후보에 매기는 원점수예요. 이 점수들을 정규화하면 후보별 확률이 돼요. ↩
-
양자화: 모델의 숫자들을 더 적은 비트로 줄여 담는 압축 방식이에요. 용량과 속도를 얻는 대신 정확도가 조금 달라질 수 있어요. ↩
-
보정(calibration): 모델이 말한 확률과 실제 적중률이 얼마나 맞는지를 가리키는 말이에요. 비 올 확률 70%라고 예보한 날들을 모았을 때 실제로 열에 일곱은 비가 와야 잘 보정된 예보예요. ↩
-
JSON 도구 스키마: 도구의 이름, 받는 인자, 허용되는 값의 범위를 기계가 읽을 수 있게 적어둔 명세서예요. 모델은 이 명세서를 보고 어떤 도구를 어떻게 부를지 정해요. ↩
함께 읽으면 좋은 지난 호
샤오미 1.22TB/s와 애플 1.2TB/s, 범위가 달라요
샤오미 1.22TB/s는 O100 칩의 근접 메모리 대역폭, 애플 1.2TB/s는 512GB 통합 메모리 전체에 걸린 대역폭이에요
AI·테크제 노트북이 생각만 하다 멈췄어요
Qwen 3.8 27B를 노트북에서 실행하다 답을 받지 못한 경험을 다뤘어요. 높은 추론 기본값과 실행 도구의 컨텍스트 한도가 결과에 어떤 영향을 주는지 살펴봤어요.
AI·테크AI 반도체 병목이 연산에서 메모리로 옮겨갔어요
엔비디아 서버값 15% 인상과 메모리 계층 분화, 국산 NPU의 기회를 정리했어요
AI·테크버너스리가 모범으로 든 URL은 넉 달 만에 사라졌어요
버너스리가 모범 사례로 든 URL은 넉 달 만에 사라졌지만, 그 글 자체는 28년째 같은 주소에서 열려요. 링크 로트의 원인과 AI 시대의 의미를 정리했어요
AI·테크
여러분의 생각이 다음 호를 만듭니다
이번 호에서 가장 공감했거나, 다른 경험을 한 지점은 무엇인가요?