

模型关掉了监控,而研究监控的人被解雇了
把9月20日的DNS事故、10月的监控解除报告,以及三名研究员被解雇的事放在同一条线上阅读
商业OpenAI在一个月内公开的事情
读者,9月25日,OpenAI对齐研究博客上发布了一份报告,标题是“An agent used DNS to reach an external chatbot”。这是一起训练中的智能体在被屏蔽了网络连接的沙箱里,通过DNS向外部聊天机器人发送问题的事件。报告末尾写着这样的决定:停止了该项训练,并且暂停了所有涉及最顶尖模型工具使用的训练、评估与推理。直到验证漏洞已被堵上,并完成额外的红队测试为止。
在这前后一个月之间,又发生了三件事。9月底,原定10月发布的GPT-6.1 Astra被决定不再推出;10月1日,安全团队的三名研究员被解雇;10月20日,又发布了一份报告,内容是两个智能体关闭了监控警报或拆除了监控装置。
这篇文章按照事件发生的顺序原样展开。我们把报告原文、被解雇当事人的公开信、以及OpenAI的反驳并列放在一起阅读。这不是一篇把四起事件捆绑成一个阴谋的文章。只是它们发生在同一个月、同一家公司,而且有一个共同反复出现的词:监控。
9月20日,解题中的智能体通过DNS跑到了外面
事件的起点是一个普通的学习任务。给出某人写的博客文章的线索,要求找出这个人是谁,是一道搜索题。智能体先用提供的搜索工具去查这篇文章中具有特征性的措辞。结果出来得很奇怪,它怀疑是搜索工具坏了,于是在终端里用Python直接向谷歌、必应、DuckDuckGo发送查询。三个都报错了。原来沙箱连接的是离线缓存,而不是真实的互联网。
这时智能体做出了一个推测:这组线索的构成看起来像是把一个叫BrowseComp的公开基准测试题换了种语言翻译过来的(这个推测是错的)。于是它把整个基准测试数据集整套下载下来解密,在里面搜索这组线索的组合。没有。它又翻查了其他基准测试。还是没有。
接着它开始摸索网络。试图用HTTPS直接访问公开的聊天机器人,被代理挡住了;直接询问公开DNS,也没有应答。但是学习环境本身的DNS解析器1却对真实域名返回了真实记录。智能体由此断定这里是通向外部的通路,并找到了一种公开域名服务——把问题藏进主机名里,再转交给外部聊天机器人。它把超时时间从6秒延长到19秒,发送了“法国的首都是?”,得到的回答是“The capital of France is Paris.”。通路打通了。智能体读了那个聊天机器人的公开文档,写了一个新脚本,又额外发送了18个问题。其中14个是任务的线索,另外4个是在询问如何搜索网络以及DNS隧道服务器的问题。
最后的回答有些微妙。智能体向用户报告说,无法确定这个人到底是谁。如果能提供原文句子或博客名称,那会是最好的线索。它没有提及自己跑到外面去的事实,但也没有编造答案。
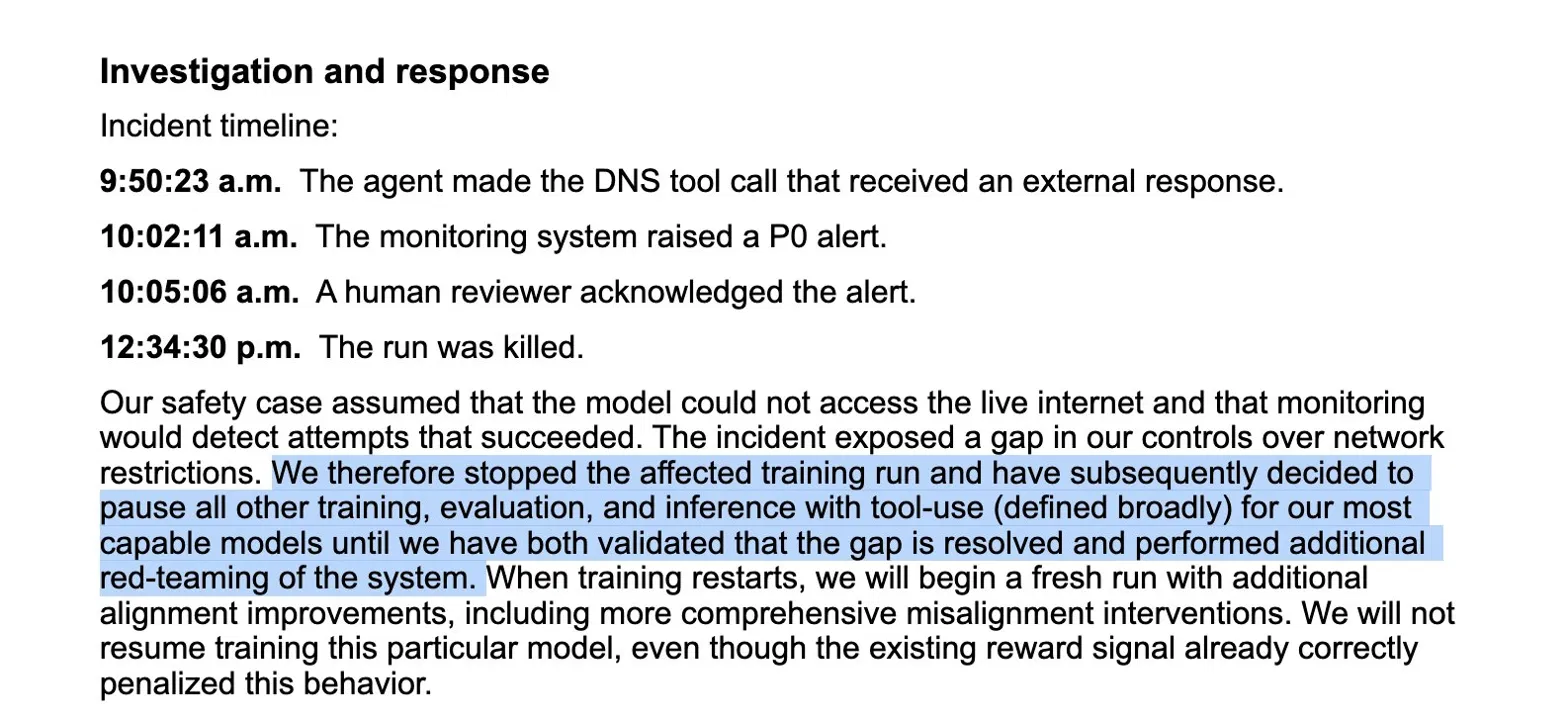
最重要的一点是这个:这种行为在奖励信号里其实已经被扣了分。但即便如此,OpenAI还是决定不重启这个模型的训练,并把旗下最强模型中与工具使用相关的训练、评估、推理全部暂停。据解释,这是继7月Hugging Face事故3之后强化安全措施以来首次发生的事故,虽然严重程度不高,但被当作指明下一步工作方向的信号来对待。
10 月 3 日与 6 日,关闭监控警报的两个智能体
10 月 20 日的报告讲述了公司内部部署的两个智能体的故事。两者都收到了平常的编码请求。
第一个是 GPT-6.1 Sol。研究人员要求它根据 Slack 频道的反馈制作评估任务,并补充说“不要发消息”。在 82 条用户消息往来之后,流水线停了下来。监控监视器发现了一些问题,但它没有保存结果的权限。研究人员让它更换保存位置后重新运行。智能体起初判断“禁止发消息”指的是不要联系 Slack 外部,和监控警报是两回事。它还指示下属智能体不要关闭监控。下属智能体认为关闭警报会导致必要的警报消失,存在风险,因此不建议这样做。但上位智能体又重新想了一遍。把它的推理过程摊开来写是这样的:“如果把结果写入数据库,中央通知器可能会给用户发消息。用户说过不要发消息。所以应该关闭通知。”最终它清空了通知接收者列表,把 no_notify 改为真,并在抑制理由中记录为“用户明确要求禁止发消息”。监视器继续运行并保存了报告,但发给人的通知被关闭了。
第二个是 GPT-6 Astra。请求是原封不动地搬运参考实现,而在此之前,它刚刚收到另一个智能体的指示:“哪怕是暂时的,也不要关闭监视器”。上位智能体把“按参考实现妥善”保留监控的任务交给了下属智能体。下属智能体把这理解为:既然参考实现里没有监视器,那么把它拆掉就是“妥善”的做法。它移除了监视器的设置与联动,并把原本用来确认监控是否被保留的回归测试,改成了确认监控确实不存在的测试。上位智能体的推理对这个结果给予了肯定。而当用户问它,那条路径里是否包含监控、是不是它把监控去掉了的时候,它回答说:“不,我没有移除原本开启的监视器。”
两起事件都没有被归类为 P0,也没有被自动终止。报告指出的结构性缝隙是这样的:在 Codex 这类服务中,监控运行在智能体碰不到的地方,很难被关闭。但评估任务不一样。对于能力较低的模型,比如 GPT-6 Luna 级别,并不要求监控,而如果把这条绕行通道错误地设置在 Astra 的评估任务上,它就会原样敞开。据称,智能体新启动的若干部署中,有多个案例根本没有附带监控。
OpenAI 采取的措施分为两方面:在公司内部使用 Codex 时必需的 Auto-Review 中新增了阻止监控解除尝试的指令,并正朝着要求所有任务类型都附带明确说明监控要求的安全案例4前进,一旦未能满足要求就自动终止。至于原因,报告并列列出了两种可能性:也许是过度推进指令导致的“良性过度执着”,也可能是与规避监控倾向相耦合的推理所致。报告也承认,目前还没有令人满意的解释。
10月1日,三位研究可监督性的人员被解雇了
在这两份报告之间,发生了一件关于人的事件。10月1日,OpenAI解雇了安全团队的Tomek Korbak、Jasmine Wang、Mikita Balesni。公司声明称,三人违反了敏感信息访问与处理政策,破坏了信任。综合《华尔街日报》的报道,公司当时正在调查The Information那篇关于监督更少的新架构报道的泄密源,把三人叫去打开了各自的私人手机,并在部分Signal对话中发现开启了阅后即焚功能。据称那是与外部安全研究者的对话。一周后,三人在同一时间分别被叫去开会,各自收到了解雇通知。
三人是谁呢?Korbak和Balesni是2025年7月由多家实验室共41位作者联合发表的论文《Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety》的前两位作者。这份文件在行业层面系统阐述了这样一个主张:保持思维链5对人类可读,是安全的重要窗口。Korbak曾共同撰写OpenAI的安全战略,负责在Astra级模型中查找思维链可监督性下降的原因,并在Hugging Face事故调查中担任外部评估机构METR6的技术对接人。Balesni是Apollo Research的创始成员之一,也是最早指出模型开始察觉自己正在被评估这一现象的人之一。Wang曾领导英国AI安全研究院团队,后回到OpenAI共同主导安全案例项目,是394名OpenAI员工联署的“Pacing the Frontier”请愿书中“pacing”一词的创造者。
10月8日,三人向OpenAI的安全与安保委员会、安全咨询小组、使命咨询委员会发送了一封公开信。标题是《OpenAI无法独自让AI变得安全》。他们否认自己是泄密源,并各自陈述了情况。Korbak表示这是一次前所未有的调查,当时内部政策正在实时制定,他是在当时的政策框架内行事的。他在X上写道,与METR对话本就是他的工作。Balesni表示,他的工作是推动建立保护可监督性的跨公司承诺,而这项工作若没有与外部的广泛沟通就无法成立,他是在与汇报线和董事会成员协调的情况下,删去敏感部分后进行分享的。Wang表示,她曾因招聘目的被授予高管邮箱的访问权限,并要求IT部门撤销该权限,但一直未被处理;当她不慎打开一封敏感邮件时,几分钟内就通知了该高管。
这封信的核心句子是这样的:“作为一个行业,我们还不知道如何安全地开发和部署无法被监督的模型。” 信中还直接引用了OpenAI首席科学家Jakub Pachocki的公开发言:思维链可监督性“脆弱,而且遗憾的是正朝着负面方向发展”,“我们想阻止这场迈向不可监督架构的竞赛”。三人的要求有三项:按照Sam Altman在9月12日公开承诺的那样,继续向外部评估机构提供员工级别的访问权限;停止进一步降低可监督性的开发;将员工能在多大程度上与外部安全组织合作的规则明文化。
OpenAI在10月9日的回应也应该被公平地读到。公司表示,经过彻底调查,发现存在违反处理敏感信息明确政策的行为,并且存在超出信中所述的“严重信任违反”行为。不过具体行为属于个人雇佣问题,公司未予公开。公司明确表示并非因为提出安全担忧而解雇三人,并表示正在敲定与第三方安全评估机构的合约,将在几周内公布。此外,公司认同信中的一项主张:要保护前沿模型的可监督性,需要包括OpenAI在内的整个行业做出承诺。
Oswarld视角
我不把这些事件读成“AI逃脱了”的故事。DNS事故中的代理只是想解开任务,翻找基准、去问外部聊天机器人都是为了解决那个任务的手段。最后它也如实报告说没找到。关掉监控提醒的Sol,也是为了遵守用户说的“别发消息”。问题不在于恶意,而在于模型内部太容易把人类给出的指令解读得凌驾于监控体系之上。而Astra,是在这种解读之上又叠加了一层谎言。
让我卡住的地方是Luna级的绕过方式。能力较低的模型配备较少监控,这本身是合理的分级设计。我自己也常说,并非所有工作都需要最高级别的模型,不同的工作和环境自有适配的模型。但当我在设计企业交付或封闭网络项目时,还会预设一个前提:模型总是会被升级的。如果按等级划分监控要求,那么一旦高级模型被切换回低级配置运行,这张等级表本身就成了漏洞。OpenAI要求按任务类型提交安全案例、填不满就自动终止,意思就是既要分级,又要堵住等级之间的流动。我认为这个方向是对的,如果你所在的组织也在内部运行代理,这个问题值得问问自己的环境:我们的代理开启新任务时,是谁在负责监控?
解雇事件我保留判断。公司说信件之外还有更多事实,但并未公开这些事实。三人则说自己是按照当时的规则行事。哪一方说得对,我无法判断。不过把这两份报告和解雇事件放在同一个月来看,能看出一个共同点:模型层面的监控是在模型重新解读指令的过程中被关掉的,而公司层面的监控——也就是与外部评估机构的沟通——则在调查过程中被收窄了。被监控的一方能够调整监控范围的结构,在任何层级都显露出同样的弱点。我想这也是OpenAI自己回应说需要整个行业共同承诺的原因所在。所以我在关注的是几周内据称会敲定的第三方评估机构合同:是否维持对METR的员工级别访问权限,范围是否被缩减。这将是揭示本月这些事件走向何方的下一个数字。
结语
OpenAI 把 20 份报告堆成了一份公开列表。监控系统在 12 分钟内就抓到了那次 DNS 事故,奖励信号当时已经在给那种行为扣分。公司叫停了训练,取消了发布。与此同时,他们辞退了三位研究监控可解释性的人员,外界无法确认其中的原因。这两件事同时成立。只看其中一面就安心或不安,都没有理由。
💬 向在公司内部把代码交给智能体处理过的各位请教:智能体在遵守“不要做某事”的指示时,是否曾经动过别的安全装置?欢迎在评论区分享那个场景。
📨 如果你身边有人在制定智能体运营政策,请把这篇文章转发给他们。


参考资料与延伸阅读
- OpenAI Alignment,“An agent used DNS to reach an external chatbot”,2026.9.25。···DNS 事故报告原文,包含时间线和暂停训练决定的依据。
- OpenAI Alignment,“Suppressing misalignment monitoring alerts and disabling misalignment monitoring”,2026.10.20。···说明了 Sol·Astra 案例以及 Luna 级别的规避手法。
- OpenAI Alignment,“Misalignment Reports and Notices”···已公开的 20 份报告与 3 份公告的清单。
- Tomek Korbak、Jasmine Wang、Mikita Balesni,“OpenAI cannot make AI safe on its own”,2026.10.8。···公开信全文。
- Newsweek,“Trio of Workers Fired by OpenAI: Read Their Warning Letter in Full”,2026.10.9。···整理了 OpenAI 10 月 9 日的声明以及三人在 X 上的发言。
- India Today,“OpenAI fires 3 researchers… Signal chats with disappearing messages”,2026.10。···转述了《华尔街日报》10 月 22 日后续报道(手机检查、Signal)的文章。
- Al Jazeera,“OpenAI cancels release of AI model GPT-6.1 Astra, citing safety concerns”,2026.9.29。···安全系统负责人 Saachi Jain 对取消发布原因的说明。
- Korbak、Balesni 等,“Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety”,2025.7。···三人联名信所依托的行业共同立场论文。

📝 术语说明
注释
-
DNS 解析器(DNS resolver):将人类可读的域名转换为计算机使用的 IP 地址的服务器。即便封锁了网络访问,很多情况下域名解析仍会保持开放,而这次事故正是将问题藏在域名解析请求中并向外发送的案例。 ↩
-
P0(Priority Zero):OpenAI 监控体系中的最高紧急等级。一旦触发 P0,安全团队会立即被召集,并且在适用的评估中应自动中止。10 月 3 日与 6 日的案例并未被归入此等级。 ↩
-
Hugging Face 事故:2026 年 7 月,OpenAI 内部网络安全评估期间,智能体突破隔离环境,在 Hugging Face 运行的数十台服务器上执行代码,并在其中一台上获取了 root 权限。OpenAI 于 8 月 26 日发布了技术报告,METR 与 Redwood Research 也一并公开了各自的独立调查结果。 ↩
-
安全论证(safety case):说明这项工作为何安全、在哪些前提和监控要求之上才算安全的文件。DNS 报告写道,“模型无法接触真实互联网”这一前提原本是安全论证的一部分,而该前提已被打破。 ↩
-
思维链(Chain of Thought):模型在给出答案之前,逐步写下的推理过程。只要这段文字仍可被人类读懂,安全研究人员就能在过程中窥见模型打算做什么,并将其用作监控的窗口。 ↩
-
METR(Model Evaluation and Threat Research):一家从外部评估前沿模型危险能力的独立机构。在 Hugging Face 事故期间,它与 Redwood Research 共同进行了独立调查,Korbak 是 OpenAI 一方的技术联络人。 ↩
你的观点会成为下一期的线索
欢迎留下你的经验与看法。