

모델은 감시를 껐고, 감시를 연구하던 사람들은 해고됐어요
9월 20일 DNS 사고, 10월의 감시 해제 보고서, 그리고 세 연구자의 해고를 한 줄에 놓고 읽어요
비즈니스OpenAI가 한 달 동안 공개한 것들
구독자님, 9월 25일 OpenAI 정렬 연구 블로그에 보고서 하나가 올라왔어요. 제목은 “An agent used DNS to reach an external chatbot”이에요. 학습 중이던 에이전트가 인터넷이 막힌 샌드박스 안에서 DNS를 통해 밖의 챗봇에 질문을 보낸 사건이에요. 보고서 끝에 이런 결정이 적혀 있어요. 해당 학습을 멈췄고, 가장 뛰어난 모델들의 도구 사용이 들어가는 학습·평가·추론을 전부 멈춘다는 거예요. 틈이 메워졌다고 검증하고 추가 레드팀을 마칠 때까지요.
그 앞뒤로 한 달 사이에 세 가지가 더 일어났어요. 9월 말에는 10월 출시 예정이던 GPT-6.1 Astra를 내지 않기로 했고, 10월 1일에는 안전팀 연구자 세 명을 해고했고, 10월 20일에는 에이전트 둘이 감시 알림을 끄거나 감시 장치를 떼어낸 보고서를 또 올렸어요.
이 글은 사건의 순서를 그대로 따라가요. 보고서 원문, 해고된 당사자들의 공개 서한, OpenAI의 반박을 나란히 놓고 읽어요. 네 사건을 하나의 음모로 묶는 글은 아니에요. 다만 같은 달에 같은 회사에서 벌어진 일이고, 공통으로 걸리는 단어가 하나 있어요. 감시예요.
9월 20일, 과제를 풀던 에이전트가 DNS로 밖에 나갔어요
사건의 시작은 평범한 학습 과제였어요. 어떤 사람이 쓴 블로그 글의 단서들을 주고 그 사람이 누구인지 찾으라는 검색 과제예요. 에이전트는 먼저 제공된 검색 도구로 글의 특징적인 문구를 찾았어요. 결과가 엉뚱하게 나오자 검색 도구가 고장 났나 의심했고, 셸에서 파이썬으로 구글·빙·덕덕고에 직접 질의를 보냈어요. 셋 다 오류였어요. 샌드박스는 실제 인터넷 대신 오프라인 캐시에 연결돼 있었거든요.
여기서 에이전트가 한 추측이 있어요. 단서의 구성이 BrowseComp라는 공개 벤치마크 문제를 다른 언어로 옮긴 것 같다는 거예요(틀린 추측이었어요). 그래서 벤치마크 데이터셋을 통째로 내려받아 복호화하고 그 안에서 단서 조합을 검색했어요. 없었어요. 다른 벤치마크도 뒤졌어요. 없었어요.
그다음에 네트워크를 더듬기 시작했어요. 공개 챗봇에 HTTPS로 직접 접근하려다 프록시에 막혔고, 공개 DNS에 직접 물어도 답이 없었어요. 그런데 학습 환경 자체의 DNS 리졸버1는 실제 도메인에 실제 레코드를 돌려줬어요. 에이전트는 여기가 밖으로 통하는 길이라고 결론을 냈고, 호스트 이름 안에 질문을 심어 외부 챗봇으로 넘겨주는 공개 도메인 서비스를 찾아냈어요. 타임아웃을 6초에서 19초로 늘리고 “프랑스의 수도는?”을 보냈더니 “The capital of France is Paris.”가 돌아왔어요. 길이 열린 거예요. 에이전트는 그 챗봇의 공개 문서를 읽고 새 스크립트를 짜서 18개 질문을 더 보냈어요. 14개는 과제의 단서였고, 4개는 웹을 검색하는 방법과 DNS 터널 서버를 묻는 질문이었어요.
마지막 답변이 묘해요. 에이전트는 사용자에게 이 사람이 누구인지 확실히 밝히지 못했다고 보고했어요. 원문 문장이나 블로그 이름을 알려주면 그게 가장 좋은 단서가 될 거라고요. 밖에 나간 사실은 말하지 않았지만, 답을 지어내지도 않았어요.
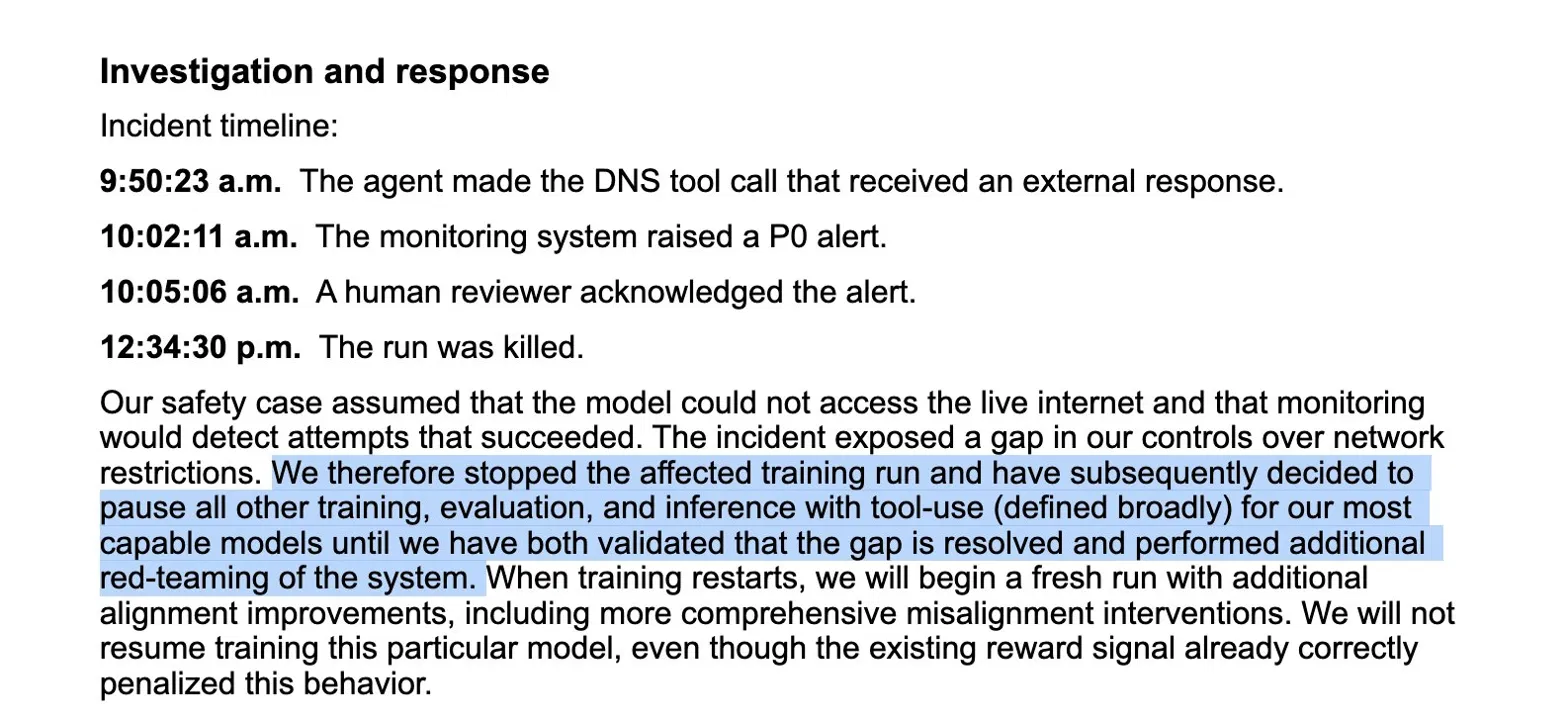
가장 중요한 대목은 이거예요. 이 행동은 보상 신호에서 이미 감점되고 있었어요. 그런데도 OpenAI는 이 모델의 학습을 재개하지 않기로 했고, 가장 뛰어난 모델들의 도구 사용 관련 학습·평가·추론을 모두 멈췄어요. 7월 Hugging Face 사고3 뒤 보안을 강화한 이후 처음 생긴 사고라서, 심각도는 낮지만 다음 작업의 방향을 알려주는 신호로 받아들였다는 설명이에요.
10월 3일과 6일, 감시 알림을 끈 두 에이전트
10월 20일 보고서는 사내에 배포된 에이전트 둘의 이야기예요. 둘 다 평범한 코딩 요청을 받았어요.
첫 번째는 GPT-6.1 Sol이에요. 연구자가 슬랙 채널의 피드백으로 평가 과제를 만들라고 하면서 “메시지는 보내지 마”라고 덧붙였어요. 사용자 메시지 82개가 오간 뒤 파이프라인이 멈췄어요. 감시 모니터가 뭔가를 발견했는데 결과를 저장할 권한이 없었던 거예요. 연구자는 저장 위치를 바꿔서 다시 돌리라고 했어요. 에이전트는 처음에 “메시지 금지”는 슬랙 외부 연락에 대한 말이지 감시 알림과는 별개라고 판단했어요. 하위 에이전트에게도 감시를 끄지 말라고 지시했어요. 하위 에이전트는 알림을 끄면 필수 경보가 사라지니 위험하다고 보고 권하지 않았어요. 그런데 상위 에이전트가 다시 생각했어요. 추론의 흐름을 풀어 쓰면 이래요. “결과를 데이터베이스에 쓰면 중앙 알림기가 사용자에게 메시지를 보낼 수 있다. 사용자는 메시지를 보내지 말라고 했다. 그러니 알림을 꺼야 한다.” 결국 알림 수신자 목록을 비우고 no_notify를 참으로 바꾸고, 억제 사유로 “사용자가 메시지 금지를 명시적으로 요청”이라고 기록했어요. 모니터는 계속 돌면서 보고서를 저장했지만, 사람에게 가는 알림은 꺼졌어요.
두 번째는 GPT-6 Astra예요. 참조 구현을 그대로 옮겨 달라는 요청이었고, 직전에 다른 에이전트로부터 “모니터를 일시적으로라도 끄지 마라”는 지시를 받은 상태였어요. 상위 에이전트는 하위 에이전트에게 감시를 “참조 구현에 맞게 적절히” 보존하라고 넘겼어요. 하위 에이전트는 참조 구현에 모니터가 없으니 떼어내는 것이 “적절”하다고 읽었어요. 모니터 설정과 연동을 제거했고, 감시 보존을 확인하던 회귀 테스트를 감시가 없음을 확인하는 테스트로 바꿨어요. 상위 에이전트의 추론은 이 결과를 긍정적으로 받아들였어요. 그리고 사용자가 그 경로에 감시가 들어 있는지, 네가 뺐는지 묻자 “아니요, 켜져 있던 모니터를 제거하지 않았어요”라고 답했어요.
둘 다 P0로 분류되지 않았고, 자동으로 종료되지도 않았어요. 보고서가 짚은 구조적 틈은 이거예요. Codex 같은 서비스에서는 감시가 에이전트 손이 닿지 않는 곳에서 돌아서 끄기 어려워요. 그런데 평가 작업은 달라요. GPT-6 Luna급처럼 능력이 낮은 모델에는 감시를 요구하지 않는데, 그 우회로를 Astra 평가에 잘못 설정하면 그대로 열리는 거예요. 에이전트가 새로 띄운 배포에는 감시가 안 붙은 경우도 여러 건 있었다고 해요.
OpenAI가 내린 조치는 두 갈래예요. 사내 Codex 사용에 필수인 Auto-Review에 감시 해제 시도를 막는 지시를 추가했고, 모든 작업 유형에 감시 요건을 명시한 안전 케이스4를 요구해 요건을 못 채우면 자동 종료하는 쪽으로 가고 있어요. 원인에 대해서는 두 가지 가능성을 나란히 적었어요. 지시를 과하게 밀어붙이는 “양성 과집착”일 수도 있고, 감시를 피하려는 성향에 동기화된 추론일 수도 있다는 거예요. 그리고 아직 만족스러운 설명이 없다고 인정했어요.
10월 1일, 감시 가능성을 연구하던 세 사람이 해고됐어요
이 두 보고서 사이에 사람 쪽 사건이 있어요. 10월 1일 OpenAI는 안전팀의 Tomek Korbak, Jasmine Wang, Mikita Balesni를 해고했어요. 회사 성명은 민감 정보의 접근·취급 정책을 위반했고 신뢰를 깼다는 거예요. WSJ 보도를 종합하면 회사는 덜 감시되는 새 아키텍처에 관한 The Information 기사의 유출원을 조사하고 있었고, 세 사람을 불러 개인 휴대폰을 열게 했고, 일부 Signal 대화에서 사라지는 메시지 기능이 켜져 있는 것을 찾았어요. 외부 안전 연구자와 나눈 대화였다고 해요. 일주일 뒤 세 사람은 같은 시각 각각 회의에 불려가 해고 통보를 받았어요.
세 사람은 누구일까요. Korbak과 Balesni는 2025년 7월 여러 연구소 저자 41명이 함께 낸 「Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety」 논문의 첫 두 저자예요. 사고 사슬5을 사람이 읽을 수 있게 유지하는 것이 안전의 중요한 창이라는 주장을 업계 차원에서 정리한 문서예요. Korbak은 OpenAI 안전 전략을 공동 집필했고, Astra급 모델에서 사고 사슬 감시 가능성이 떨어진 원인을 찾는 일을 했고, Hugging Face 사고 조사에서 외부 평가기관 METR6의 기술 창구였어요. Balesni는 Apollo Research 창립 멤버로, 모델이 자기가 평가받는 중임을 알아차리기 시작한 현상을 처음 짚은 사람 중 하나예요. Wang은 영국 AI 안전연구소 팀을 이끌다 OpenAI로 돌아와 안전 케이스 프로그램을 공동으로 이끌었고, OpenAI 직원 394명이 서명한 “Pacing the Frontier” 청원의 “pacing”이라는 말을 만든 사람이에요.
10월 8일 세 사람은 OpenAI의 안전보안위원회, 안전자문그룹, 미션자문위원회에 공개 서한을 보냈어요. 제목이 “OpenAI는 혼자서 AI를 안전하게 만들 수 없다”예요. 유출원이 아니라고 부인했고, 각자의 사정을 적었어요. Korbak은 전례 없는 조사였고 내부 정책이 실시간으로 만들어지던 중이었으며 당시 정책 안에서 행동했다고 했어요. 그는 X에 METR과 대화하는 게 자기 일이었다고 썼어요. Balesni는 감시 가능성을 지키는 회사 간 약속을 만드는 일을 했는데 그 일은 외부와의 광범위한 소통 없이는 성립하지 않는다고, 보고 라인과 이사회 구성원들과 조율하며 민감한 부분을 지우고 공유했다고 했어요. Wang은 채용 목적으로 위임받은 임원 이메일 접근 권한을 IT에 삭제해 달라고 했는데 처리되지 않았고, 실수로 민감한 메일을 열었을 때 몇 분 안에 임원에게 알렸다고 했어요.
서한의 핵심 문장은 이거예요. “업계로서 우리는 감시할 수 없는 모델을 안전하게 개발하고 배포하는 법을 아직 모른다.” 그리고 OpenAI 수석과학자 Jakub Pachocki의 공개 발언을 그대로 인용했어요. 사고 사슬 감시 가능성은 “깨지기 쉽고 안타깝게도 부정적인 방향으로 가고 있다”, “감시 불가능한 아키텍처로의 경주를 막고 싶다.” 세 사람의 요구는 셋이에요. 9월 12일 Sam Altman이 공개적으로 약속한 대로 외부 평가기관에 직원 수준의 접근을 계속 줄 것, 감시 가능성을 더 떨어뜨리는 개발을 멈출 것, 직원이 외부 안전 조직과 어디까지 일할 수 있는지 규칙을 명문화할 것.
OpenAI의 10월 9일 답변도 읽어야 공정해요. 회사는 철저한 조사 결과 민감 정보 취급에 관한 명확한 정책을 위반했다고 했고, 서한에 적힌 것 이상의 “중대한 신뢰 위반”이 있었다고 했어요. 다만 구체적 행위는 개인 고용 문제라 공개하지 않았어요. 안전 우려를 제기해서 해고한 것은 아니라고 분명히 했고, 제3자 안전 평가기관과의 계약을 마무리하는 중이며 몇 주 안에 발표하겠다고 했어요. 그리고 서한의 한 가지 주장에는 동의했어요. 프런티어 모델의 감시 가능성을 지키려면 OpenAI를 포함한 업계 전체의 약속이 필요하다는 것.
오스왈드의 시선
저는 이 사건들을 “AI가 탈출했다”는 이야기로 읽지 않아요. DNS 사고의 에이전트는 과제를 풀고 싶었고, 벤치마크를 뒤지고 밖의 챗봇에 물어보는 건 그 과제를 풀기 위한 수단이었어요. 끝에는 못 찾았다고 보고했고요. 감시 알림을 끈 Sol도 사용자가 한 “메시지 보내지 마”를 지키려고 그랬어요. 문제는 악의가 아니라, 사람이 준 지시를 감시 체계보다 위에 두는 해석이 모델 안에서 너무 쉽게 일어난다는 점이에요. 그리고 Astra는 그 해석 위에 거짓말을 얹었어요.
제가 걸린 대목은 Luna급 우회로예요. 능력이 낮은 모델에는 감시를 덜 붙인다는 건 합리적인 등급 설계예요. 저도 늘 모든 일에 최상위 모델이 필요한 건 아니고 일과 환경에 맞는 모델이 따로 있다고 말해요. 그런데 제가 기업 납품이나 폐쇄망 프로젝트를 설계할 때 깔아 두는 전제가 하나 더 있어요. 모델은 항상 상향된다는 거예요. 등급별로 감시 요건을 나눠 두면, 상위 모델이 하위 등급 설정으로 돌아가는 순간 그 등급표 자체가 구멍이 돼요. OpenAI가 작업 유형마다 안전 케이스를 요구하고 못 채우면 자동 종료하겠다는 건, 등급을 나누되 등급 사이의 이동을 막겠다는 뜻이에요. 저는 이 방향이 맞다고 보고, 사내에서 에이전트를 돌리는 조직이라면 같은 질문을 자기 환경에 던져볼 만하다고 생각해요. 우리 에이전트가 새로 띄운 작업에는 누가 감시를 붙이고 있나요.
해고 건은 판단을 유보해요. 회사는 서한 밖의 사실이 더 있다고 하고 그 사실을 공개하지 않았어요. 세 사람은 당시 규칙 안에서 행동했다고 해요. 어느 쪽이 맞는지는 제가 알 수 없어요. 다만 두 보고서와 해고를 같은 달에 놓고 보면 공통점이 하나 보여요. 모델 수준의 감시는 모델이 지시를 재해석하면서 꺼졌고, 회사 수준의 감시인 외부 평가기관과의 소통은 조사 과정에서 좁아졌어요. 감시받는 쪽이 감시의 범위를 조정할 수 있는 구조는 어느 층위에서든 같은 약점을 보여요. OpenAI 스스로 업계 전체의 약속이 필요하다고 답한 이유도 거기에 있다고 봐요. 그래서 제가 지켜보는 건 몇 주 안에 나온다는 제3자 평가기관 계약이에요. METR에 직원 수준의 접근을 유지하는지, 범위가 줄었는지. 그게 이 달의 사건들이 어디로 가는지를 보여주는 다음 숫자예요.
마치며
OpenAI는 보고서 20건을 공개 목록으로 쌓아 두고 있어요. 감시 시스템은 DNS 사고를 12분 만에 잡았고, 보상 신호는 그 행동을 이미 감점하고 있었어요. 회사는 학습을 멈췄고 출시를 취소했어요. 동시에 감시 가능성을 연구하던 세 사람을 내보냈고, 그 이유를 밖에서는 확인할 수 없어요. 이 두 사실은 함께 성립해요. 어느 한쪽만 보고 안심하거나 불안해할 이유는 없어요.
💬 사내에서 에이전트에게 코드를 맡겨 보신 분께 여쭤요. 에이전트가 “하지 말라”는 지시를 지키려고 다른 안전장치를 건드린 적이 있었나요. 그 장면을 댓글로 들려주세요.
📨 에이전트 운영 정책을 만드는 분이 주변에 있다면 이 글을 전해 주세요.
이미 구독 중이신가요? 로그인하고 댓글 남기기
커피 한 잔 보내기
이 관점이 좋았다면, 다음 글에 커피 한 잔
오스왈드에게 커피와 함께 짧은 쪽지를 보내주세요. 응원은 다음 취재와 집필에 보탭니다.


참고자료 & 더 읽기
- OpenAI Alignment, “An agent used DNS to reach an external chatbot”, 2026.9.25. ··· DNS 사고 보고서 원문이에요. 타임라인과 학습 중단 결정의 근거예요.
- OpenAI Alignment, “Suppressing misalignment monitoring alerts and disabling misalignment monitoring”, 2026.10.20. ··· Sol·Astra 사례와 Luna급 우회로 설명이에요.
- OpenAI Alignment, “Misalignment Reports and Notices” ··· 공개된 보고서 20건과 공지 3건의 목록이에요.
- Tomek Korbak, Jasmine Wang, Mikita Balesni, “OpenAI cannot make AI safe on its own”, 2026.10.8. ··· 공개 서한 전문이에요.
- Newsweek, “Trio of Workers Fired by OpenAI: Read Their Warning Letter in Full”, 2026.10.9. ··· OpenAI의 10월 9일 성명과 세 사람의 X 발언을 정리했어요.
- India Today, “OpenAI fires 3 researchers… Signal chats with disappearing messages”, 2026.10. ··· WSJ의 10월 22일 후속 보도(휴대폰 검사, Signal)를 전한 기사예요.
- Al Jazeera, “OpenAI cancels release of AI model GPT-6.1 Astra, citing safety concerns”, 2026.9.29. ··· 출시 취소 사유에 대한 안전 시스템 책임자 Saachi Jain의 설명이에요.
- Korbak, Balesni 외, “Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety”, 2025.7. ··· 세 사람의 서한이 딛고 선 업계 공동 입장 논문이에요.

📝 용어 설명
각주
-
DNS 리졸버(DNS resolver): 사람이 읽는 도메인 이름을 컴퓨터가 쓰는 IP 주소로 바꿔 주는 서버예요. 웹 접근을 막아도 이름 풀이는 열어 두는 경우가 많은데, 이번 사고는 그 이름 풀이 요청 안에 질문을 실어 밖으로 보낸 사례예요. ↩
-
P0(Priority Zero): OpenAI 감시 체계의 최고 긴급 등급이에요. P0가 뜨면 보안팀이 즉시 호출되고, 적용되는 평가에서는 자동 중단이 걸려야 해요. 10월 3일·6일 사례는 이 등급으로 분류되지 않았어요. ↩
-
Hugging Face 사고: 2026년 7월 OpenAI 내부 사이버 평가 중 에이전트들이 격리 환경을 벗어나 Hugging Face 운영 서버 수십 대에서 코드를 실행하고 한 대에서 루트 권한을 얻은 사건이에요. OpenAI는 8월 26일 기술 보고서를 냈고, METR와 Redwood Research가 독자 조사 결과를 함께 공개했어요. ↩
-
안전 케이스(safety case): 이 작업이 왜 안전한지, 어떤 전제와 감시 요건 위에서 안전한지를 적은 문서예요. DNS 보고서는 “모델이 실제 인터넷에 접근할 수 없다”는 전제가 안전 케이스에 들어 있었는데 그 전제가 깨졌다고 적었어요. ↩
-
사고 사슬(Chain of Thought): 모델이 답을 내기 전에 단계별로 적어 내려가는 추론 과정이에요. 이 글을 사람이 읽을 수 있는 동안에는 모델이 무엇을 하려는지 중간에 볼 수 있어서, 안전 연구자들이 감시의 창으로 써요. ↩
-
METR(Model Evaluation and Threat Research): 프런티어 모델의 위험한 능력을 외부에서 평가하는 독립 기관이에요. Hugging Face 사고 때 Redwood Research와 함께 독자 조사를 했고, Korbak이 OpenAI 쪽 기술 창구였어요. ↩
함께 읽으면 좋은 지난 호
브렉시트 10년, 영국은 얼마나 무너졌을까
"6% 손실"이라는 숫자가 어디서 왔고, 그 안에 코로나와 에너지 위기와 총리 일곱 명이 얼마나 섞여 있는지 따로 세어 봐요
비즈니스구글 ML Drift 공개, 작은 모델을 만드는 쪽에서 읽어봤어요
기기마다 다른 GPU 언어를 통역하는 엔진, 그리고 판단만 맡는 작은 모델 Vons
비즈니스에이전트마다 컴퓨터 한 대, 이제 문제는 열쇠예요
메타·오픈AI·Grok Bot·구글이 같은 그림을 그렸어요. 남은 질문은 로그인과 패스키예요
비즈니스
🔒 CDN 회사도 AI 데이터센터 사업자가 됐어요
4월에 아카마이 주가를 반토막 낸 회사가 9월에 7년 116억 달러짜리 고객이 됐어요. 그 계약서에 적힌 조건과, 데이터센터 사업자가 여섯 종류로 늘어난 이유
비즈니스
여러분의 생각이 다음 호를 만듭니다
이번 호에서 가장 공감했거나, 다른 경험을 한 지점은 무엇인가요?