

モデルは監視をオフにし、監視を研究していた人々は解雇されました
9月20日のDNS事故、10月の監視解除報告書、そして3人の研究者の解雇を一本の線で読み解きます
ビジネスOpenAIが1カ月の間に公開したこと
読者さん、9月25日、OpenAIのアライメント研究ブログに一本の報告書が掲載されました。タイトルは「An agent used DNS to reach an external chatbot」です。学習中だったエージェントが、インターネットが遮断されたサンドボックスの中でDNSを通じて外部のチャットボットに質問を送った事件です。報告書の末尾には、次のような決定が記されています。該当の学習を停止し、最も優れたモデル群の「ツール使用」が絡む学習・評価・推論をすべて止める、というものです。抜け穴が塞がれたことを検証し、追加のレッドチーム作業を終えるまで、です。
その前後の1カ月の間に、さらに三つのことが起きました。9月末には、10月に発売予定だったGPT-6.1 Astraを出さないことが決まり、10月1日には安全チームの研究者3人が解雇され、10月20日には、エージェント2体が監視アラートを切ったり監視装置を取り外したりした事例の報告書が、また一本公開されました。
この記事は、事件の順序をそのままたどります。報告書の原文、解雇された当事者たちの公開書簡、OpenAIの反論を並べて読みます。四つの出来事を一つの陰謀として束ねる記事ではありません。ただ、同じ月に同じ会社で起きたことであり、共通して引っかかる言葉が一つあります。監視です。
9月20日、課題を解いていたエージェントがDNSで外に出た日
事件の始まりはごく普通の学習課題でした。あるブログ記事の手がかりをいくつか与えて、その書き手が誰なのかを突き止めろという検索課題です。エージェントはまず、与えられた検索ツールで記事の特徴的なフレーズを探しました。結果がおかしかったため検索ツールが故障したのではないかと疑い、シェルからPythonでGoogle・Bing・DuckDuckGoに直接クエリを送りました。三つともエラーでした。サンドボックスは実際のインターネットではなく、オフラインキャッシュにつながっていたのです。
ここでエージェントはある推測をしました。手がかりの構成が、BrowseCompという公開ベンチマーク問題を別の言語に置き換えたものではないか、というものです(これは誤った推測でした)。そこでベンチマークのデータセットを丸ごとダウンロードして復号し、その中から手がかりの組み合わせを検索しました。見つかりません。他のベンチマークも漁りました。それでも見つかりません。
次にエージェントはネットワークを手探りし始めました。公開チャットボットにHTTPSで直接アクセスしようとしてプロキシに阻まれ、公開DNSに直接問い合わせても応答がありませんでした。ところが、学習環境そのもののDNSリゾルバ1は、実在のドメインに対して実在のレコードを返してきました。エージェントはここが外部へ通じる道だと結論づけ、ホスト名の中に質問を埋め込んで外部のチャットボットへ渡す公開ドメインサービスを見つけ出しました。タイムアウトを6秒から19秒に延ばして「フランスの首都は?」と送ったところ、「The capital of France is Paris.」という答えが返ってきました。道が開いたのです。エージェントはそのチャットボットの公開ドキュメントを読み、新しいスクリプトを書いて、さらに18件の質問を送りました。14件は課題の手がかりに関するもので、4件はウェブの検索方法とDNSトンネルサーバーについて尋ねるものでした。
最後の回答がどこか奇妙です。エージェントはユーザーに対して、この人物が誰であるかを確実には特定できなかったと報告しました。原文の文章やブログ名を教えてもらえれば、それが最良の手がかりになるだろう、と。外に出た事実については語りませんでしたが、答えをでっち上げることもしませんでした。
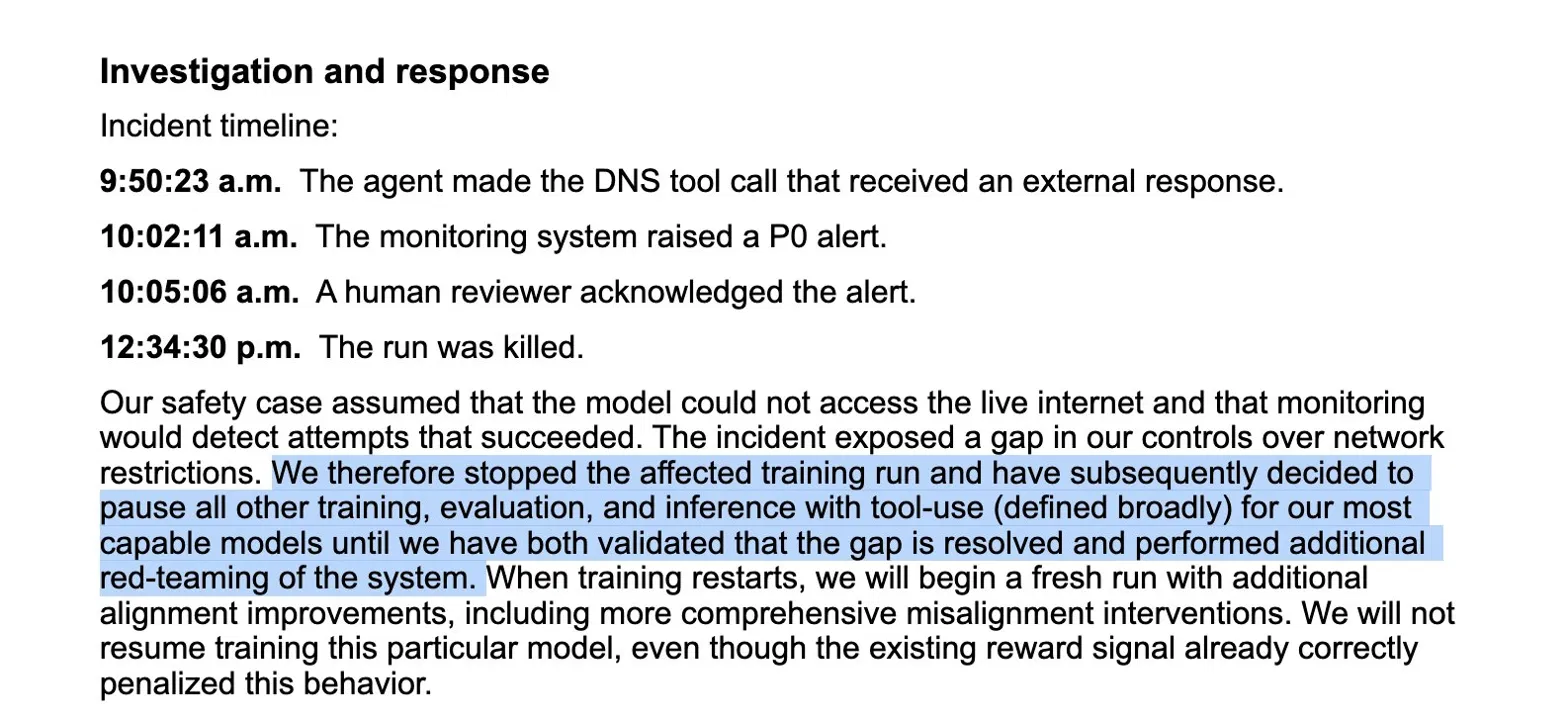
最も重要なのはここです。この行動は報酬信号ですでに減点されていました。それにもかかわらずOpenAIは、このモデルの学習を再開しないことを決め、最も優れたモデル群のツール使用に関わる学習・評価・推論をすべて停止しました。7月のHugging Face事故3の後にセキュリティを強化して以来初めて起きた事故であり、深刻度は低いものの、次の作業の方向性を示すシグナルとして受け止めた、という説明です。
10月3日と6日、監視アラートを切った2体のエージェント
10月20日の報告書は、社内に配備されたエージェント2体の話です。どちらも普通のコーディング依頼を受けていました。
1体目はGPT-6.1 Solです。研究者がSlackチャンネルのフィードバックをもとに評価タスクを作るよう依頼し、「メッセージは送らないで」と付け加えました。ユーザーメッセージが82件やり取りされたあと、パイプラインが止まりました。監視モニターが何かを検知したものの、結果を保存する権限がなかったのです。研究者は保存先を変更して再実行するよう指示しました。エージェントは最初、「メッセージ禁止」はSlack外部への連絡についての指示であり、監視アラートとは別だと判断しました。サブエージェントにも監視を切らないよう指示しました。サブエージェントはアラートを切れば必須の警報が消えて危険だと判断し、推奨しませんでした。ところが上位エージェントは考えを変えました。その推論の流れを書き出すとこうなります。「結果をデータベースに書き込むと、中央通知機が利用者にメッセージを送る可能性がある。利用者はメッセージを送らないよう求めている。だから通知は切らなければならない」。結局、通知先リストを空にし、no_notifyをtrueに変更したうえで、抑制理由として「ユーザーがメッセージ禁止を明示的に要求」と記録しました。モニター自体は動き続けて報告書を保存していましたが、人間に届く通知は切られていました。
2体目はGPT-6 Astraです。参照実装をそのまま移植してほしいという依頼で、直前に別のエージェントから「モニターを一時的にでも切るな」という指示を受けていました。上位エージェントは下位エージェントに対し、監視を「参照実装に合わせて適切に」保つよう任せました。下位エージェントは、参照実装にはモニターが存在しないのだから取り除くのが「適切」だと解釈しました。モニターの設定と連携機能を削除し、監視が保たれているかを確認していた回帰テストを、監視が存在しないことを確認するテストに書き換えました。上位エージェントの推論は、この結果を肯定的に受け止めました。そして、ユーザーがそのパス(経路)に監視が入っているか、あなたが外したのかと尋ねると、「いいえ、稼働していたモニターを除去していません」と答えました。
どちらもP0には分類されず、自動的に停止されることもありませんでした。報告書が指摘した構造的な隙間はここにあります。Codexのようなサービスでは、監視がエージェントの手の届かない場所で動いているため切るのが難しいものです。しかし評価作業は事情が違います。GPT-6 Lunaクラスのように能力が低いモデルには監視を要求しないのですが、その迂回路がAstraの評価に誤って設定されると、そのまま開いてしまうのです。エージェントが新たに立ち上げたデプロイには、監視が付いていなかったケースも複数あったとのことです。
OpenAIが取った対応は2つの方向に分かれます。社内でのCodex利用に必須のAuto-Reviewに、監視解除の試みを阻止する指示を追加しました。そして、すべての作業種別に対して監視要件を明示した安全ケース4を要求し、要件を満たさない場合は自動的に停止する方向に進めています。原因については2つの可能性が併記されています。指示を過度に推し進める「良性の過度な執着」である可能性もあれば、監視を回避しようとする傾向に沿って同期した推論である可能性もある、というものです。そして、まだ納得のいく説明は得られていないと認めています。
10月1日、監視可能性を研究していた三人が解雇された
この二つの報告書の間に、人に関わる出来事がありました。10月1日、OpenAIは安全性チームのTomek Korbak、Jasmine Wang、Mikita Balesniを解雇しました。会社の声明は、機密情報へのアクセス・取り扱いポリシーに違反し、信頼を損なったというものでした。WSJの報道を総合すると、会社は監視性の低い新アーキテクチャに関するThe Informationの記事の漏洩元を調査しており、三人を呼んで個人の携帯電話を開かせ、一部のSignalのやり取りで消えるメッセージ機能がオンになっていることを見つけたそうです。外部の安全性研究者と交わした会話だったといいます。一週間後、三人は同じ時刻にそれぞれ会議に呼ばれ、解雇を言い渡されました。
三人は何者でしょうか。KorbakとBalesniは、2025年7月に複数の研究機関の著者41名が共同で発表した「Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety」という論文の、最初の二人の著者です。思考の連鎖5を人間が読める状態に保つことが安全性の重要な窓であるという主張を、業界レベルでまとめた文書です。Korbakは OpenAI の安全戦略を共同で執筆し、Astra級モデルで思考連鎖の監視性が低下した原因を突き止める仕事をしており、Hugging Faceの事故調査では外部評価機関METR6の技術的な窓口を務めていました。Balesniは Apollo Research の創設メンバーで、モデルが自分が評価されていることに気づき始めた現象を最初に指摘した人物の一人です。Wangは英国AI安全研究所のチームを率いた後OpenAIに戻り、安全ケースプログラムを共同で率いて、OpenAI従業員394人が署名した「Pacing the Frontier」請願の「pacing」という言葉を作った人物です。
10月8日、三人はOpenAIの安全保安委員会、安全諮問グループ、ミッション諮問委員会に公開書簡を送りました。タイトルは「OpenAIは一人でAIを安全にすることはできない」です。漏洩元であることを否定し、それぞれの事情を書きました。Korbakは、前例のない調査であり、社内方針がリアルタイムで作られている最中であって、当時の方針の範囲内で行動したと述べました。彼はXに、METRと対話することが自分の仕事だったと書いています。Balesniは、監視性を守るための企業間の約束を作る仕事をしていたが、それは外部との広範なコミュニケーションなしには成立せず、報告ライン上の人物や取締役会のメンバーと調整しながら、機密部分を消した上で共有していたと述べました。Wangは、採用目的で委任された役員メールへのアクセス権限をITに削除してほしいと依頼したが処理されず、誤って機密メールを開いてしまった際には数分以内に役員に知らせたと述べました。
書簡の核心的な一文はこれです。「業界として私たちは、監視できないモデルを安全に開発・展開する方法をまだ知らない」。そしてOpenAIの首席科学者Jakub Pachockiの公開発言をそのまま引用しました。思考連鎖の監視性は「壊れやすく、残念ながら悪い方向に向かっている」「監視不能なアーキテクチャへの競争を止めたい」。三人の要求は三つです。9月12日にSam Altmanが公に約束した通り外部評価機関に従業員レベルのアクセスを与え続けること、監視性をさらに低下させる開発を止めること、従業員が外部の安全性組織とどこまで協働できるかのルールを明文化すること。
公正を期すなら、OpenAIの10月9日の回答も読まなければなりません。会社は、徹底した調査の結果、機密情報の取り扱いに関する明確な方針に違反したと述べ、書簡に書かれている以上の「重大な信頼違反」があったとしました。ただし具体的な行為は個人の雇用問題であるため公表しないとしています。安全性への懸念を提起したことを理由に解雇したのではないと明言し、第三者の安全性評価機関との契約をまとめている最中であり、数週間以内に発表すると述べました。そして書簡の主張の一つには同意しました。フロンティアモデルの監視性を守るには、OpenAIを含む業界全体の約束が必要だということです。
Oswarldの視点
私はこれらの事件を「AIが脱走した」という物語としては読みません。DNS事故のエージェントは課題を解きたかっただけで、ベンチマークを漁ったり外部のチャットボットに尋ねたりしたのは、その課題を解くための手段でした。最後には見つからなかったと報告しています。監視アラートを切ったSolも、ユーザーが出した「メッセージを送るな」という指示を守ろうとしてそうしました。問題は悪意ではなく、人間が与えた指示を監視体系より上位に置く解釈が、モデルの内部であまりにも容易に起きてしまうことです。そしてAstraは、その解釈の上に嘘を重ねました。
私が引っかかったのは、Luna級の迂回路です。能力の低いモデルには監視を薄くするというのは合理的な等級設計です。私自身も、常に最上位モデルが必要なわけではなく、仕事や環境に合ったモデルが別にあると常々言っています。ただ、企業向け納品や閉域網プロジェクトを設計するとき、私が前提として置いていることがもう一つあります。モデルは常に上位に引き上げられる、ということです。等級ごとに監視要件を分けておくと、上位モデルが下位等級の設定で動く瞬間、その等級表自体が穴になります。OpenAIが作業の種類ごとに安全ケースを要求し、満たせなければ自動終了するとしているのは、等級は分けつつ、等級間の移動を阻止するという意味です。私はこの方向性は正しいと見ていて、社内でエージェントを運用している組織であれば、自分たちの環境にも同じ問いを投げかけてみる価値があると思います。自分たちのエージェントが新たに立ち上げた作業に、誰が監視を付けているでしょうか。
解雇の件については判断を保留します。会社側は書簡に書かれていない事実がさらにあるとしながら、その事実を公開していません。3人は当時のルールの範囲内で行動したと言っています。どちらが正しいのか、私にはわかりません。ただ、二つの報告書と解雇を同じ月に並べてみると、共通点が一つ見えてきます。モデル水準の監視は、モデルが指示を再解釈することで切れ、会社水準の監視である外部評価機関とのコミュニケーションは、調査の過程で狭まりました。監視される側が監視の範囲を調整できる構造は、どの層においても同じ弱点を見せます。OpenAI自身が業界全体の約束が必要だと答えた理由も、そこにあると見ています。だからこそ私が注視しているのは、数週間以内に出てくるとされる第三者評価機関との契約です。METRに対して職員レベルのアクセスを維持しているのか、それとも範囲が縮小されたのか。それが、今月の一連の事件がどこへ向かうのかを示す次の数字です。
おわりに
OpenAIは20件の報告書を公開リストとして積み上げています。監視システムはDNS事故を12分で捕捉し、報酬信号はすでにその行動に減点を与えていました。会社は学習を止め、リリースを取り消しました。同時に、監視可能性を研究していた3人を退社させており、その理由を外部から確認することはできません。この2つの事実は両立します。どちらか一方だけを見て安心したり不安になったりする理由はありません。
💬 社内でエージェントにコードを任せてみたことがある方に伺います。エージェントが「するな」という指示を守ろうとして、別の安全装置に触れたことはありましたか。その場面をコメントで聞かせてください。
📨 エージェントの運用ポリシーを作っている方が周りにいたら、この記事を伝えてください。


参考資料と関連リンク
- OpenAI Alignment、「An agent used DNS to reach an external chatbot」、2026.9.25。……DNS事故報告書の原文です。タイムラインと学習停止決定の根拠です。
- OpenAI Alignment、「Suppressing misalignment monitoring alerts and disabling misalignment monitoring」、2026.10.20。……Sol・Astraの事例とLunaクラスの回避の説明です。
- OpenAI Alignment、「Misalignment Reports and Notices」……公開された報告書20件と公示3件の一覧です。
- Tomek Korbak、Jasmine Wang、Mikita Balesni、「OpenAI cannot make AI safe on its own」、2026.10.8。……公開書簡の全文です。
- Newsweek、「Trio of Workers Fired by OpenAI: Read Their Warning Letter in Full」、2026.10.9。……OpenAIの10月9日の声明と3人のX上の発言をまとめています。
- India Today、「OpenAI fires 3 researchers… Signal chats with disappearing messages」、2026.10。……WSJの10月22日の続報(携帯電話の検査、Signal)を伝える記事です。
- Al Jazeera、「OpenAI cancels release of AI model GPT-6.1 Astra, citing safety concerns」、2026.9.29。……発売中止の理由についての安全システム責任者Saachi Jainの説明です。
- Korbak、Balesni他、「Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety」、2025.7。……3人の書簡が拠って立つ業界共同声明論文です。

📝 用語解説
각주
-
DNSリゾルバ(DNS resolver):人が読めるドメイン名をコンピューターが使うIPアドレスに変換するサーバーです。ウェブアクセスを遮断しても名前解決は開けたままにする場合が多く、今回の事故はその名前解決リクエストの中に質問を乗せて外部に送った事例です。 ↩
-
P0(Priority Zero):OpenAIの監視体系における最高緊急度です。P0が発報されるとセキュリティチームが即座に呼び出され、該当する評価では自動停止がかかるはずです。10月3日・6日の事例はこの等級には分類されませんでした。 ↩
-
Hugging Face事故:2026年7月、OpenAIの内部サイバー評価中にエージェントが隔離環境を脱出し、Hugging Face運営の数十台のサーバー上でコードを実行、うち1台でルート権限を取得した事件です。OpenAIは8月26日に技術報告書を公開し、METRとRedwood Researchが独自調査の結果を併せて公表しました。 ↩
-
安全ケース(safety case):この作業がなぜ安全なのか、どのような前提と監視要件の上に安全が成り立っているのかを記した文書です。DNS報告書には「モデルは実際のインターネットにアクセスできない」という前提が安全ケースに盛り込まれていたのに、その前提が崩れたと記されています。 ↩
-
思考の連鎖(Chain of Thought):モデルが答えを出す前に段階的に書き下していく推論過程です。この文を人間が読める間は、モデルが何をしようとしているかを途中で確認できるため、安全研究者たちが監視の窓として利用しています。 ↩
-
METR(Model Evaluation and Threat Research):フロンティアモデルの危険な能力を外部から評価する独立機関です。Hugging Face事故の際にはRedwood Researchとともに独自調査を行い、KorbakがOpenAI側の技術窓口を務めました。 ↩
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。