

英国がGoogleにAI検索の拒否権を求めた理由
英国のCMAがGoogleに、AI検索での利用拒否と出典・利用指標の公開義務を課しました。韓国の著作権保護とどのような違いがあるのか見ていきます。
ビジネスAI検索に自分のコンテンツを使うなと言えるのか
英国の競争市場庁(CMA)1が6月3日、Googleに新たな行為要件を課しました。ウェブコンテンツを提供する人が、AI検索などに自分のコンテンツを使われないよう選択できるようにする措置です。CMAはこれを世界初の措置だと紹介しました。ただし、主要な要件は通知から6か月後、ページ単位の拒否機能は9か月後に発効するよう定められています。発表と同時にすべての機能が完成したという意味ではありません。
韓国で文章を発表する人にとっても重要な問題です。
AIが検索画面で文章を要約すると、読者は原文を訪れずに情報を得られます。検索流入で広告収入やサブスクリプション収益を得ていた報道機関やブロガー、ニュースレター発行者は、コンテンツの利用条件を改めて考えることになります。今回の英国の措置は、著作権侵害の有無を個別に争うこととは別に、Googleの支配的な検索地位に競争法上の義務を課した事例です。
少し前にニュースレターで取り上げたGoogle I/O 2026の検索変化ともつながる話です。韓国国内にはNAVERなど別の検索経路がありますが、これらもAI検索を拡大しています。どのプラットフォームを通じて読者と出会うかによって影響は異なるでしょうが、韓国がこの変化から外れていると見るのは難しいでしょう。
検索窓ひとつが食物連鎖を変えていますGoogleのAI検索拡大がコンテンツ流通に及ぼす変化Googleに課された義務は何か
今回の行為要件は、英国の利用者に提供されるGoogleの生成AIの結果などを対象としています。コンテンツ利用の統制だけでなく、出典表示や利用指標の提供も含まれます。CMA行為要件通知文
コンテンツ提供者は、AI Overviews2やAI Modeといった検索機能に自分の記事が使われないよう選択できるようにしなければなりません。これをオプトアウト3と呼びます。**Googleはその選択を理由に、一般検索での順位を下げたり不利に扱ったりしてはいけません。**検索順位を固定して保証するという意味ではありません。
学習や回答生成に使う方式も統制の対象です。検索用AIだけでなく、GeminiやVertex AIといった他の生成AIサービスも範囲に入ります。追加学習であるファインチューニング4も含まれます。ただしCMAの解釈指針は、検索AIモデルにすでに取り込まれたコンテンツまで除去するよう求めるものではないと説明しています。CMA解釈指針
Googleはコンテンツの出典を明確かつ正確に表示し、読者が原文にアクセスできるよう合理的な措置を取らなければなりません。コンテンツがどのように使われるかを説明し、AI検索での露出やクリックといった利用指標も提供する必要があります。利用を許可するかどうかを判断するには、何を対価として受け取るのかも把握できなければならないからです。
法的根拠は2024年に制定されたデジタル市場競争消費者法(DMCCA)5です。CMAは2025年1月に調査に着手し、10月にGoogleの一般検索サービスに戦略的市場地位を指定しました。これを踏まえて今回の義務を課したのです。AI検索に関する規制のすべてを完成させたわけではなく、CMAは追加の措置が必要かどうかも引き続き見極めていくとしています。
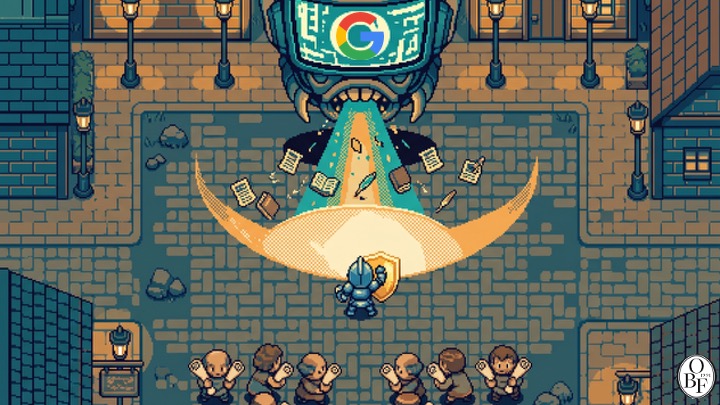
Googleは6月3日、英国の一部ウェブサイト運営者を対象にSearch Consoleの新しい制御機能を試験すると発表しました。AI検索から除外しても、その設定を一般検索の順位シグナルとしては使わないと説明し、試験後には世界へ拡大する計画も明らかにしました。英国での法的な適用範囲と、Googleが自発的に広げる機能提供の範囲とは区別する必要があります。
検索露出が原文訪問につながらないとき
コンテンツ制作者が懸念する背景には、検索流入の減少があります。ただし、出所の異なる調査数値を足し合わせて、すべてAI検索のせいだと断定してはいけません。
ロイター・ジャーナリズム研究所の2026年報告書に掲載されたChartbeatのデータを見ると、2,500以上のニュースサイトのGoogle検索流入は、2024年11月比で2025年11月に33%減少しました。アメリカは38%の減少でした。これは追跡対象サイトの変化であり、世界中すべての報道機関の年間総流入が同じ比率で減ったという意味ではありません。報告書のデータ説明
Ahrefsは30万件のキーワードについて、デスクトップ検索データを比較しました。AI要約のないキーワードでもクリック率が下がっている点を反映して推定したところ、AI Overviewsがあるキーワードの1位ページのクリック率(CTR)6は、要約がなかった場合に予想される水準より約58%低くなりました。これは2023年12月と2025年12月のデータを用いた観察分析です。すべてのサイトでAIのせいで正確に58%減ったという意味ではありません。Ahrefs原文
Pew Researchがアメリカ成人900人の2025年3月の検索履歴を分析した結果も、同じ方向を示しています。AI要約のある検索結果ページの訪問のうち、通常の検索リンクをクリックした割合は8%、AI要約がない場合は15%でした。AI要約自体の出典リンクをクリックした割合は、別途1%でした。これは人数ではなく検索結果ページの訪問件数を基準にした比率であり、検索語の違いまで無作為に統制した実験ではありません。Pew Research分析
ニュースだけでなく、学習資料や生活情報を提供するサイトも影響を受ける可能性があります。検索画面で質問に十分な答えが得られると、原文をクリックする必要性が薄れるためです。ただし、実際の流入減少には検索順位の変更や需要の変化など、他の要因も混ざっている可能性があります。自分のサイトでは、どの検索語とどのページが影響を受けたのか、切り分けて見る必要があります。
コンテンツ提供者にとっては難しい選択です。AIの回答に含まれれば読者と出会う機会が生まれますが、要約だけを読んで離脱する利用者もいます。除外すれば、そのAI機能から得られるはずだった露出と訪問を放棄することになります。どちらが望ましいかは、コンテンツの性格や収益方式、実際の流入によって変わります。
これまでもGoogle-Extendedや検索スニペット制御といった手段はありました。今回の措置が重要なのは、AI検索の利用を拒否したという理由で通常検索において不利益を与えられないようにし、選択に必要な情報を提供させる点です。実施後は、拒否機能がどれほど細かく作動するのか、そして実際の露出の変化を確認する必要があります。
Google検索広告とコンテンツ提供者の広告収益も区別する必要があります。Googleは検索画面に表示される広告で収益を得られるため、外部サイトへの訪問が減っても、Googleの広告売上が同じ比率で減る構造ではありません。短期的にプラットフォームの売上が増えたとしても、原文制作者が収益を失えば、長期的には良質なコンテンツ供給の負担になり得ます。
韓国では著作権紛争とプラットフォーム政策が並行して動く
韓国でもAI検索の利用とコンテンツ補償の問題が同時に議論されています。
オープンサーベイの2026年上半期の報告書は、ChatGPTの利用が過半数に増え、Geminiの利用経験も大きく増加したとまとめています。2025年3月と12月にそれぞれ1,000人を対象に調査した結果です。こうした利用経験調査を検索シェアやメディアのトラフィック減少率と同じものとして見ることはできませんが、人々が情報を探す経路が多様化しているという点は確認できます。
韓国の文化体育観光部と韓国著作権委員会は2026年2月26日、生成AI学習の公正利用を判断するためのガイドラインを発刊しました。利用目的、著作物の性質、使用量、市場への影響などを総合して判断するよう説明しています。すべてのニュース学習や要約サービスを一律に適法または違法と宣言した文書ではありません。政府発表
イギリスの行為要件と韓国のガイドラインは役割が異なります。
CMAの措置は、Googleという指定事業者に具体的な義務を課すものです。韓国の公正利用ガイドラインは、既存の著作権法を適用する際に参照する資料です。ガイドライン自体が新たな拒否ボタンや補償義務を作り出すわけではありませんが、だからといって韓国のコンテンツ生産者に著作権や契約上の権利が全くないわけでもありません。紛争においては、既存の法律と契約に基づいて権利と責任を判断する必要があります。
コンテンツの価値を算定する研究も必要です。ただし、特定メディアの資料に対する推定額を、そのまま法的に支払うべき使用料と見なすことはできません。学習対象や活用方法、ライセンス条件によって、価値や交渉額は変わり得るからです。
ブログやニュースレターを発行する個人にとっても、コンテンツ利用条件は重要です。CMAの通知文は、ウェブ上にコンテンツを公開する人を広くパブリッシャーと定義しています。ただし、YouTubeのようなプラットフォーム内のクリエイターが、ウェブサイト運営者と同じように個別の制御手段を行使できるかどうかは、別に見る必要があります。コンテンツを所有することと、検索ボットに対する設定権限を持つことは異なる場合があります。
韓国で参考にすべき点は、一般検索への露出とAI利用の許可を分離し、実際の利用情報を提供させる具体的な仕組みです。著作権紛争の結論を待つ間にも、プラットフォームの選択機能と情報提供をどう改善していくかは議論できます。
Oswarldの視点
私は今回の措置がコンテンツ生産者の交渉条件を改善しうると見ています。GTM戦略を立てる過程で、プラットフォームに無償で供給する構造が固まってしまった後は、供給者が新たな条件を要求しにくくなる様子を繰り返し見てきました。最初から利用条件を定めることが重要な理由です。
オプトアウトだけで収益が保証されるわけではありません。AI検索から流入していた訪問を失う可能性もあります。それでも、利用を拒否できる選択肢があってこそ、コンテンツ提供者が条件を提案できるようになります。CMAもまた、今回の措置がコンテンツ取引の交渉力を高めうると説明しています。
韓国でも、コンテンツ提供者が利用範囲を選択し、実際の利用量を確認できるようにするべきだと考えます。既存の著作権を行使する手続きとは別に、検索露出を維持しながらAI利用条件を協議できる仕組みが必要です。小さな創作者でも使えるくらい手続きが簡単でなければなりません。
Naverは5月28日に「Naverメイト」を発表しました。AIブリーフィングの引用数を基準に毎月およそ3,000人の創作者を選定し、活動費を支援するプログラムです。すべてのコンテンツに引用1件あたりの使用料を支払う制度とは異なります。それでも、AIが参考にするコンテンツの制作者に報酬を結びつけようとする試みという点で注目に値します。Naver発表
Naverメイト — Naverプレミアムコンテンツ私は、法的義務と自発的な報酬プログラムを併せて評価すべきだと考えます。拒否設定が実際に守られているか、どのコンテンツがどれだけ使用されているか、報酬が誰に渡っているかを確認する必要があります。イギリスの制度とNaverの試みについても、その結果を見守っていく必要があります。
おわりに
AI検索では、原文を作る人と回答を見せるプラットフォームの間の条件が重要になっています。
英国CMAはGoogleに、コンテンツ利用拒否権の保障や情報提供、出典表示などの義務を課しました。検索流入が減少している状況で、コンテンツ生産者に選択権を与えようとする措置です。韓国でも既存の著作権保護とあわせて、実際に行使できる利用コントロールと補償条件を具体化する必要があります。
読者の皆さんは、AIが検索結果を要約してくれる機能、実際によく使っていますか? 要約だけ見て済ませる方なのか、原本まで見に行く方なのか、コメントで教えてください。


参考資料と関連リンク
主要出典
- UK Competition and Markets Authority、「CMA secures fairer deal for publishers and improves Google Search services in UK」、2026.6.3.:今回のニュースレターの核心的な根拠です。規制の三つの柱を直接確認できます。
- Google、「New controls for website owners」、2026.6.3.:GoogleがSearch Consoleに導入したオプトアウトトグルの具体的な内容を扱っています。
- Ahrefs、「Update: AI Overviews Reduce Clicks by 58%」、2026.2.:AI要約の有無によるクリック率の差を推定した、30万件のキーワードを対象にした観察分析です。
- Press Gazette & Chartbeat、「Global publisher Google traffic dropped by a third in 2025」、2026.1.:2,500以上のニュースサイトにおける、2024年11月比2025年11月のGoogle検索流入の変化を報じています。
背景知識
- Kluwer Competition Law Blog、「AI Overviews Are Harming Competition, Letting Publishers Opt-out Won’t Help」、2026.4.
- 韓国文化体育観光部・韓国著作権委員会、「生成AIの著作物学習に関する著作権法上の公正利用ガイドブック」、2026.2.:ガイドブックの趣旨と公正利用の判断基準を紹介する韓国政府の発表です。
- Opensurvey、「AI検索トレンドレポート2026」、2026.1.:韓国の検索市場のAI転換データです。NAVERの下落とChatGPTの台頭を数字で確認できます。
筆者アン・グァンソプ(安光涉)は世宗大学校経営学科教授であり、INLEVEL9のリードコンサルタントである。大学では経営データ管理、ビジネスアナリティクスなど統計・データ分析を教える一方、現場ではGTM戦略とAI戦略コンサルティングを率い、技術とビジネスの接点を設計している。AI対話システムの記憶アーキテクチャ(HEMA)研究で学術論文を発表しており、毎日グローバルなAI論文をキュレーションするDaily Arxivプロジェクトを運営している。高麗大学校技術経営専門大学院修士課程とKMBAを修了。著書に『考えることを委ねる人々:ホモ・ブレインレス』がある。

각주
-
CMA(Competition and Markets Authority):英国の競争市場庁です。韓国の公正取引委員会と似た役割を担っていますが、2025年からデジタル市場の大手テクノロジー企業を直接規制できる新たな権限を持つようになりました。 ↩
-
AI Overviews:Googleが2024年から検索結果の最上部に表示するAI生成要約です。ユーザーの質問に対する答えを、AIが複数のウェブコンテンツを総合して直接示す機能です。 ↩
-
オプトアウト(Opt-out):特定のサービスや機能から自分のコンテンツやデータを除外するよう求める行為です。反対に参加を選ぶことはオプトイン(Opt-in)と呼びます。 ↩
-
ファインチューニング(Fine-tuning):すでに学習済みのAIモデルに、特定分野のデータを追加で学習させる工程です。汎用モデルを特定の用途に合わせて精密に調整すること、と理解すればよいでしょう。 ↩
-
DMCCA(Digital Markets, Competition and Consumers Act 2024):英国のデジタル市場・競争・消費者法です。大手テクノロジー企業に「戦略的市場的地位(SMS)」を指定し、個別の行為規制を課すことができる法的根拠を提供します。EUのデジタル市場法(DMA)に対応する英国版の規制法です。 ↩
-
CTR(Click-Through Rate):検索結果が表示された回数に対して、実際にクリックされた割合です。CTRが低いというのは、検索結果は表示されていても、人々が実際にはクリックしていないことを意味します。 ↩
あわせて読みたい過去の号
サムスン成果給論争で区別すべき三つの分配方式
サムスン電子の成果給格差をきっかけに、国民配当、国富ファンド、社会連帯賃金について調べました。誰がどの財源を分けるのかをまず区別する必要があります。
ビジネス中国がMetaによるManus買収の撤回を求めた後に残る問題
中国当局がMetaによるManus買収の撤回を求めました。再買収の資金調達と、人材・技術の分離という残された課題を見ていきます。
ビジネスAnthropicがコピーライターに求める仕事
Anthropicは企業顧客向けコピーリード職の公募で、年俸25万5,000~32万ドルを提示しました。公募に込められた編集判断と製品理解の役割を見てみました。
ビジネス
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。