

AIの満点主張は6件、公式採点は2件のみ
6件が満点を主張したものの公式採点は2件のみ。AIベンチマークに必要なのは「試験制度」です。
ビジネス満点を主張したAIは6件、公式採点は2件のみだった
7月16日、上海で国際数学オリンピック(IMO)が閉幕しました。666名が参加し、42点満点を獲得した生徒は7名でした。
ところが、その翌週はさらに騒がしくなりました。わずか1週間のあいだに、6つのAIシステムが「自社も42点満点だった」と相次いで発表したからです。ファーウェイ(華為技術)、小紅書(RED)、そして独立したテストから出た4つのモデルに至るまでです。
しかし、この6つのうち、IMO主催者側に実際に答案を提出したのは2件だけでした。残りは公式採点の枠外での結果です。これにはClaudeベースのエージェントが採点したテストや、AxiomProverによるLean 4形式証明が含まれます。公式採点とは検証方式がそもそも異なります。
いまAIの評価に不足しているのは、より難解な問題ではありません。「答案を誰が、どのような条件で、どう採点したのか」を記録として残す手続きです。スコアだけを公表するベンチマークではなく、受験条件と検証手続きを備えた試験が必要だということです。
満点の主張は6件、受験条件はまちまちだった
人間の側の成績は極めて明確です。666名中7名が満点。生徒たちは2日間にわたり、計9時間をかけて6問を解きました。同じ日の、同じ時間に、同じ部屋でです。対するAI側は、次のように分かれます。
公式採点ルート:ファーウェイのCeliaと小紅書のdots-note-3.0は、人間の大会が終了したあとに問題を受け取り、規定の時間内に答案を提出して、その答案をIMO主催者側に渡しました。小紅書は「いかなる形態の人間の介入も厳格に禁止した」と明かしています。
独立テストルート:下の表には、研究者が独自に構築したテスト環境の結果と、Axiom Mathが公開したAxiomProverの形式証明の結果がまとめられています。
| モデル | 初回試行 | 最終 | コスト | 所要時間 |
|---|---|---|---|---|
| Claude Fable 5 | 42/42 | 42/42 | 約51ドル | 2.5時間 |
| GPT-5.6 Sol (xhigh) | 39/42 | 42/42 | 約21ドル | 3.8時間 |
| Kimi K3 | 36/42 | 42/42 | 約31ドル | 17.4時間 |
| AxiomProver | 形式証明 | 42/42 | 非公開 | 約25時間 |
数字だけを見れば確かに驚くべき結果です。Fable 5は1回で解ききり、生徒たちに与えられた9時間の3分の1もかかりませんでした。AxiomProverは毛色が異なり、Lean 41という形式証明言語を用い、6問を計7,722行にわたって機械検証可能な証明として組み上げました。問3の1問だけでも4,229行、869分を費やしています。
しかし、この表を見ながら私が終始引っかかっていたのは、成績ではなく条件でした。
 自然言語で書かれた解答をAIエージェントが採点した結果と、Lean 4で証明を検証したAxiomProverは区別して見る必要があります。推論努力(effort tier)の設定次第で、同一モデルのスコアが11点も変動しました。そして最も腑に落ちない点がひとつあります。同一のテストにおいて、MetaのMuse SparkとDeepSeek V4 Proが、問3でまったく同じ誤答を出したのです。
人間の試験会場であれば、これは即座に調査の対象となります。同一の誤答が出た理由を追加で確認しなければならないからです。学習データが重複していた可能性もありますが、誤答が同一であるという事実だけで、独立して解いていなかったと結論づけることはできません。しかしベンチマークには、そうした事態に対処する手続きそのものが存在しません。単にどちらも「誤答1問」と記録されて終わりです。
1062年、高麗は答案用紙から名前を消した
「試験」という制度を語るとき、私たちは通常「問題」を思い浮かべます。どんな問題が出題され、どれほど難しく、誰が正解したのか、と。しかし試験制度の歴史を振り返ると、本当に心血を注いで発展してきた部分は問題そのものではありません。不正を防ぎ、結果を検証するための手続きです。
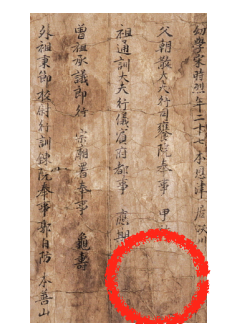 その代表例が「封弥(ふうび)」です。答案用紙の右端に記された受験者の身分、氏名、年齢、本貫を折り込み、糊付けして完全に隠してしまう手法です。採点者に誰の答案かを分からなくするためです。中国の宋代に確立され、高麗では1062年(文宗16年)にチョン・ユサン(鄭惟産)の建議によって導入されました。これは朝鮮王朝時代までそのまま引き継がれました。
それだけにとどまりません。名前を隠したとしても、筆跡で誰か分かってしまうおそれがあります。そこで、答案を第三者が丸ごと書き写す「易書(えきしょ)」のような仕組みまで導入されました。
千年前の人々は、なぜここまでの仕組みを作ったのでしょうか。採点者を信用していなかったからではありません。試験結果に社会的効力を付与するためには、その結果がどのように導き出されたのかを後から検証できなければならなかったからです。
科挙の及第は、単なる点数ではありませんでした。官職へと直結する資格だったのです。試験結果がこのように資格として機能するとき、試験は実力を測る道具を超えて、社会的効力を持つ手続きになります。そうなれば必要なのも、さらに難解な問題ではなく、異議申し立ての手続き、監督官、記録の保存、そして結果に責任を負う主体です。
興味深いことに、この手法は学術論文の評価でも用いられています。「ブラインド査読(Blind Peer Review)」と呼ばれる方式は、著者の所属大学や指導教授などの背景が査読者への圧力になったり、権威を与えたりしないよう覆い隠したうえで論文を評価させています。そして現在のAI評価もまた、スコアが導入や購買の意思決定の根拠として使われ始める段階に差しかかっています。
IOAIに今年初めてAIモデルトラックが新設、初セッションは8月4日
8月2日から8日まで、カザフスタンのアスタナで第3回国際人工知能オリンピック(IOAI)が開催されます。そして今年初めて、IOAI²: AI Model Trackという独立したトラックが新設されました。AIシステムが参加者として登録し、人間の参加者とは分離されたリーダーボードで競い合うトラックです。登録締め切りは明日、7月27日に迫っています。
規定の主な要点は以下のとおりです。
- 規定の時間:8月4日と6日、各6時間の計2セッション。セッションごとに3問。
- 人間の介入禁止:初回の実行プロンプト以降は自律遂行。
- 受験回数の制限:課題ごとに最大50回までの提出。
- 標準採点環境:実行は参加組織のハードウェアで行うが、採点は標準化されたGPUで実施。
- 結果公開の選択権:セッション終了後24時間以内にパーセンタイルスコアが非公開で通知され、48時間以内に組織名で公開するか匿名にするかを決定。
- 検証条件:メダルを獲得するには、すべてのモデル入出力、ツール呼び出し、プロンプトが記録された実行トレース2を提出しなければならない。この記録は審査員団以外には公開されない。
- 受験料:1組織あたり1モデルは無料(スポンサーは2モデル)、追加モデルは1モデルにつき2万5,000ユーロ。
この項目を従来のベンチマークと比較すると、その違いは明白になります。
公開ベンチマークを各自で実行してスコアだけを発表する場合、受験のタイミング、試行回数、実行条件が統一されず、プロセスの記録も欠落しがちです。一方、このトラックでは受験時刻が固定され、試行回数が制限され、結果を公認してもらうためにはプロセスの記録を提出しなければなりません。そしてそこには審査員団が存在します。
封弥が採点者から受験者の名前を覆い隠す装置だったとすれば、実行トレースの提出は審査員に対して受験プロセスを全面的に開示する装置です。方向は逆ですが、目的は同じです。結果を事後検証可能にすることです。
2万5,000ユーロという受験料も、単なる収益モデルとして片付けるべきではありません。受験料が存在するということは、受験という行為にコストと責任が伴うことを意味します。無料で無制限に回せる評価と、費用を支払って登録し、指定された日に臨む評価とでは、参加者の行動様式が根本から変わってくるのです。
ベンチマークが崩壊しつつある証拠
「それでもベンチマークで十分ではないか」と思われるかもしれません。しかし、直近数年間のデータを見れば、そうではないことが分かります。
第一に、飽和(saturation)3**です。**GPQA Diamondは、2023年末の39%から2026年初頭には94%へと跳ね上がりました。わずか2年あまりで、スコアをこれ以上伸ばす余地がほぼ失われてしまったのです。AIME 2025でも上位モデルが80点台後半から90点台半ばに密集しています。こうなると、スコアの差は実力の差を意味しなくなります。GPQA Diamondは全198問ですが、この規模における95%信頼区間はおよそ±3点です。3点差を掲げて順位を競わせるマーケティング文句の大半は、統計的に有意ではないということです。
第二に、汚染(contamination)4**です。**Scale AIがGSM8Kと同等の難易度に調整した新たな問題セット「GSM1k」を作成し、同一のモデル群を再テストしたところ、一部のモデルでスコアが最大13点下落しました。さらにその下落幅は、当該モデルがGSM8Kの問題を丸ごと出力する頻度と相関していました。一部のモデルにおける従来のスコアには、問題の丸暗記が影響していた可能性を示唆しています。
**第三に、ジャッジ(審判)の問題です。**LLMを採点者として起用すると、回答が長いほどスコアが15〜30点高くなる偏向が観察されています。選択肢の提示順序によって選好が変わるバイアスも存在します。これらはランダムに揺らぐ誤差ではなく、一定の方向へと偏ったバイアスです。そのため、モデルをこうした採点基準に合わせてチューニングしていくと、回答を長く書く方向へと偏ってしまうおそれがあります。
これら3つの要素を総合すると、リーダーボードのスコアは確定した性能ではなく、どのような条件下で導き出されたのかを個別に確認すべき主張に近いといえます。
Oswarldの視点
私はこの問題を、単なる評価方法論の議論としてではなく、企業の購買決定における課題として捉えています。
Go-to-Market(GTM)戦略を策定するなかで、私は数え切れないほど同じ光景を目にしてきました。ベンダーがベンチマークのスコアを提示してきます。担当者はその数値を稟議書に書き写します。しかし2カ月後、現場での実務で期待どおりの性能が出なかったとしても、その数値を根拠に誰も責任を追及できません。そもそもそのスコアがどのような条件下で出されたものなのか、誰も把握していないからです。私はこの状況を幾度となく見てきましたし、そのたびに同じ結論に行き着きました。ベンチマークのスコアは調達の根拠ではなく、マーケティングのための資産に過ぎないのだと。
企業がAIを導入するにあたり、ベンダーの「当社のモデルは94点です」という言葉だけで判断を下すのは困難です。実際に必要な情報は、**「この条件下で、この日時に、このようなプロセスを経てこの結果が出力され、その記録が保管されている」**という事実です。会計監査を思い浮かべてみれば分かりやすいでしょう。私たちは企業の業績発表の数値をそのまま信じているわけではありません。監査人が存在し、監査調書が存在し、あとから検証できる記録が残されているからこそ信頼しているのです。
現在のAIの性能発表においては、こうした検証記録が十分に開示されないケースがあります。だからこそ、IOAI²の試みに注目しています。より難解な問題を出題するのではなく、スコアがどのような条件とプロセスで導き出されたのかを後から検証可能にする試みだからです。私は、いまのフェーズにおいてはその方向性のほうがはるかに重要だと確信しています。
もちろん、初回からすべてがうまく機能するとは思っていません。自前のハードウェアで実行し採点のみを標準環境で行うという仕組みには抜け穴があります。試行回数を50回まで許容するという仕様は、最良の成績だけを抜き出す余地を残してしまいます。2万5,000ユーロという受験料も、リソースが豊富な組織に有利に働きます。それでも、方向性としては正しいはずです。初めて導入された制度の不備は、運用を重ねながら補完していけばよいのです。封弥も、当初は名前を隠すだけだったものが、のちに筆跡まで隠すように発展していったのですから。
おわりに
- IMO 2026において、人間は666名中7名が満点を獲得し、AIは6つのシステムが満点を主張しました。そのうち公式採点の手続きを踏んだのは2件のみです。
- ベンチマークは「飽和」「汚染」「審判の偏向」という3つの理由により、すでに弁別力を失いつつあります。
- 次なる段階は、より難しい問題ではなく、受験条件と検証手続きを備えた試験制度です。8月のアスタナで、その最初の実験が始まります。
今度誰かがAIの性能数値を提示してきたら、点数を尋ねるのではなく、こう問いかけてみてください。**「そのスコアは、誰がいつどんな条件下で採点したもので、記録は残っていますか?」**と。言葉に詰まるケースが、想像以上に多いはずです。
もし実務でAIツールを導入する際、ベンチマークの数値と実際の性能のギャップに悩まされた経験がおありでしたら、どの点において最も大きく食い違ったのか、ぜひコメントでお聞かせください。事例が集まりましたら、次号で「実務担当者のためのAI性能検証質問リスト」としてまとめてお届けしたいと思います。
📨 AI導入を検討している同僚がいらっしゃいましたら、この記事をシェアしてください


参考資料と関連リンク
主要出典
- IOAI, “AI Model Track: Rules and Competition Format,” International Olympiad in Artificial Intelligence 2026. リンク ··· 実行トレースの提出と検証スコアに関する条項が本稿の中核的な根拠となっています。規定の原文を直接ご覧いただくと、「試験」と「ベンチマーク」の設計思想の違いがより鮮明に理解できます。
- Axiom Math, “AxiomProver at IMO 2026,” GitHub, 2026. リンク ··· 6問のLean 4形式証明の全文が公開されています。機械検証可能な証明がどのような記述形式をとるのか気になる方は、問3のファイルを参照してみてください。
- Digital Applied, “Four AIs Scored a Perfect 42/42 on IMO 2026. So What?”, 2026. リンク ··· モデルごとのコスト、所要時間、再試行回数、採点主体の相違を表形式で整理した記事です。一般報道で曖昧に処理されがちな差異を切り分けて把握できます。
- Acing AI, “The LLM Evaluation Crisis: Contamination, Saturation, and the Judge Problem,” 2026. リンク ··· GPQA Diamondの信頼区間およびGSM1kの再現実験データはここから引用しています。ベンチマークを扱う実務担当者であれば、統計パートだけでも一読をお勧めします。
- AFP, “AI catches up with humans to score 100% at top maths contest,” 2026年7月23日。 リンク ··· ファーウェイおよび小紅書の発表を取り上げた通信社の報道です。企業の公式発表がメディアでどのように伝達されるかを観察するうえでも格好の事例です。
背景知識
- 「封弥」、『朝鮮王朝実録専門事典』、韓国学中央研究院。··· 1062年の高麗文宗時代における導入の経緯が整理されています。試験制度の本質が問題ではなく手続きにあったことを確認するのに最適です。
- 「中国の科挙制」、『ウィキペディア韓国語版』。リンク ··· 宋代における科挙改革の全体的なコンテクストを把握するのに適しています。

📝 用語解説
각주
-
Lean 4:数学の証明をコンピュータが1行ずつ検証できる形式で記述するプログラミング言語です。人間が読んで「正しそうだ」と判断する代わりに、機械が論理的な不備を自動で検出します。 ↩
-
実行トレース(execution trace):AIが問題を解く過程でやり取りしたすべての入力、出力、ツール呼び出し、プロンプトを時系列順に記録したものです。試験に例えるなら、答案用紙というより防犯カメラの映像に近いです。 ↩
-
飽和(saturation):モデルの性能向上に伴って評価問題が相対的に平易になり、上位層のスコアが軒並み満点付近に密集してしまう現象です。この状態に陥ると、スコアの差から実力の優劣を判別できなくなります。 ↩
-
汚染(contamination):評価に用いられる問題が、モデルの事前学習データにあらかじめ混入してしまっている状態です。試験問題をあらかじめ見て受験するようなものであり、スコアが実力ではなく暗記を反映してしまいます。 ↩
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。