

韓国のAI競争力、モデル順位と人材流出を併せて見るべき理由
韓国のAIモデル数や人口あたりの特許数は上位にあるものの、研究人材を確保し産業現場で成果を出す課題は残されています。ソブリンAIをモデル開発だけでなく運用やサプライチェーンまで含めて捉えるべき理由を考察します。
社会AIを頻繁に使うこととAI産業の競争力
MITテクノロジーレビューは2026年6月15日、ミシェル・キム(Michelle Kim)記者による記事『Why Do South Koreans Love AI So Much?』を掲載しました。韓国の人々がAIを積極的に受け入れている理由を取り上げた記事です。
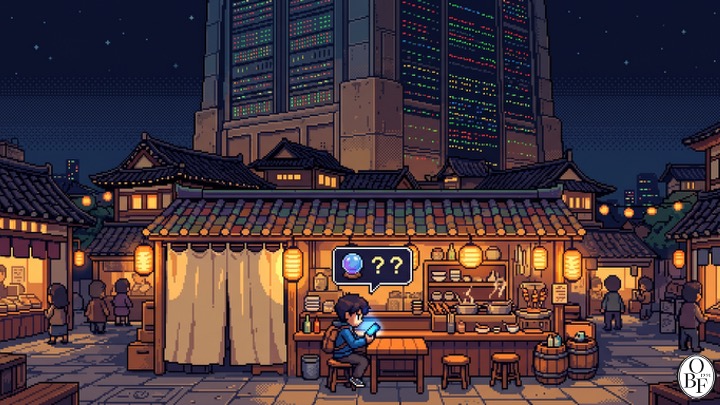
記事の中には、記者のいとこがソウルの中央市場にある屋台でChatGPTに四柱推命(サジュ)による運勢を尋ねる場面が登場します。29歳の保険設計士であるこのいとこは、恋愛や投資に関するアドバイスもチャットボットに求めています。記事が引用した韓国ギャラップの調査によると、20代の46%がチャットボットで運勢を見てもらった経験があると答えています。AIが日常の対話相手になった事例といえます。ただし、こうした利用事例だけで韓国のAI活用が浅薄であるとか、産業競争力が高いと判断することはできません。
私はこの記事をきっかけに、韓国のAI競争力をあらためて整理してみたいと考えました。**AIに対する好感度、モデルの開発実績、研究人材の確保は、それぞれ別の問題です。**韓国政府が掲げる「AI G3(AI主要3カ国)」という目標も、どの指標における3位なのかを確認して初めてその意味が見えてきます。
AIへの期待と雇用への不安
ピュー・リサーチ・センターが2025年に実施した25カ国調査において、AIに対して期待よりも懸念が大きいと答えた割合は、韓国が16%と最も低い水準でした。米国とイタリアはそれぞれ50%、オーストラリアは49%でした。とはいえ、残る84%の韓国人回答者全員が楽観視しているわけではありません。期待と懸念は同じくらいという回答も含まれています。
韓国が鉄鋼、半導体、通信技術を土台に成長してきた経験も、こうした期待の背景にあると考えられます。KAISTのチョン・チヒョン教授はMITテクノロジーレビューのインタビューで、政府がAIをより良い未来のための技術として一貫して説明してきた点を指摘しました。
韓国政府は2026年のAI関連予算を9.9兆ウォン計上しました。GPUの確保や国家AIコンピューティングセンターの構築を推進し、独自ファウンデーションモデル1の開発事業も運営しています。研究インフラとモデル開発に財政を投入し、AI産業を育成しようとする政策です。
スタンフォード大学のAI Index 2026に掲載されたイプソスとGoogleによる共同調査でも、韓国の回答者の70%は、AIの影響を受ける既存産業を規制で保護することよりも、科学や医療などにおけるAIイノベーションを促進することを優先しました。これは安全や個人情報保護のためのあらゆる規制に反対しているかを尋ねた設問ではありませんでした。
しかし、こうした期待が雇用に対する不安を完全に打ち消すわけではありません。現代自動車のアトラスロボット工場導入計画に対し、労働組合が労使合意を求めて反発した事例も同じ記事で紹介されています。AIが便利だという評価と、自分の雇用にどのような影響を与えるのかという不安は、同時に存在し得るものです。
モデル数、特許数、性能は分けて見る必要がある
AI Index 2026において、韓国はモデル開発や特許の指標で上位に位置しています。ただし、これら2つの指標が測定している対象は異なります。
**2025年に発表された「注目すべきAIモデル」の数は、米国59個、中国35個、韓国8個でした。**韓国はこの集計で世界3位です。これは報告書が選定したモデルの数であり、各国が開発したすべてのモデルを数えた数字や、モデル性能の順位ではありません。
**2024年の人口10万人あたりに登録されたAI特許数は、韓国が14.31件で最も多い結果となりました。**これは人口に対する特許登録の実績が高いことを意味します。特許の総数やビジネス的価値、AIモデルの性能が世界1位であると拡大解釈してはなりません。
個々のモデル性能は、同一の時点、同一の評価基準で比較する必要があります。LG AI研究院は2026年1月、K-EXAONEがArtificial Analysisの知能指数2において、オープンウェイトモデルの中で世界7位に入ったと発表しました。これは公開されているモデルの中で得られた成果です。これを異なる時点の指数スコアと並べて「韓国モデルの性能は40%低い」などと計算するのは適切ではありません。評価設問、指数のバージョン、比較対象となったモデルが一致していなければならず、スコアの差が能力の比率をそのまま表すわけでもありません。
韓国内のモデルを一括して同規模の小型モデルとみなすことも困難です。たとえばK-EXAONEは、総パラメータ数が2,360億個であり、入力を処理する際にそのうち約230億個を活性化させる構造を採用しています。モデルごとに規模や設計、公開範囲が異なるため、米国や中国のフロンティアモデル3と比較する際にも、具体的なタスク性能と運用コストを併せて見る必要があります。
私がソブリンAI関連のセミナーや懇談会に参加する際、常に述べている点があります。**ソブリンAIとは単にモデルを作るだけでなく、必要なデータや演算リソースを確保し、サービスを自ら直接運用できる能力まで含めて捉えるべきだということです。**モデルを販売した成果だけで、サプライチェーンや運用の統制権まで確保できたと見ることは困難です。
他モデルの出力を学習に活用する蒸留(ディスティレーション)についても、手法そのものを問題視するより、どのような権限でどのデータを用い、何を獲得したのかを精査すべきだと考えます。利用規約やライセンスを確認する必要があるため、「蒸留には法的な問題が一切ない」と一括して言い切ることはできません。また、フロム・スクラッチ4で学習したという事実も、性能や運用能力を代わりに証明してくれるわけではありません。
研究人材の確保という課題もあります。**AI Index 2025に掲載された2024年の韓国におけるAI人材の純移動指標は、LinkedIn会員1万人あたり-0.36人でした。**これは人口全体ではなく、LinkedIn会員のプロフィール移動に基づいて算出された数値です。韓国銀行はこの結果を「OECD 38カ国中35位」として紹介しました。該当資料において流入するAI人材よりも流出する人材のほうが多かったことを意味しており、韓国のAI人材の実力が35位であるという意味ではありません。
韓国銀行の2025年の理工系人材調査では、韓国内で勤務する回答者の42.9%が今後3年以内の海外転職を検討していると答えました。報酬だけでなく、研究環境やキャリアの機会もその理由として挙げられています。異なる条件で集計された韓国と米国の博士号取得者の年俸を単純比較して人材流出の原因を一つに帰するのではなく、韓国内で研究を継続できる環境が整っているかを総合的に見渡す必要があります。
特許登録の実績が高水準であることと、人材の純流出が生じていることは、同時に起こり得ます。特許件数は、研究人材が今後も国内で働き続けられるかどうかを教えてはくれません。開発成果を積み上げることと、その成果を生み出した人材を確保することは、切り離して個別に管理すべき課題だと考えます。
国内での成功を海外での競争力につなげる課題
韓国のインターネットサービスの歩みも振り返る必要があります。サービスをいち早く開始したことや、国内で多くのユーザーを集めたという事実だけで、海外市場で成功できるわけではありませんでした。
Cyworld(サイワールド)は1999年にサービスを開始し、その後の「ミニホムピ」やアバター機能によって韓国内で絶大な人気を博しました。NAVERの「知識iN」は2002年に始まり、Yahoo! Answersよりも早くユーザーによる質問と回答を蓄積していました。韓国は超高速インターネットの普及とオンラインサービスの利用がいち早く進んだ市場でした。
しかし、Cyworldは海外事業とモバイルシフトで苦戦を強いられ、国内検索におけるNAVERの地位も、世界検索市場のシェア獲得には直結しませんでした。電子金融におけるセキュリティや認証の要件をActiveXで実装していた慣行は、Internet Explorerへの依存を生みました。韓国政府がActiveXそのものを法律で義務付けたと表現するのは不正確ですが、制度と実装手法が結びついた結果、特定の技術に長期間依存することになった点は振り返る価値があります。
これらの事例の原因を一つに括ることはできません。ただし、韓国内でうまく機能していたサービスや技術であっても、海外の利用環境、異なるブラウザ、新たなデバイスにおいては制約になり得るという共通点は見出せます。このように国内環境だけに最適化された技術が外部市場と互換性を持たなくなる問題を「ガラパゴス現象」5と呼ぶこともあります。
AIの領域では、「独自開発」をどう評価するかが議論を呼びました。2026年1月、韓国政府の独自AIファウンデーションモデル開発事業の第1次評価において、NAVER Cloudが脱落しました。韓国の科学技術情報通信部の説明によると、争点となったのは外部モデルの視覚・音声エンコーダーの重み(ウェイト)を固定したまま使用した点でした。政府はこれを事業の独自性基準に合致しないと判断しました。ライセンス違反が確認された事案ではなく、NAVERの言語モデル全体が外国製モデルをファインチューニング6したものであると断定されたわけでもありませんでした。
当時、LG AI研究院、SKテレコム、Upstageは次の段階へと選定されました。私はこの結果を見て、政府が求める独自性の目的をより明確に説明する必要があると感じています。外部技術を活用しつつも自律的に改善・運用できる能力を評価するのか、あらゆる構成要素の重みをゼロから学習することを最優先とするのかによって、企業の投資の方向性が大きく変わるためです。これをもって直ちにActiveXと同様の結末を招く政策だと決めつけることはできませんが、その評価基準が実際の競争力向上にどう寄与するのかは検証し続けなければなりません。
半導体と産業現場で培った強み
韓国がすでに強みを持つ分野にAIをどう適用していくのかについても、具体的に検討する必要があります。
サムスン電子とSKハイニックスは、AIサーバーに用いられる広帯域メモリ(HBM)7の主要サプライヤーです。米国のMicronもこの市場に参入しています。韓国企業が不可欠な部品を供給している点は紛れもない強みですが、AI半導体のサプライチェーン全体を独占または統制しているという意味ではありません。
新しい技術を積極的に試すユーザーの存在も大きな資産です。MITテクノロジーレビューの記事では、チャットボットの利用から介護ロボット、AIバス停留所に至るまで、韓国内の多様な活用事例が紹介されています。こうした環境は、AIサービスを実際に検証するテストベッド8になり得ます。導入件数とともに、ユーザーが何を得たのかを確認して初めてその価値が分かります。
私は、半導体の供給実績や迅速な技術導入が、国内サービスの競争力へとどう結実していくのかに注目しています。HBMの供給で成果を上げながらも、サービスによる収益は海外企業に集中するという構図もあり得ます。あるいは海外製AIを活用して、韓国企業の生産性や製品品質を高める道もあります。いずれの場合でも、国内にどのような技術と収益が蓄積されるのかを具体的に見極める必要があります。
汎用モデルの開発に求められる投資規模は膨大です。AI Index 2026が集計した米国の2025年における民間AI投資額は2,859億ドルに達しました。これは韓国の2026年政府AI予算とは年度も異なり、民間と政府という枠組みの違いもあるため、総投資の格差を単純な倍率で比較することはできません。私は、限られた資源を配分する際、半導体プロセスの最適化、バッテリーの品質管理、コンテンツ制作など、韓国企業がすでに現場知識と顧客基盤を確立している分野へのAI適用により重きを置くべきだと考えます。
Oswarldの視点
私は、韓国が自らを「AI G3」と称する姿勢には危うさがあると考えています。
GTM戦略を策定する現場で、繰り返し目にしてきた問題があります。「自分たちが何位か」という順位に囚われるあまり、どの顧客に何を提供すべきかという判断が鈍ってしまうケースです。**注目すべきモデル数で韓国が世界3位であるという事実は一つの成果ですが、米国59個、韓国8個という集計値をもって、両国の産業競争力が同水準にあるとみなすことはできません。**モデル数には表れない売上やユーザー数、研究人材、そして運用基盤にも目を向ける必要があります。
私がより注目しているのは、韓国内のAI企業が差別化要因として掲げる韓国語性能とコスト効率です。特定の顧客や業務に焦点を絞る戦略は極めて有効です。ただし、その戦略を通じてどのような市場を獲得しようとしているのか、そしてそれが「G3」という国家目標とどう結びつくのかについては説明が求められます。特定業務の顧客を獲得することと、汎用モデルの先頭を争うこととでは、必要な投資規模も販売手法も異なるからです。
**私は、韓国がAIを産業現場でうまく活用することに、より明確な優先順位を置くべきだと考えます。**モデル開発と応用サービスは相互に必要な活動ですが、すべての分野を一律の熱量で支援することはできません。自ら開発すべき領域、外部技術を活用すべき領域、そして国内企業の現場経験を製品へと昇華させる領域を具体的に見極めなければなりません。順位に対する自負が、こうした選択を先送りする理由になってはならないと考えます。
おわりに
韓国には、AIを積極的に受け入れるユーザー、政府による投資、そして半導体企業が誇る供給能力が存在します。その基盤の上で、研究人材が働ける環境を整え、産業ごとに実質的な成果を生み出していくという課題が残されています。
「AI 3位」という言葉よりも、どんな問題を解決できるのか、その取り組みを持続させる人材と運用基盤があるのかをまず確認すべきだと考えます。
記事に登場した保険設計士にとって重要だったのは、国家としてのモデル順位ではなく、目の前にあるチャットボットが役に立つかどうかだったはずです。産業政策もまた、実際のユーザーや企業が得られる効果を確かめることから離れてほしくないと思います。
💬 読者の皆さんは、国内産業においてAIの適用を最優先すべき分野はどこだとお考えですか? ぜひコメント欄でご意見をお聞かせください。


参考資料と関連リンク
主要出典
- Michelle Kim, 「Why Do South Koreans Love AI So Much?」, MIT Technology Review, 2026.06.15. 韓国のAI利用実態と意識を取り上げた記事です。
- Stanford HAI, AI Index Report 2026. モデルと特許は第1章、投資と雇用は第4章、意識調査は第9章で確認できます。
- Stanford HAI, AI Index Report 2025, 第4章 図4.2.23. 2024年のLinkedIn会員基準によるAI人材の純移動指標です。
- Pew Research Center, 「How People Around the World View AI」, 2025.10.15. 25カ国を対象としたAI意識調査です。
- 韓国銀行、 「理工系人材の海外流出決定要因と政策的対応方向」, 2025.11.03. 人材移動指標と国内外の理工系人材へのアンケートを扱った報告書です。
背景知識
- LG AI研究院、 K-EXAONEグローバル評価およびモデル説明, 2026.01.12. モデル規模と当時のオープンウェイトモデルにおける順位を説明しています。
- 韓国科学技術情報通信部、 独自AIファウンデーションモデル第1次段階評価結果ブリーフィング, 2026.01.15. 独自性の基準とNAVER Cloudの評価の争点に関する公式説明です。
- 韓国農林畜産食品部、 国民主権政府38大代表成果, 2026.05. 2026年のAI投資予算とモデル開発実績を含む政府公表資料です。
筆者のアン・グァンソプ(安光涉)は、世宗大学経営学科教授であり、INLEVEL9のリードコンサルタントを務める。大学で経営データ管理やビジネスアナリティクスなど統計・データ分析を教える傍ら、現場ではGTM戦略およびAI戦略コンサルティングを主導し、テクノロジーとビジネスの接点を設計している。AI対話システムの記憶アーキテクチャ(HEMA)研究で学術論文を発表しており、世界のAI論文を毎日キュレーションするDaily Arxivプロジェクトを運営している。高麗大学技術経営専門大学院修士課程およびKMBA修了。著書に『思考を委ねる人々:ホモ・ブレインレス』がある。

각주
-
ファウンデーションモデル(Foundation Model):膨大なデータで事前学習された汎用AIモデル。GPT、Gemini、Claudeなどの大規模言語モデル(LLM)が代表例。このモデルを基盤に、特定の用途に合わせた追加学習を行うことで多様なサービスを構築できる。 ↩
-
知能指数(Intelligence Index):Artificial Analysisが複数の評価設問を総合して算出するモデル評価指数。設問や計算式が改定されるため、同一のバージョンおよび時点でのスコアを比較する必要がある。 ↩
-
フロンティアモデル(Frontier Model):現存するAIモデルの中で最高峰の性能を発揮する最先端モデル。主に米国のOpenAI、Google、Anthropicや中国のDeepSeekなどが開発している。 ↩
-
フロム・スクラッチ(From scratch):本稿では、既存モデルの学習済み重みを引き継ぐことなく、重みを初期化して事前学習を行うことを意味する。公開されているコードや構造、学習データを一切参照しないという意味ではない。 ↩
-
ガラパゴス現象(ガラパゴス症候群):ガラパゴス諸島の生物が大陸から隔離されて独自に進化したように、特定の国の技術が国内市場のみに最適化され、世界標準と互換性を持たなくなる現象。日本の従来型携帯電話(ガラケー)や、韓国のActiveXが代表例。 ↩
-
ファインチューニング(Fine-tuning):事前学習済みのAIモデルに、特定分野のデータを追加して学習させる手法。ベースとなるモデルの性質を引き継ぎ、追加コストや利用条件はモデルや学習範囲によって異なる。 ↩
-
HBM(High Bandwidth Memory、広帯域メモリ):AIモデルのトレーニングや推論に用いられる超高速メモリチップ。複数のメモリチップを積み重ねて広いデータ伝送経路を確保する構造で、サムスン電子、SKハイニックス、Micronなどが供給している。 ↩
-
テストベッド(Testbed):新しい技術やサービスを実際の環境で試験できる舞台のこと。韓国のようにAI導入に積極的な市場は、グローバルAI企業が新製品を検証するのに適した環境である。 ↩
あわせて読みたい過去の号
リリースからわずか3日でアクセス停止となったFable 5
米国政府の指針によりFable 5とMythos 5への顧客アクセスが停止されました。単一モデルへの依存がもたらす運用リスクと、ソブリンAI論議への影響を掘り下げます。
社会AIで作業が速くなった後、組織の成果を確認する方法
1979年のオフィスオートメーションとAI導入事例を通じて、作業速度、生産性、組織変化の関係を見てみます
社会7月の画像フィルタリング拡大、コストと効果を検証すべき理由
7月から約80の事業者の公開画像に、不法撮影物との照合義務が拡大されます。適用範囲や運用コスト、Apple・EU事例との違いを見ていきます。
社会
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。