

Twitch的AI训练设置,与靠免费打扫收集数据的Shift
对比Twitch的AI训练退出机制与纽约的免费保洁服务Shift,剖析同意授权者与数据实际生产者相分离的深层结构。
社会Twitch默认开启了AI训练
Twitch昨天新增了一项设置。名称叫“生成式AI训练”,位置在安全与隐私标签页的最底部,默认状态是“开启”。这意味着亚马逊将利用Twitch直播来训练生成式AI,如果不愿意,用户必须亲自找到该入口手动关闭。
首席产品官迈克·敏顿(Mike Minton)在被问及为何不采用选择加入(Opt-in)1机制时回答道:如果是选择加入,就没人会同意了。
然而就在相近的时间,纽约却有人排起长队,愿意让戴着摄像头的陌生人进家门。条件仅仅是一次免费打扫。
重要的不仅在于新增了一项设置,更在于这项设置背后的结构:按下同意按钮的人,与真正创造训练数据的人,并不是同一批人。
Twitch的拒绝训练设置到底管多宽
8月12日Twitch发布的公告内容并不是“从现在起开始训练”,而是“新增了可以拒绝训练的设置”。看起来只是一句话的差异,顺序却颠倒了。因为训练早已是既成事实,新增加的不过是拒绝权。
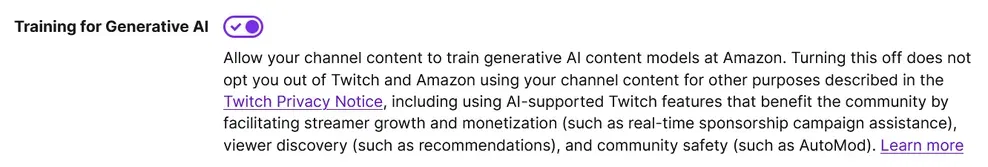 事实上,明顿(Minton)曾在2024年的一次媒体活动中,被问及亚马逊是否利用Twitch训练AI时,给出了肯定的回答。训练大概在两年前就已经开始了,而拒绝设置则是很久之后才出现的。
即使关掉,也不是全部关闭。自动字幕或AutoMod等功能仍然会继续运行。Twitch对此的解释是,这些功能不会保存数据用来生成新内容。换句话说,这次开关所阻断的仅仅是生成式模型的训练,而不是对AI利用的全面禁止。
其范围非常宽泛。涵盖实时直播及其聊天记录、往期直播回放(VOD)、剪辑与精彩片段,甚至还包括发布在频道上的文本和图片。主播数年来积累的全部记录,都被捆绑在这一个设置之中。
反应非常迅速。公告发布仅几小时内,要求改为选择性加入(Opt-in)的论坛帖子里就聚集了将近1.4万张赞成票。而在主播出面进行直播说明的场合,有将近3000人涌入,用反对意见刷满了聊天窗口。
到这里为止,都是在其他平台也见过的类似走势。而在这份公告中,有两个细节格外让我感到不安。
第一,我的聊天记录是否被用于训练,取决于主播的设置。 在别人直播间发送的聊天内容,遵循的是该主播的设置。即使我在自己的账户中关闭了开关,只要我去应援的主播开启了该设置,我在那里留下的语句就依然是训练对象。
第二,直播画面中还包含其他权利人的著作权作品。 画面上显示着游戏公司的著作权作品。一位游戏行业分析师提出了这样的疑问:如果创作者在开启设置的状态下直播别人的游戏,会怎么样?尽管设置挂在个人账户下,但随着该设置被用于训练的数据中,却一同包含着其他公司的作品。
而且,当被问及此前是否已被用于训练时,明顿回答说不知道。也就是说,连他自己都不清楚亚马逊用了什么、没用什么。这同时也意味着,管理同意权的公司,却无法追踪同意所带来的后果。
纽约的免费保洁
有一家公司用完全相反的方式来解决同样的问题。
Shift 在纽约提供免费的家庭保洁服务。作为交换,前来进行保洁的人员会佩戴头显摄像头,以第一人称视角拍摄工作画面。这些聚焦于手部与动作的视频将成为训练家用机器人的操作数据2,公司再将其匿名化后授权出售给 AI 与机器人公司。运营方是德国的 MicroAGI,纽约只是起点。他们已宣布将扩展到旧金山、伦敦、苏黎世和慕尼黑,并涉足管道维修和烹饪领域。
 我们来看一组数字。在纽约,一次标准公寓保洁的费用大约在 150~250 美元,约合 20 万~35 万韩元。在我看来,这种结构本质上相当于公司为了获取数据而承担了保洁费用。网络文本大多已被收集殆尽,而真正杂乱房屋的实拍视频很难仅凭模拟器生成。
隐私方面的说明也相当详尽。他们表明会自动遮蔽面部与姓名,并对屏幕、身份证件、纸张及手机上显示的个人信息进行模糊处理。摄像头本身也专为聚焦于清洁人员的双手和操作而设计。然而,其常见问题解答(FAQ)中也有一句话指出,处理过程中视频会与标注3人员共享。这意味着,在自动化匿名处理的背后,依然会有人看到屋内的景象。
市场的反响也值得关注。据悉上线短短数小时内就涌入了数千份预约。不过该数字来自公司与行业媒体的报道,并未经过独立验证。但无论如何,趋势是明确的:即便条件是允许佩戴摄像头的人一路进入卧室,人们依然报名了。
拿这与明顿的话对比一下。他说如果实行自愿加入就没人会做,但在纽约,一旦附带了免费保洁的回报,人们便纷纷申请。阻碍人们参与的,似乎并不是缺乏同意的意愿,而是没有给出对应的数据对价。
做出同意的人,与留在数据里的人并不相同
将这两个案例并置在一起,能看到相同的结构。
在 Twitch 上拨动开关的是主播。然而,积淀在那场直播里的数据,绝非主播一人创造。其中有发弹幕聊天的观众,有撑起画面的游戏厂商。同意是由一个人做出的,可被提供出去的资产却属于多个人。
在 Shift,走完相当于同意书流程的人是屋主,享受免费保洁服务的人也是屋主。但是,把摄像头戴在头上的人并不是屋主,而是前来进行保洁的人。并且,那些视频最终瞄准的去向是家用机器人——也就是眼下正在从事这项工作的那份职业。
在这里我想避免误解。我并不是说这种结构就等同于剥削。保洁人员是拿报酬工作的。公司另外还运营着按件向拍摄贡献者支付报酬的项目,并宣称参与者在 2026 年第一季度拿到了超过 500 万美元。虽然这是公司的单方面宣称,需要谨慎看待,但“存在报酬”这一事实本身,确实与 Twitch 有所不同。
我想指出的其实是另一个层面:同意只向个人索取一次,可数据却是在有多人共存的现场生成的。
在“家庭”这个现场,至少存在三个主体:做出同意的人、被拍摄的人、日后将受到影响的人。在“直播”这个现场,同样存在三个主体:开播的人、发弹幕的人、提供版权内容的公司。然而我们拥有的工具,却仅仅是挂在个人账户上的一个开关。试图用一个设置装下三个主体的处境,即便关掉了,反映的也仅仅是一部分。
那么,为什么“个人开关”这种形式会层出不穷?因为做起来容易,也最方便转移责任。一旦提供了这个设置,公司便可以说自己已经给予了选择权,而没关掉的人则被默认处理为同意。数据流转的方式毫无改变,唯独需要承担解释说明的责任,从公司身上转移到了用户这一端。用户觉得自己拥有选择权,但实际上能决定的范围却极其狭窄。
契约结构也让这种落差变得更加悬殊。Shift 明确声明自己既不是保洁公司也不是雇主,而是一家技术平台;保洁人员则是由合作方认证的独立承包商。作为拍摄对象的劳动确实存在,但在文件上,雇用这一劳动的责任主体却等于不存在。Twitch 也类似,同意是拿到了,却声称不知道亚马逊究竟用了什么。两边都是如此:同意被收了上来,责任却四散飘零。
韩国平台与制度如何应对
对韩国创作者来说,这次的开关可能显得事不关己。因为 Twitch 早在 2024 年 2 月 27 日就退出了韩国业务。既没有可以关掉的开关,也没有可以保留开启的开关。
然而,填补这一空缺的平台已经在以不同方式面临同样的问题。
CHZZK 的“Magic Voice”可以用当红主播的声音朗读打赏留言。由此产生的额外收益会支付给提供声音的主播。这是一种将单独同意与收益结算绑定在单一功能上的架构。SOOP 的 AI 房管“Ssalsa”则通过学习主播的直播节奏与说话口吻,在主播离席时替其继续与弹幕互动。从训练对象不是内容而是人的说话风格这一点来看,这甚至是一个更为超前的案例。
监管制度的方向也不尽相同。韩国在个人信息处理上坚持事前同意原则,个人信息保护委员会还在 2024 年专门出台了将公开个人信息用于 AI 训练时的规范标准。在这样的环境下,美式的“默认开启”很难被直接移植过来。
不过,即便有了制度,前文提及的问题也不会自动迎刃而解。在主播同意提供的训练数据中,同样混杂着观众发送的弹幕。AI 房管所习得的口吻中,也包含着那场直播中相互往来的对话。做出同意的人与创造数据的人并非同一人,这一现实无论在首尔还是在纽约,都别无二致。
Oswarld视角
在制定 GTM 策略的过程中,我多次审阅过数据获取计划。在这些计划中,有一个反复出现的场景:服务器成本、标注费用、人工成本全都罗列得清清楚楚,唯独原始数据的获取成本被定为 0。原因很简单:用户已经在我们的服务之中,只要在条款里加一句话就行了。
一旦把获取单价定为 0,接下来的走向便成定局。既然同意率直接等同于获取量,UI 设计自然就会朝着同意率最大化的方向倾斜。这也正是 Minton 的言论听起来并不像失言的原因所在。那绝非一时口误,而是由数据获取目标倒推出来的必然结论。
我之所以把这两个案例放在一起对比,原因就在这里。Shift 为了获取数据,提供了保洁这一对价。 这是寄望于通过出售数据来收回该项成本的商业模式。相反,Twitch 坐拥全球规模最大的创作者视频,却始终未能给自己的内容贴上价格标签。所以他们选择默认开启。
我认为今后这一差异将拉开公司之间的距离。试图仅凭条款来获取数据的公司,日后可能会失去用户的信任。而明确并支付对价的公司虽然前期会有成本支出,却能为下一次以何种价格提供何种内容保留谈判的基准。
因此,实务中需要提出的问题也必须改变。不再是“是否获得了同意”,而是“我们获得的同意单位,是否与数据的单位相契合”。如果我们服务所收集的数据中,混入了未经同意的第三方的贡献份额,那么在成为法务风险之前,它本身就是一种设计缺陷。
结语
第一,我认为 Twitch 的默认设置不仅是同意的问题,更是为数据支付何种代价的问题。第二,纽约的案例表明,只要明确了对价,人们是愿意选择加入(Opt-in)的。第三,这两个案例中,做出同意的人与数据中包含的人都未能完全重合。仅仅依靠个人账户的设置,根本无法反映他人的意愿。
建议大家本周不妨尝试一件事:在您目前就职的公司或正在使用的服务中,挑选一个收集数据的节点,把所有涉及的人都写下来。同意的人、创造数据的人、日后会受到影响的人。如果这三栏里的名字各不相同,就需要确认究竟遗漏了谁的同意与权利。
在您免费使用的服务中,是否有过“虽然是我点了同意,但真正产出数据的却不是我”的经历?那是哪项服务的哪个环节呢?欢迎在评论区告诉我。如果收集到的案例足够丰富,我会在下一期按类型为大家做整理。
💬 欢迎在评论区分享针对上述问题的案例 · 📨 如果您身边有人正处于这种结构之中,欢迎转发分享


参考资料与延伸阅读
核心来源
- Amanda Silberling, “Amazon will train on Twitch streamers’ content by default, unless they opt out”, TechCrunch, 2026. 链接 ··· 最详尽梳理明顿言论的前后背景与公告定调的文章。
- “Twitch under fire for new gen AI training system that harvests streamer data for Amazon”, PC Gamer, 2026. 链接 ··· 指出游戏厂商版权物一并被卷入问题的段落,正是本文第3章的切入点。
- “How to stop Twitch from training AI on your streams”, Engadget, 2026. 链接 ··· 梳理了选择退出究竟能关掉什么、关不掉什么。
- shift, “Free Home Cleaning in NYC” 官方网站及 FAQ, 2026. 链接 ··· 拍摄方式、去标识化流程及合同关系均在 FAQ 中直接载明。建议阅读第3章前先浏览。
- John Koetsier, “Physical AI Data Is So Valuable This Startup Cleans Your Home For Free”, Forbes, 2026. 链接 ··· 剖析清洁劳动与机器人训练关系的段落,与今天的交汇点高度契合。
背景知识
- 个人信息保护委员会,《用于人工智能开发与服务的公开个人信息处理指南》,2024. 链接 ··· 可以了解韩国是以何种标准处理 AI 训练数据的。
- 《离开韩国的 Twitch,韩国今后的流媒体直播将如何演变?》,KISO Journal, 2024. 链接 ··· 梳理了 Twitch 退出后韩国本土流媒体直播版图如何重组。
往期推荐
- 我的书拿到了版权费才卖掉 ··· 如果说今天的文章探讨了同意的结构,那期讨论的则是同意之后的价格。建议连贯阅读。
- 给机器人起名并塞入钱包的 Cloudflare ··· 站在对立面、试图向索取数据的一方收费的尝试。

📝 术语说明
注释
-
选择加入 / 选择退出(Opt-in / Opt-out):选择加入是指只有在用户主动同意时数据才会被使用的方式;选择退出则是默认使用、用户如不情愿可自行关闭的方式。即便是相同的功能,将哪一方设为默认值,参与率都会产生巨大悬殊。 ↩
-
操作数据(manipulation data):用于让机器人学习抓取、擦拭、搬运物品等动作的训练数据。以第一人称记录人类双手与视线的视频最为典型;环境越是接近真实住家般杂乱,其价值往往越高。 ↩
-
标注(annotation):在原始数据上添加“这是杯子”、“这是擦拭动作”等描述说明,将其转化为可供算法训练形态的作业。大多由人工核对操作,因此也意味着在完成去标识化处理后,依然会有人审阅这些视频。 ↩