

谷歌为何先推金融与法律:合格标准已明文写就的行业
据OpenAI统计,法律岗位的Codex用户数在6月较2月激增108倍。虽然基数效应下绝对量并非第一,但相对排位是一个信号。本文剖析了谷歌选择金融与法律作为首批垂直专精对象的原因。
商业法律岗位的Codex用户数较2月暴增108倍
在上周四的一期中,我曾与大家分享过法律AI公司Harvey在短短两个月内构建出自有模型的故事。当时留下了一个未及探讨的问题:为什么偏偏是法律?
一半的答案其实在那三天前就已浮出水面。8月25日,谷歌云(Google Cloud)发布了首批面向垂直行业的Gemini Enterprise,一共只有两个领域:金融与法律。
另一半答案,则藏在OpenAI于8月12日更新的企业使用数据中。那是一张呈现2026年2月至6月期间、企业客户各岗位周活跃Codex用户增长倍数的图表。排在最顶端的并不是工程研发。
而是法律岗位,整整108倍;而工程研发只有5倍。
Codex是一款编写代码的工具,律师自然不可能去写代码。因此,今天我们就从这种“错位”讲起。这并不是一个法律界突然对AI敞开心扉的故事,而是想说明:智能体(Agent)最先扎下根来的地方,绝非最狂热拥抱AI的岗位,而是那些“何为合格成果”早已被明文写进文档的行业。
在全盘相信108倍之前
我们先来仔细审视这个数字。这是以2026年2月1日为基准(设为1),绘制到6月的倍数。
| 职能 | 相较于2月的倍数 |
|---|---|
| 法律 | 108倍 |
| 销售 | 41倍 |
| 招聘 | 41倍 |
| 市场营销 | 26倍 |
| 医疗健康 | 24倍 |
| 财务·会计 | 20倍 |
| 工程技术 | 5倍 |
介绍这张图表的a16z自己也加上了注脚:“这种变化在多大程度上是因为Codex本身的推广普及,仍是一个值得探讨的问题。”我想在此再补充一句:这是倍数,而不是绝对量。
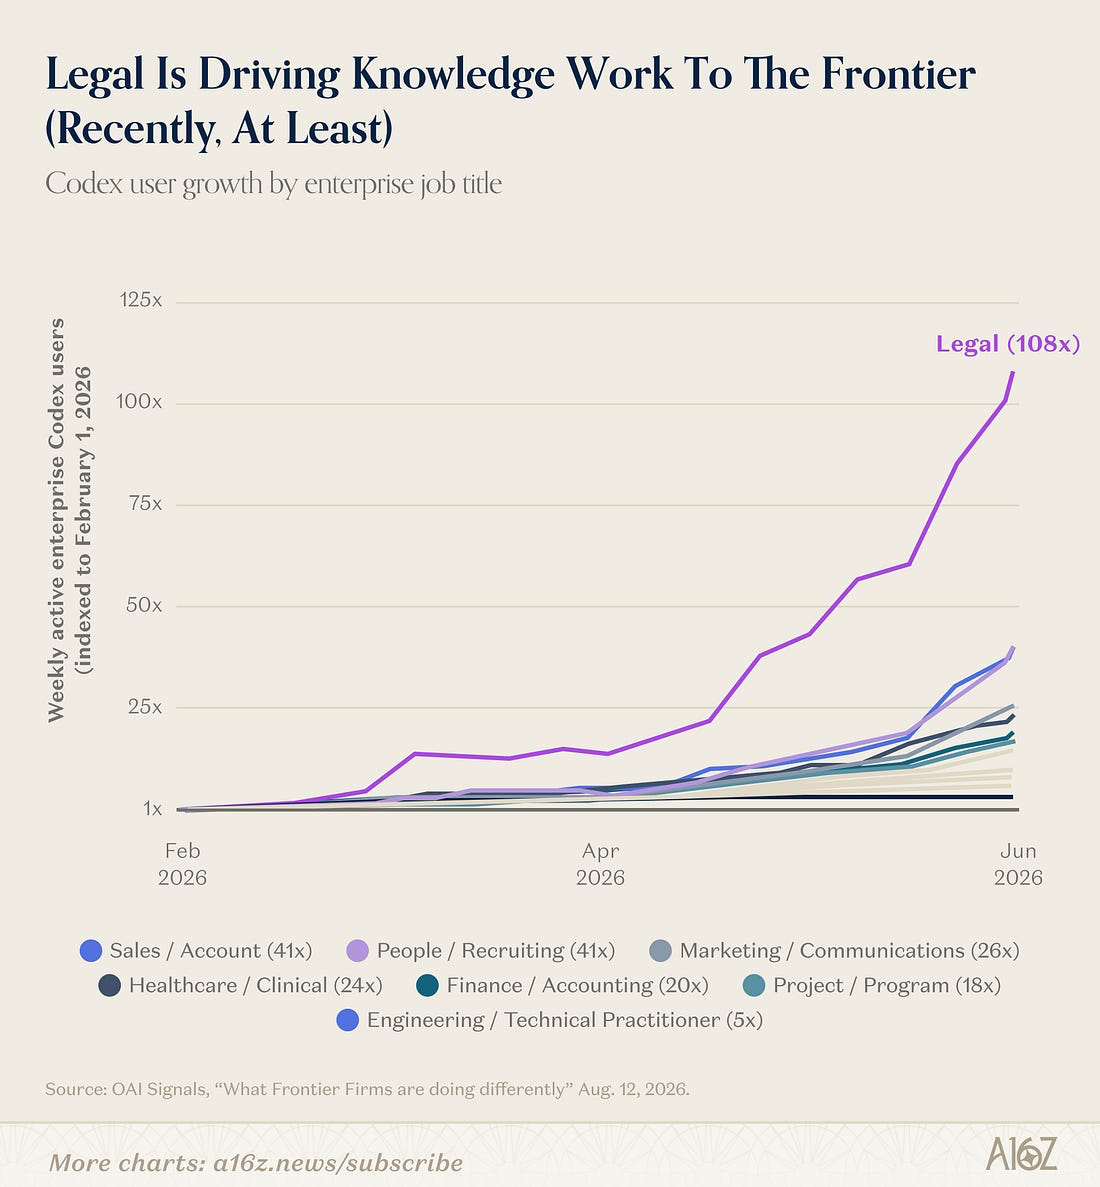
那么这张表留给我们的核心价值是什么?我认为是相对排位。
Codex的扩大上线并不是只对法律职能开放的。销售、市场营销、财务,大家面对的窗口完全相同。大家同样是从极低起点出发,为什么偏偏法律职能是108倍,而市场营销是26倍?这4倍的差距不能用“大门被打开了”来解释。在大门敞开之后,问题在于究竟是谁先跑了进去。今天的文章,就是要回答这一个问题。
还有一点需要指出。同一份报告显示,截至6月,Codex在企业客户的Codex与ChatGPT合计输出Token中占比高达64%。这意味着,比起获取问题解答的“对话”,Token更多地被消耗在交付任务并由其执行处理的场景中。法律职能开启的并不是编程工具,而是智能体(Agent)。
谷歌的首批行业特定版本是金融与法律
8月25日,谷歌云(Google Cloud)同时以预览版形式发布了 Gemini Enterprise for Financial Services 和 Gemini Enterprise for Legal。这是其行业特定版本的首批两款产品。医疗健康与生命科学领域则仅标注为“即将推出”。
两款产品的架构完全相同,分为四个层级:行业领域技能、MCP1 连接器、实际执行任务的智能体,以及合作伙伴生态系统。
金融领域的招牌产品是 Financial Research 智能体。它自带50多项预置技能,能够处理信用风险评估、投资组合监控、KYC、债券发行等工作。谷歌表示,已将复杂债券投资组合的风险敞口分析时间缩短至5分钟以内。与之连接的数据来源包括 FactSet、Moody’s、MSCI、PitchBook、Guidepoint、Dun & Bradstreet 和 SEC EDGAR 等。
法律领域则涵盖合同审查与标红修改(Redlining)、指南手册2编制、监管监控、法律检索以及 DSAR3 应对。连接对象涵盖 iManage、NetDocuments、DocuSign、Everlaw、RelativityOne、Thomson Reuters HighQ,乃至免费判例数据库 CourtListener。Cleary Gottlieb、Freshfields、Weil、Williams & Connolly 参与了开发,金融领域则有德意志银行和芝加哥商品交易所集团(CME Group)加入。
到这里为止,还只是一篇普通的企业级产品发布公告。真正让我驻足审视的是接下来的内容。
金融智能体在输出结果时,会同时给出置信度评分、明确的方法论、用于审计的数据快照,以及精准的来源引用。而在数据治理条款中,有这样一句话:“获得许可的数据保持许可状态,受权限限制的数据保持受限状态。”
核心在于,这并不是新拟定的产品规格,而是将职业规范原封不动照搬过来的表述。
凡是“何为合格”已成文的职业,Agent都会率先入局
把这两组信号叠加在一起,全貌就清晰了。
法律与金融并非天生偏爱AI的行业。相反,它们长期以来背负着保守的名声。然而,这两个职业拥有其他领域所不具备的三大特质。
第一,产出物皆为文本。 合同、备忘录、意见书、研究笔记,完全就是Agent可以直接生成的形式。
第二,“何为合格”早已落在纸面上。 律所拥有逐条对照的策略手册(Playbook),银行拥有KYC核查清单与审批标准表。长达数十年的规章与先例早已层层沉淀。而这恰恰是训练和评估Agent所必需的核心素材。我们在上一期曾提到,Harvey亲自构建了1750个工作环境和7.5万项评估指标来训练模型。而法律这一行业,从一开始就坐拥那份评分表的原始底本。
第三,提供依据本身就是职业规范。 律师从来不会毫无出处地提出主张;分析师向来必须公开方法论。因此,“引述来源、明晰方法论、审计追踪”绝非后来强加给AI产品的安全补丁,而是这些职业本就要求的产出物规格。
因此,Google选择金融与法律作为首批切入目标,绝不仅仅是因为市场规模庞大。他们是从能够对Agent的结果进行评估打分的产业切入。因为在无法评估打分的行业中,Agent到底做得好不好,根本无人知晓。
竞争的关键不在模型性能,而在数据访问权
在这次发布中,最耐人寻味的名单是法律连接器名录。Harvey 和 Legora 赫然在列。
这两家公司是法律 AI 市场的代表性竞争对手。Harvey 在今年 3 月获得了 110 亿美元的估值,Legora 则在 4 月获得了 56 亿美元的估值。然而谷歌并没有排挤它们,反而通过连接器将它们纳入怀中。以 Legora 为例,只要双方客户批准,用户就可以在 Gemini Enterprise 内部使用 Legora 的部分功能,而 Legora 的信源引用与接地(grounding)4机制也将原样保留。行业媒体 Artificial Lawyer 将此解读为“不是竞争,而是生态系统”。
我的看法略有不同。一旦通过连接器接入,用户每天面对的界面就变成了谷歌的产品,法律 AI 公司则退化为在幕后提供功能的一方。平台并不驱逐竞争对手,而是将其收编为合作伙伴,顺势夺走与用户直接接触的触点。
而且 Harvey 已经给出了自己的答案。正如我们在上一期中所讨论的,Harvey 在短短两个月内就推出了自研模型 Tenet,并明确将“让律所拥有属于自己的智能”确立为目标。从时间线上看更为清晰:Harvey 的发布是在 8 月 18 日,而谷歌的发布是在 8 月 25 日。在自己的名字登上连接器名单的一周前,它就已经抢先表态,拒绝沦为零部件。
因此,如今法律与金融 AI 的竞争,正发生在模型、评分环境和数据访问权这三个层面。
| 层级 | 拥有方 | 正在出售的东西 |
|---|---|---|
| 模型 | 谷歌、OpenAI、Anthropic | 智能本身。两个月就能重新揉捏成型的消耗品 |
| 评分环境 | Harvey、Legora | 懂得什么是合格标准的能力 |
| 访问权 | FactSet、Moody’s、iManage、Thomson Reuters | 原始数据以及附着其上的权限 |
谷歌推出的,正是将这三个层级统一在单一权限体系下加以连接的产品。上一期我们曾总结过“消耗品是模型,资本品是环境”,而这次发布又在此基础上添了一句:**仅次于环境的最昂贵之物,是访问权。**无论多么出色的 Agent,如果无法严格按照原有权限读取 iManage 内部的文档,律所就根本无法使用它。
韩国早已开始三轨并行
这段讨论听起来并不像远在天边的他国故事,其来有自。
太平洋律师事务所在 7 月成为韩国首家全所引入 Harvey 的律所,并在 8 月成为韩国首家全所引入 ChatGPT Enterprise 的大型律所。本土判例检索则单独使用 LBox 和 SuperLawyer。国际合同用 Harvey,本土判例用韩国法律科技产品,文书撰写与翻译用通用 AI——这已经是三轨并行了。
Google 销售的,恰恰是叠加在这一“三轨”之上的治理层。它不是再多增加一个工具,而是让所有增加的工具都能在同一套权限规则下运行的管理层。
因此,当前韩国机构所需要的追问并不是“买哪款 AI”,而是两个核心问题:
第一,我们机构的重复性业务是否有“评分表”?
合同审查操作手册、审核基准表、验收核对清单。如果没有这些,无论采购什么工具,都无法判定产出结果是否合格。无法判定,就无法放手委托,最终还是得由人工从头重读一遍。法律和金融行业之所以走在前面,原因就在于此。制定这份评分表并不是 AI 项目,而是业务定义项目;它耗费的不是 IT 预算,而是业务一线人员的时间。
第二,要接入智能体的系统是否具备权限体系?
只要是内部文档散落在个人电脑和即时通讯软件中的机构,立刻就能明白为什么 Google 发布说明中“设有权限的数据依旧保留原有权限”这句话是产品的核心。律所正因为在使用 iManage,连接器才得以成立。如果文档本身没有权限控制,根本就没有可供接入的地方。韩国机构面临的瓶颈,往往不在于模型性能,而恰恰在这里。
结语
总结起来有三点。
第一,法律行业 Codex 用户增长 108 倍是一个夹杂着较大基数效应的数字。但在相同条件下领先其他职业 4 倍的相对排名,才是真实的信号。
第二,谷歌之所以选择金融和法律作为首批特定行业目标,是因为这两个行业已经拥有为智能体成果进行评分的标准。
**第三,**竞争格局已从模型性能转向数据访问权与权限体系。谷歌将 Harvey 和 Legora 作为连接器纳入麾下,而 Harvey 恰好在此一周前以自研模型做出应对,正是这一点的明证。
我建议您本周不妨尝试做一件事:在组织中选出最常重复的三项工作,分别用五行字写下“出现怎样的结果才算合格”。有了这五行字,就能确认成果是否合格并托付工作;若是没有,那就只会徒增工具。法律行业之所以走在前面,正是因为他们早已拥有了这五行字。


参考资料与延伸阅读
核心来源
- OpenAI, “Enterprise signals: What frontier firms are doing differently”, 2026.8.12 更新。··· 108 倍这一数字的一手来源。不仅有各职能的倍数,还建议大家一同阅读“前沿企业 = 月度 AI 用量排名前 10%”的定义,以及作者自身注明的“Token 是衡量业务价值的不完备指标”这一限定条件。
- a16z, “Charts of the Week: Winds of Thematic Change”。··· 介绍该图表的文章。值得注意的是,作者们亲自标注了“这在多大程度上归因于 Codex 的扩大推出仍有待商榷”这一附带说明。
- Google Cloud, “Introducing Gemini Enterprise for Legal”, 2026.8.25。··· 建议亲自去查看连接器名单中 Harvey 和 Legora 赫然在列的段落。今天文章的第 4 节就出自该名单。
- Google Cloud, “Introducing Gemini Enterprise for Financial Services”, 2026.8.25。··· 50 多项内置技能、置信度评分与审计快照,以及“获得许可的数据仍保持其许可状态”这句话都在这里。
- Artificial Lawyer, “Google Launches Gemini Enterprise for Legal”, 2026.8.25。··· 业内将这一发布解读为“生态系统”而非“竞争”的佐证。与我的解读角度相反,建议结合起来看以便自行判断。
背景知识
- ZDNet Korea, “OpenAI 迈入律所市场……会成为通用 AI 扩散的信号弹吗”, 2026.8.5。··· 梳理了泰平洋律师事务所在全公司范围内引入 ChatGPT Enterprise 以及“专业 AI + 通用 AI”并行架构的情况。如果想了解韩国本土背景,可以从这里入手。
- 《法律新闻》, “泰平洋在全公司范围内引入法律 AI ‘Harvey’”, 2026.7。··· 韩国国内律所首次在全公司引入 Harvey 的案例。
- TechCrunch, “Legal AI startup Legora hits $5.6B valuation”, 2026.4.30。··· 谷歌作为连接器纳入麾下的两家公司此前究竟在进行怎样的缠斗,其背景尽在此处。

📝 术语说明
注释
-
MCP(Model Context Protocol):标准化 AI 连接外部系统数据与功能方式的协议。它更像是使用符合规格的插座,而不是为每个服务单独铺设电线。 ↩
-
审查规范(Playbook):律所或企业法务团队针对各合同条款预先制定的内部基准表,明确规定“哪些可以接受,哪些必须修改”。对人类而言是操作手册,对 AI 而言则是评分标准。 ↩
-
DSAR(Data Subject Access Request,数据主体访问请求):个人向企业要求“告知其如何持有本人个人信息”的权利。由于受答复期限限制且需要翻遍全公司所有文档,这是一项典型的人工处理成本极高的工作。 ↩
-
Grounding(事实锚定):为防止 AI 捏造回答,将其回答绑定在真实文档依据上并同时提供出处的方式。如果找不到依据文档,选择不作答反而更安全。 ↩