

韓国のAI投資計画、設備と運用技術を共に見据える必要があります
DeepSeekとSakana AIの開発手法、韓国の半導体・データセンター投資計画を比較しました。設備投資を実際のサービスへと結びつける運用力の重要性を考察します。
社会大規模な設備投資とともに確認すべきこと
過去2回のニュースレターで、私は同じ問いを二つの国に投げかけました。
日本編では、Sakana AIが既存のモデルを組み合わせて性能を高めるアプローチを取り上げました。小規模な調整モデルであっても、すでに開発された大型モデルの強みを活かせるという考え方でした。この手法は、自前で大型モデルを開発する道以外にも選択肢があることを示しています。
9,000億ウォンを手にして去った研究者、東京に残った138人既存モデルの組み合わせと改良に注目した研究所韓国編では、国内におけるAI活用への高い関心が開発力へとどう結びつくかを論じました。独自モデルを自前で開発することと、海外モデルを巧みに使いこなすことの間で、投資の優先順位をどう考えるべきかという考察でした。
チャットボットに四柱推命を尋ねる国、AI第3位になるには?AI活用への関心を産業競争力へ結びつけるにはその後、6月29日に韓国の産業通商資源部が関係省庁とともに「大韓民国大跳躍3大メガプロジェクト」を発表しました。南西圏における800兆ウォン規模の半導体生産拠点構想、企業による第1段階550兆ウォンのAIデータセンター投資、そしてフィジカルAIの育成計画が盛り込まれました。これは韓国のAI政策全体を代替する単一の戦略ではなく、半導体・製造・データセンターを軸に据えた計画です。
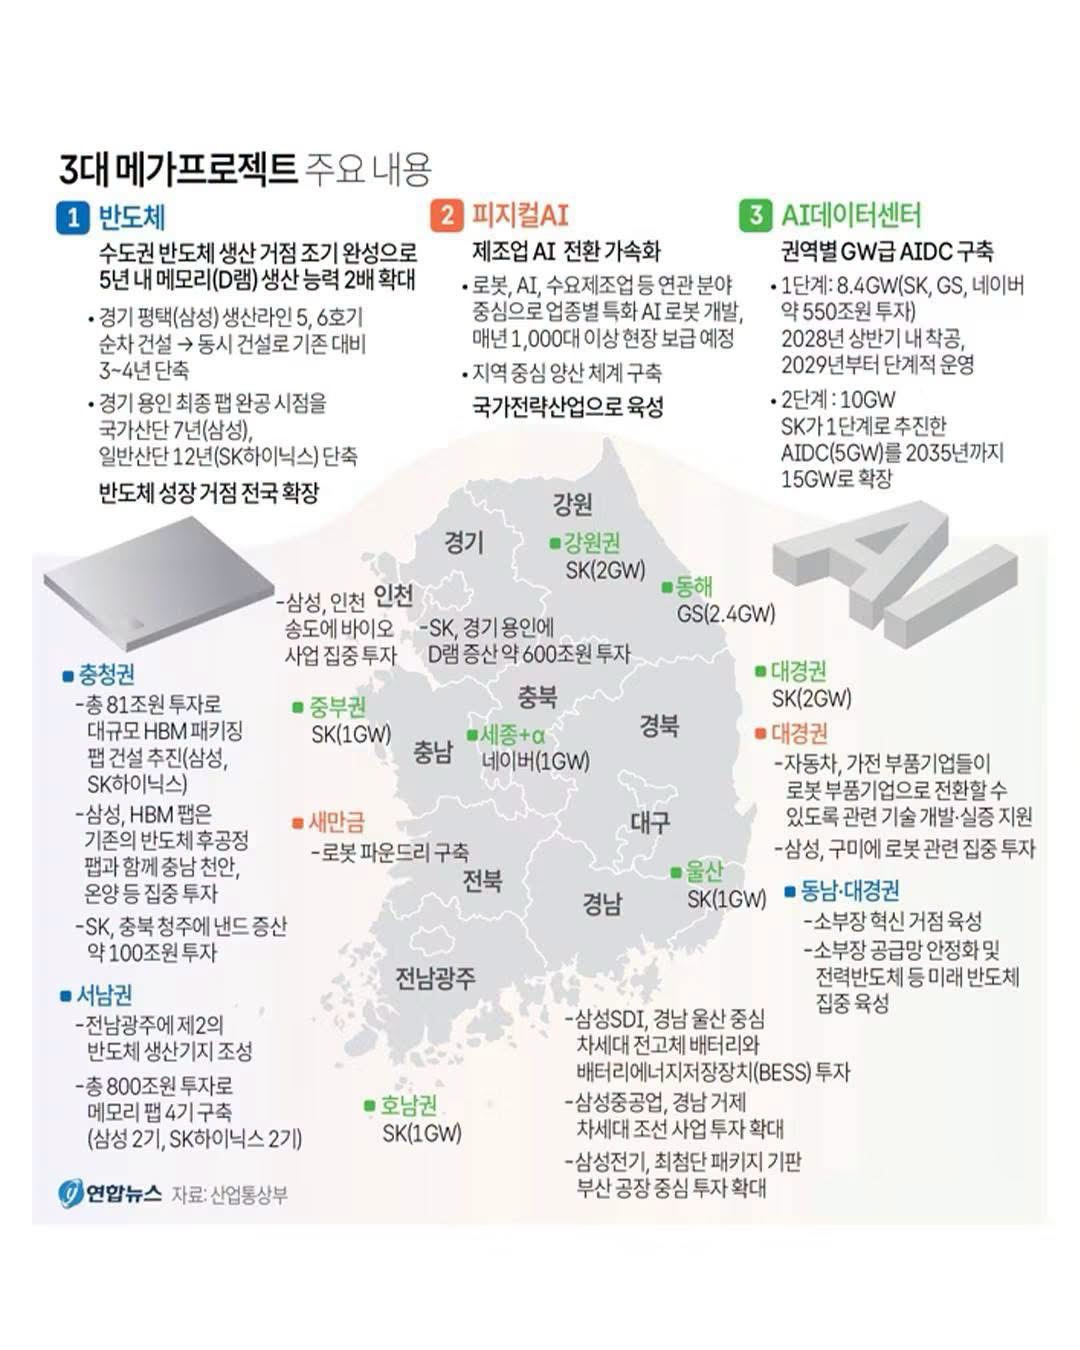
本日は、前2作に続いてこの計画を読み解いていきます。DeepSeekやSakana AIが開発効率を高めている手法も併せて見ていきます。両社の戦略をそのまま中国や日本全体の戦略として一般化することは避けつつも、韓国が参考にできる選択肢を比較検討してみたいと思います。
開発効率、モデルの組み合わせ、製造インフラの比較
AI事業には、モデルの学習、実行コストの削減、複数モデルの組み合わせ、半導体やデータセンターの運用など、多様な取り組みが必要です。互いに代替し合う部分もありますが、同時に改善していかなければならない領域も多く存在します。
🇨🇳 DeepSeekが追求する開発・実行効率
DeepSeekは、計算効率を高める手法で注目を集めました。2024年末のV3技術レポートには、H800を2,048基用いて学習した構成が示されています。これは2025年1月に公開された推論モデルR1の全開発リソースと同義の数値ではありません。2026年4月には100万トークンのコンテキストに対応したV4を公開し、6月には応答生成を高速化するDSparkを発表しました。最大85%とされる改善幅も、特定の比較条件下での結果です。1
DeepSeek、Qwen、GLMなどがモデルの重み公開と安価なAPIによって利用者を増やしている姿も見られます。推論コストが実際のサービス普及において重要になった事例です。一方で、中国の一部のデータセンターで需要不足と低い稼働率が報告されました。2 これを、中国全体が学習投資を中断した、あるいはデータセンターの80%が稼働していないという意味に解釈すべきではありません。
[アン・グァンソプ(安光涉)AIジンテーゼ] 米国企業が中国AI企業にお金を送る理由Uber(ウーバー)が今年AIコーディングツールの予算をわずか4カ月ですべて使い果たした。約5,000人のエンジニアがエージェンティック・コーディングツールを使い始め、月額利用料がエンジニア1人あたり150ドルから多くは…🇯🇵 Sakana AIが開発したモデル組み合わせサービス
Sakana AIは、すでに学習されたモデルを改良し組み合わせるポストトレーニング3に注目してきました。6月22日には、複数のモデルを選択して接続するFuguサービスをリリースしました。これはSakana AIの事業戦略であって、日本がモデルの直接開発を諦めたという意味ではありません。
Fuguはリクエストに合ったモデルを選択し、Fugu Ultraは複雑な作業を複数のモデルに分散して任せた後、結果を検証・統合します。Sakana AIが公開した評価では、主要なコーディング・推論ベンチマークで高い性能を示しました。ただし自社評価であり、比較モデルのスコアには各プロバイダーが発表した数値も含まれています。Fable 5とMythos Previewは実際に呼び出すモデルリストには含まれていませんでした。4
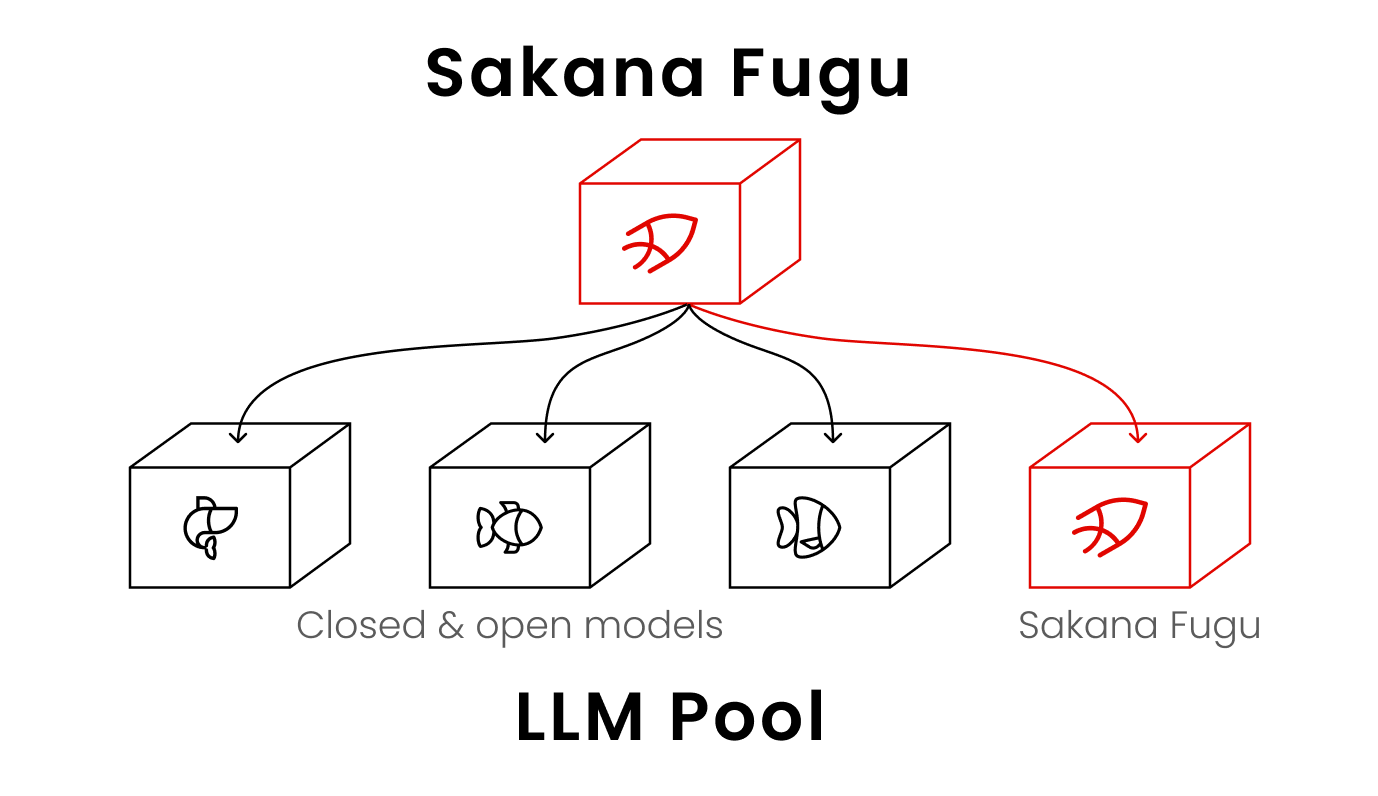
呼び出すモデルを変更できれば、特定のプロバイダーへの依存を減らすのに役立ちます。ただし、別のモデルに変更した後も同じ性能とコストを維持できるかは改めて検証する必要があります。複数のプロバイダーが同時にアクセスを制限する可能性までなくなるわけでもありません。モデルを組み合わせる能力は、運用の自律性を高める一つの方法と見ることができます。
🇰🇷 韓国の半導体・フィジカルAI・データセンター計画
6月29日の発表は、韓国が強みを持つ半導体と製造業の基盤を拡大することに焦点を当てています。ハードウェアにとどまらず、フィジカルAIモデルの開発やクラウド技術への支援も網羅されています。
- 半導体: 南西圏に800兆ウォン規模のファブ4基と協力企業のエコシステムを造成し、首都圏の生産拠点を早期に完成させることで、5年以内にメモリー半導体の生産能力を2倍に拡大する計画です。
- フィジカルAI: 製造現場向けロボット、学習データ、中核部品、ファウンデーションモデルの開発と国内技術の実証を一体で支援します。
- AIデータセンター: SK、GS、NAVERが第1段階として550兆ウォンを投資して8.4GWを構築し、その後の拡張を通じて総計18.4GWを目指します。企業の投資計画は政府予算と区別して見る必要があります。
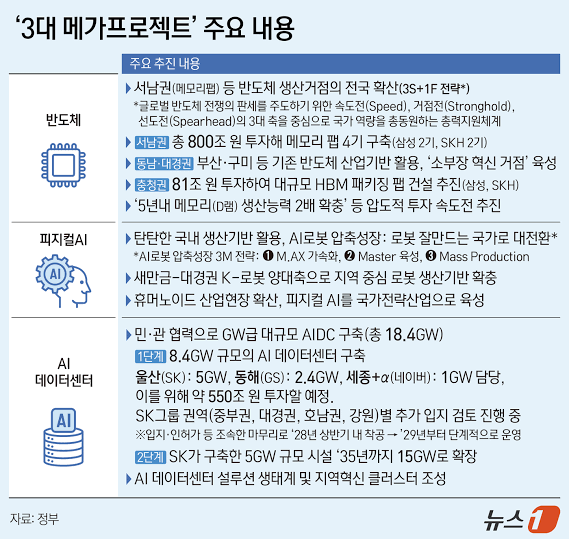
私が韓国編で提案したのも、半導体プロセスの最適化やバッテリーの品質管理のように競争力のある分野にAIを深く適用しようということでした。今回の発表の製造業AI転換(M.AX)やデータファクトリー構想は、その方向性と重なっていると見ています。
製造基盤を活用しようとする方向性は前向きに捉えています
私は、韓国が持つ生産能力をAI事業へと結びつけようとする方向性を前向きに捉えています。
大型の汎用モデル開発には莫大な資金と人材が必要です。韓国がすべての分野で米国・中国の先頭モデルと競争するより、すでに蓄積した強みに投資を集中する必要があると考えます。ただし、米国の民間投資額と韓国の政府予算のように範囲の異なる数値を割り算して競争力格差とする比較は適切ではありません。
フィジカルAIでは、製造データ、工程運用の経験、ロボットの普及基盤を活用できます。韓国の強みになり得る部分です。しかし、米国のビッグテックもロボットやフィジカルAIに投資しています。この分野は競合が関心を払わない空白市場ではなく、韓国が持つ経験を製品性能に結びつけて競争しなければならない市場です。
この方向性が成果につながるためには、設備とモデルを実際の現場で運用する能力も必要です。
モデル開発と運用の方式をともに検証すべきです
発表を読みながら私が気になったのは、複数のモデルをどのような基準で選択し、接続するのかという点です。政府の文書にはクラウド技術や国産NPUのエコシステム、フィジカルAIモデルの開発計画が含まれています。運用ソフトウェアが丸ごと抜け落ちているとまでは言えません。ただ、支援が実際の現場の運用方式にどうつながるかは引き続き確認していく必要があります。
Sakana AIのFuguは、既存のモデルを組み合わせる方式を製品にしました。韓国の発表は独自フィジカルAIモデルの開発も目標としています。2つの方式を互いに排除し合う選択肢と見るのではなく、どのような業務で自前モデルが必要で、どのような業務で外部モデルの組み合わせが有利なのかを比較できます。
この区分に関連して、今年1月にNAVER Cloudが「独自AIファウンデーションモデルプロジェクト」の評価から脱落した出来事を思い出しました。政府は、提出されたモデルが技術的・政策的な独自性基準を満たせなかったと説明しました。5 海外製エンコーダーの重みの活用が争点でしたが、この評価をもってNAVERに自前モデルや開発力がまったくないという意味に拡大解釈すべきではありません。
6月時点で独自モデルプロジェクトにはLG AI研究院、SKテレコム、Upstage(アップステージ)、Motif Technologiesが参加しています。6 ただし、この事業の評価基準が今回のフィジカルAI事業にそのまま適用されると断定する根拠はありません。各事業の公募条件と評価方式を確認する必要があります。
これらの事例を見ながら私が比較したいのは、開発方式の選択基準です。
Sakana AIは複数のモデルを接続する方法を研究し、サービスとしてリリースしました。韓国でもこうした試みを行う企業や研究チームが実際の顧客と出会い、改善していける環境が重要です。国家の研究開発(R&D)事業と民間の製品開発は、それぞれ異なる役割を果たすことができます。
NAVER Cloudの1回の評価結果だけで、韓国にモデルの運用技術や民間の研究力がないと結論づけることはできません。私の関心は、支援事業がこうした能力をどのように確認し、育てていくかです。モデル自体のスコアだけでなく、実際の工程における精度、安全性、運用コスト、代替可能性も評価する必要があると考えています。
設備投資と運用技術の開発は並行して進めることができます。どのモデルを使用するかあらかじめ一つに固定するよりも、現場の要求が変わっても選択し変更できる能力を確保してほしいと思います。
Oswarldの視点
私は今回の計画が製造基盤を活用するという点を前向きに評価しながらも、直接開発すべき範囲を広く設定することには慎重であるべきだと考えています。
自前で作るほうが有利な技術と、外部の技術を活用するほうがよい業務を区別しなければならないからです。
技術経営やGTM戦略を立てる中で、リソースの不足した組織がすべてを自前で作ろうとして困難に直面するケースを見てきました。だからこそ独自モデルの開発に対しても、目的とコストをまず問いかけたいと思います。セキュリティや供給停止に備えて独自技術がどうしても必要な業務はあるはずです。そうであればその範囲を定め、既存の技術を活用する方式と性能・コストを比較すべきだと考えます。
Sakana AIの事例が参考になる理由もここにあります。すべての基盤モデルを新しく作らず、組み合わせる方法に集中しました。だからといってその製品一つで韓国のすべての製造・ロボット業務が解決できるという意味ではありません。国内の現場に合った作業において、直接開発と組み合わせの方式をともに試してみる価値はあると考えています。
DeepSeekのコスト削減、Sakana AIのモデル組み合わせ、韓国の生産インフラは、それぞれ異なる強みです。どれか一つだけでAI事業全体が完成することはありません。韓国が持つ設備と現場の経験をどのモデル・サービスと結びつけるかを具体化しなければなりません。
私が懸念しているのは、優れた設備を備えながらも運用技術と顧客関係を十分に確保できない状況です。海外モデルを使うこと自体が問題なのではありません。特定のモデルを変更できなかったり、価格やサービス条件が変わっても対応が難しくなったりすることが問題だと考えています。
誰がより多くの利益を残すかは私にも分かりません。半導体やデータセンターを供給する事業自体も十分に価値があります。私は韓国が持つ高度な人材と生産設備、インフラが重要な好機だと考えています。この強みを活かしながら、運用技術と顧客を確保する方法をともに準備してほしいと思います。
私が望む方向性は、韓国が半導体とデータセンターを安定して供給し、その中で複数のモデルを選択・接続・運用する能力も備えることです。設備を作る能力とサービスを運用する能力がともに成長してほしいと思います。
おわりに
この連載を書きながら、私の関心は韓国がどこに強みを築くかという点に集まりました。
私はファウンデーションモデルの研究を基礎力として継続しつつも、すべての投資の主力にする必要はないと考えています。今回の発表が製造とインフラに関心を広げた点は歓迎すべきことでした。これからは確保した設備や研究成果を実際の現場でどれほど活用できるかを確認していきたいところです。
最近、韓国国内の企業が独自のベンチマークで世界最高性能を記録したと発表する姿も見られます。こうした主張を評価する際は、論文の引用数やGitHubの注目度だけで判断するのではなく、比較モデル・試験条件・再現可能性を確認しなければなりません。ベンチマークのスコアと顧客の現場での成果をともに見る必要があります。
次の政策発表では、投資金額とともに、誰がどのようなモデルを運用し、どのような現場の成果を検証し、コストや障害にどう対応するのかを見ていきたいと思います。
設備の拡大が国内企業のサービス競争力と収益につながることを願っています。
💬 読者の皆さんは、韓国のAI投資において、どのような運用技術と現場検証をより支援すべきだとお考えですか? コメントでお聞かせください。


参考資料と関連リンク
主要出典
- 韓国産業通商資源部、〈大韓民国大跳躍3大メガプロジェクト国民報告会〉報道参考資料および別添報告書、2026.06.29.:昨日の発表の原文です。半導体3S+1F、フィジカルAI 3M、AIDC 18.4GW計画が整理されています。
- Sakana AI, “Sakana Fugu: One Model to Command Them All”, 2026.:Sakana AIがモデルの組み合わせ方式を製品化した事例です。
- 韓国科学技術情報通信部、〈独自AIファウンデーションモデルプロジェクト第1次評価結果〉、2026.01.15.:NAVER Cloudの脱落と「フロム・スクラッチ」基準をめぐる議論の原文です。
背景知識
- The New York Times, “The Real A.I. Race Isn’t America vs. China”, 2026.:AI競争の真の軸は米中ではなく「国家権力対民間企業」であるという視点。今回の3部作の問題意識と通底しています。
- ZDNet Korea、〈[ユミ’s ピック] ジェンスン・ファンに会ったLG・SKT・Upstage…独自AI第2戦の変数になるか〉、2026.06.09.:独自ファウンデーションモデル(独パモ)4陣営の現状と8月の第2次評価日程を取り上げています。
- DeepSeek, V3技術レポート, 2024.12., V4 Preview公式発表, 2026.04.24.:モデルごとの学習リソースと公開時期を区別できます。
- South China Morning Post / IndexBox, “DeepSeek upgrades V4 with DSpark”, 2026.06.:中国の「スケーリング効率化」戦略の最新事例です。
각주
-
DSpark:DeepSeekがV4に導入した推論加速フレームワークです。トークンを1つずつ生成する代わりに小さな束単位で生成し(準自己回帰生成)、検証量を動的に調整して応答速度を最大85%まで高めたと発表しました。同じスループット条件下でユーザーごとの生成速度を改善した結果であり、すべてのタスクで同様の改善が保証されるわけではありません。 ↩
-
データセンター稼働率:施設数と演算リソースの利用率は異なる指標です。一部の施設の未使用リソース比率を、全国のデータセンターの未稼働比率へと拡大解釈することはできません。 ↩
-
ポストトレーニング(Post-training):モデルをゼロから事前学習する代わりに、すでに学習されたモデルの上に追加学習・アライメント・ツール連携を重ねる段階です。Sakana AIは、リソース制約国の戦略的焦点をこのレイヤーに置くべきだと見ました。 ↩
-
Swappable Pool:Fuguが呼び出すモデルのリストを変更する方式です。プロバイダー依存を減らすことができますが、モデルを変更した後も性能・コスト・データ処理条件は改めて確認する必要があります。 ↩
-
フロム・スクラッチ(From scratch):既存の学習済み重みを引き継がず、初期化した重みから学習する方式です。韓国政府はオープンソース技術の活用自体を全面禁止したのではなく、重みの初期化と学習、運用の統制など技術的・政策的な独自性基準を提示しました。 ↩
-
独パモ4陣営の争い:2026年6月時点でLG AI研究院、SKテレコム、Upstage(アップステージ)、Motif Technologiesの4チームが競争中です。8月の第2次評価で1カ所が脱落し、2027年2月に最終2カ所が選定される日程です。 ↩
あわせて読みたい過去の号
WFPのガザ支援アプリがハッキング被害、60万世帯の個人情報が流出
ガザ地区の支援登録情報が流出しました。人道支援に必要な情報と、住民の安全を守るために収集を控えるべき情報の境界を考察します。
社会韓国のAI競争力、モデル順位と人材流出を併せて見るべき理由
韓国のAIモデル数や人口あたりの特許数は上位にあるものの、研究人材を確保し産業現場で成果を出す課題は残されています。ソブリンAIをモデル開発だけでなく運用やサプライチェーンまで含めて捉えるべき理由を考察します。
社会リリースからわずか3日でアクセス停止となったFable 5
米国政府の指針によりFable 5とMythos 5への顧客アクセスが停止されました。単一モデルへの依存がもたらす運用リスクと、ソブリンAI論議への影響を掘り下げます。
社会
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。