

한국의 AI 투자 계획, 설비와 운영 기술을 함께 봐야 해요
딥시크와 사카나의 개발 방식, 한국의 반도체·데이터센터 투자 계획을 비교했어요. 설비 투자를 실제 서비스로 연결할 운영 역량이 중요해요
사회대규모 설비 투자와 함께 확인할 것
지난 두 번의 뉴스레터에서 저는 같은 질문을 두 나라에 던졌어요.
일본 편에서는 사카나 AI가 기존 모델들을 조합해 성능을 높이는 방법을 살펴봤어요. 작은 조정 모델도 이미 개발된 대형 모델의 강점을 활용할 수 있다는 접근이었죠. 이 방식은 자체 대형 모델 개발 외에도 선택지가 있음을 보여줘요.
9천억 들고 떠난 연구자, 도쿄에 남은 138명기존 모델의 조합과 개선에 주목한 연구소한국 편에서는 국내의 높은 AI 활용 관심이 개발 역량으로 어떻게 이어질지 다뤘어요. 독자 모델을 개발하는 일과 해외 모델을 잘 활용하는 일 사이에서 투자 우선순위를 고민한 글이에요.
챗봇에 사주 묻는 나라, AI 3위가 되려면?AI 활용에 대한 관심을 산업 경쟁력으로 연결하려면그 뒤 6월 29일, 산업통상부가 관계부처와 함께 ‘대한민국 대도약 3대 메가프로젝트’를 발표했어요. 서남권 반도체 생산 거점 800조 원 규모 구상, 기업들의 AI 데이터센터 1단계 투자 550조 원, 피지컬 AI 육성 계획이 담겼어요. 이는 국내 AI 정책 전체를 대체하는 단일 전략이 아니라, 반도체·제조·데이터센터를 중심으로 한 계획이에요.
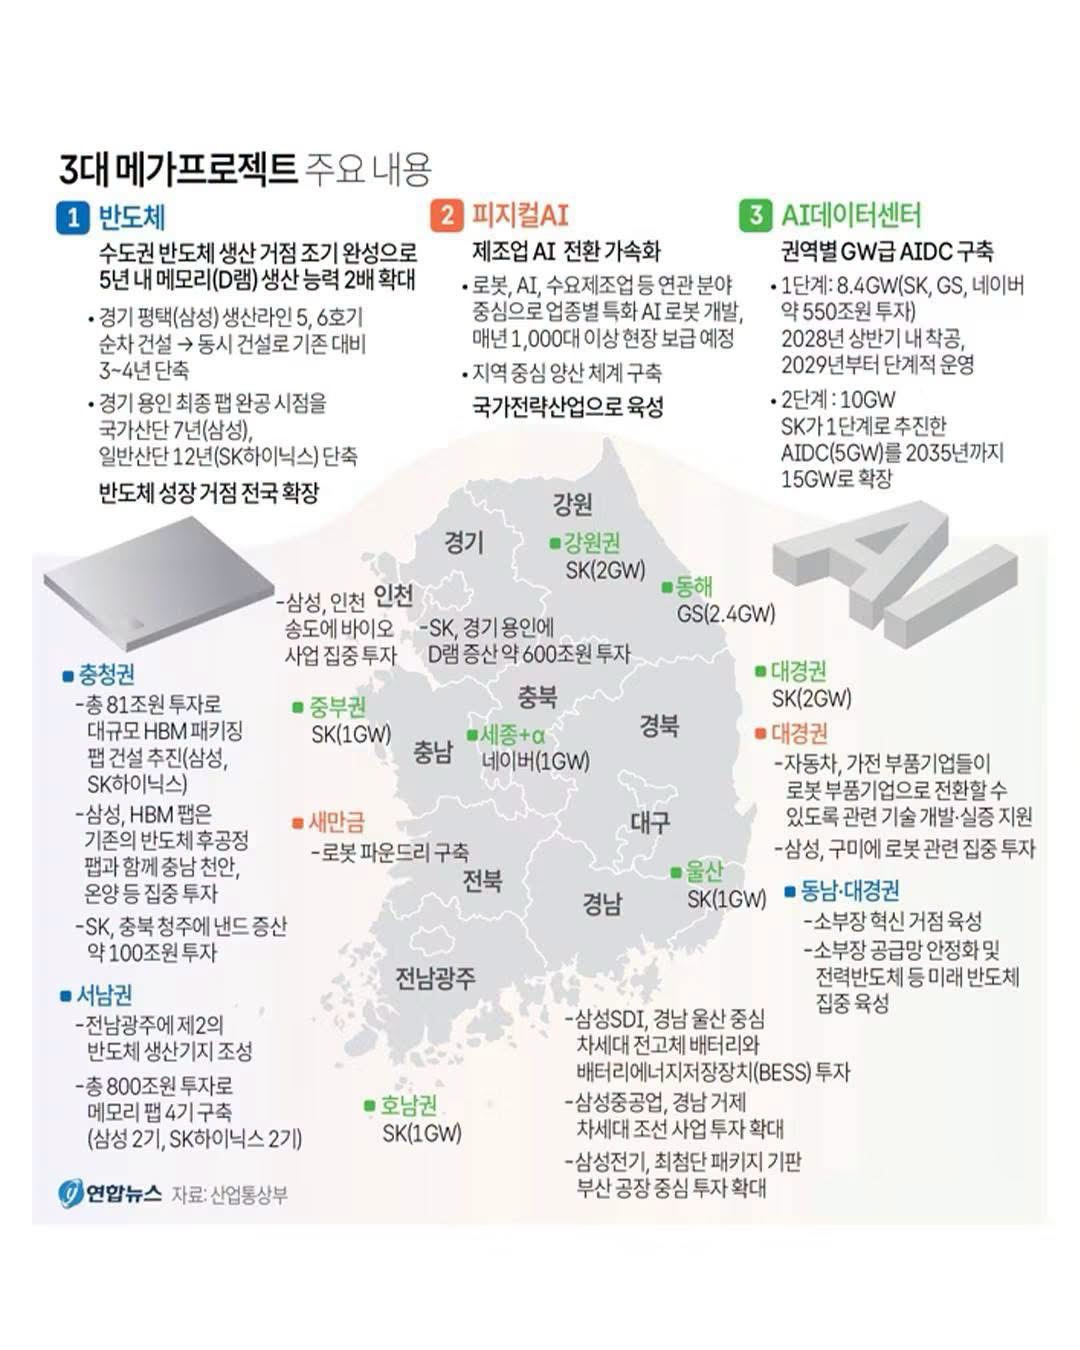
오늘은 앞선 두 편에 이어 이 계획을 살펴보려고 해요. 딥시크와 사카나가 개발 효율을 높이는 방식도 함께 보겠어요. 두 회사의 전략을 중국과 일본 전체의 전략으로 일반화하지는 않되, 한국이 참고할 수 있는 선택지를 비교해보려는 거예요.
개발 효율, 모델 조합, 제조 인프라를 비교해보면
AI 사업에는 모델 학습, 실행 비용 절감, 여러 모델의 조합, 반도체와 데이터센터 운영 등 다양한 일이 필요해요. 서로 대체하기도 하지만 함께 개선해야 하는 부분도 많아요.
🇨🇳 딥시크가 추구하는 개발·실행 효율
딥시크는 연산 효율을 높이는 방법으로 주목받았어요. 2024년 말 V3 기술 보고서에는 H800 2,048장으로 학습한 구성이 나와요. 이는 2025년 1월 공개된 추론 모델 R1의 전체 개발 자원과 같은 수치가 아니에요. 2026년 4월에는 100만 토큰 문맥을 지원하는 V4를 공개했고, 6월에는 응답 생성을 가속하는 DSpark를 선보였어요. 최대 85%라는 개선 폭도 특정 비교 조건에서의 결과예요.1
딥시크·Qwen·GLM 등이 모델 가중치 공개와 저렴한 API로 이용자를 늘리는 모습도 볼 수 있어요. 추론 비용이 실제 서비스 확산에 중요해졌다는 사례예요. 한편 중국의 일부 데이터센터에서 수요 부족과 낮은 가동률이 보고됐어요.2 이를 중국 전체가 학습 투자를 중단했거나 데이터센터의 80%가 가동되지 않는다는 뜻으로 읽어서는 안 돼요.
[안광섭 AI 진테제] 미국기업이 중국AI기업에 돈을 보내는 이유우버(Uber)가 올해 AI 코딩도구 예산을 4개월 만에 전부 소진했다. 약 5000명의 엔지니어가 에이전틱 코딩 도구를 사용하면서 월 사용료가 엔지니어당 150달러에서 많게…🇯🇵 사카나가 개발한 모델 조합 서비스
사카나 AI는 이미 학습된 모델을 개선하고 조합하는 포스트-트레이닝3에 주목해왔어요. 6월 22일에는 여러 모델을 선택하고 연결하는 Fugu 서비스를 출시했어요. 사카나의 사업 전략이지 일본이 모델 직접 개발을 포기했다는 뜻은 아니에요.
Fugu는 요청에 맞는 모델을 선택하고, Fugu Ultra는 복잡한 작업을 여러 모델에 나눠 맡긴 뒤 결과를 검증·통합해요. 사카나가 공개한 평가에서는 주요 코딩·추론 벤치마크에서 높은 성능을 보였어요. 다만 자체 평가이고, 비교 모델의 점수 중에는 각 공급자가 발표한 수치도 포함돼 있어요. Fable 5와 Mythos Preview는 실제로 호출하는 모델 목록에 포함되지 않았어요.4
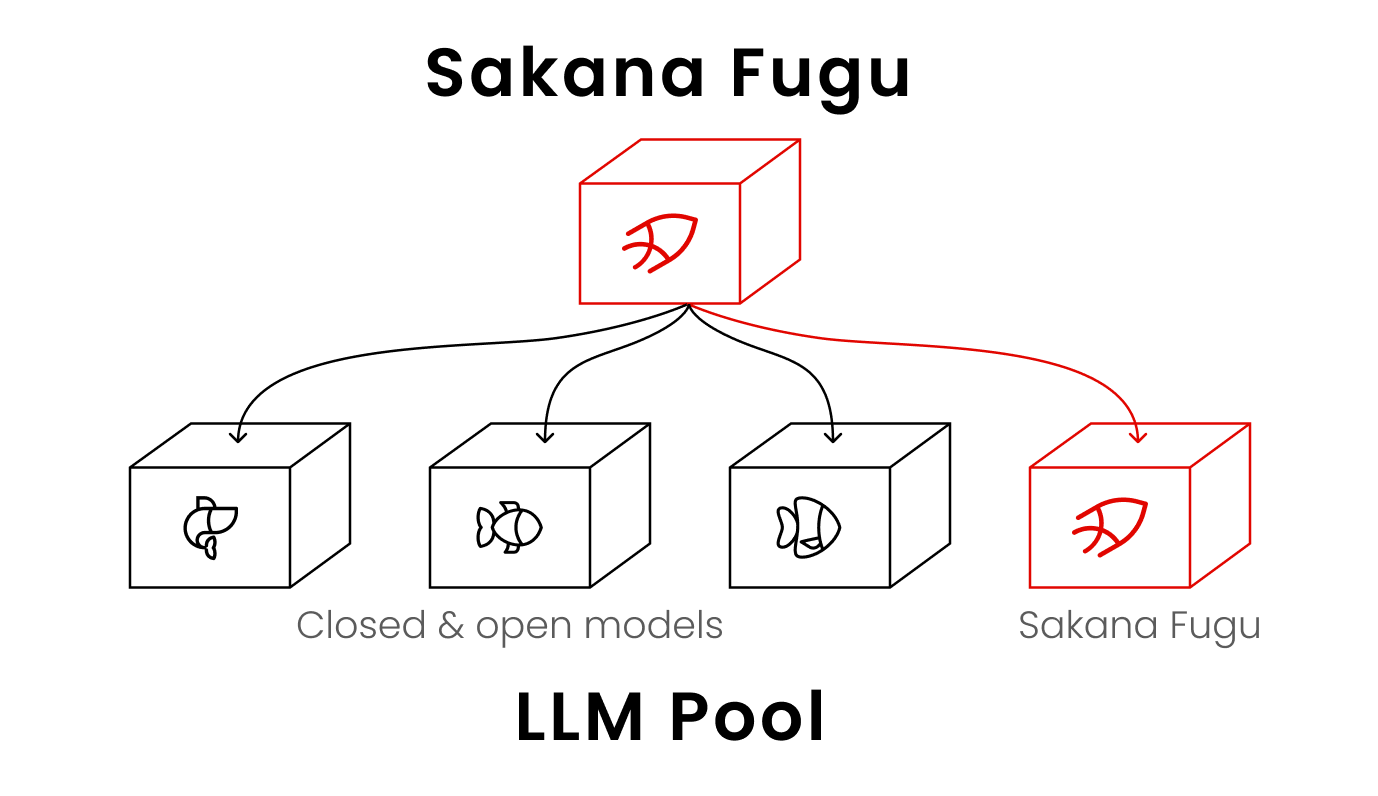
호출하는 모델을 바꿀 수 있으면 특정 공급자에 대한 의존을 줄이는 데 도움이 돼요. 다만 다른 모델로 바꾼 뒤에도 같은 성능과 비용을 유지하는지는 다시 검증해야 해요. 여러 공급자가 동시에 접근을 제한할 가능성까지 없어지는 것은 아니고요. 모델을 조합하는 능력은 운영 자율성을 높이는 한 방법으로 볼 수 있어요.
🇰🇷 한국의 반도체·피지컬 AI·데이터센터 계획
6월 29일 발표는 한국이 강점을 가진 반도체와 제조 기반을 확대하는 데 초점을 뒀어요. 하드웨어뿐 아니라 피지컬 AI 모델 개발과 클라우드 기술 지원도 포함했어요.
- 반도체: 서남권에 800조 원 규모의 팹 4기와 협력사 생태계를 조성하고, 수도권 생산 거점의 조기 완성으로 5년 내 메모리 생산능력을 2배로 확대한다는 계획이에요.
- 피지컬 AI: 제조 현장용 로봇, 학습 데이터, 핵심 부품, 파운데이션 모델과 국내 기술 실증을 함께 지원해요.
- AI 데이터센터: SK·GS·네이버가 1단계에 550조 원을 투자해 8.4GW를 구축하고, 이후 확장을 통해 총 18.4GW를 목표로 해요. 기업 투자 계획을 정부 예산과 구분해서 봐야 해요.
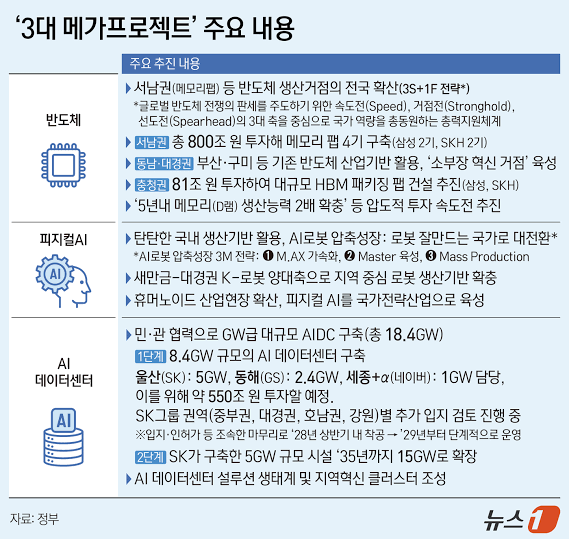
제가 한국 편에서 제안한 것도 반도체 공정 최적화나 배터리 품질관리처럼 경쟁력 있는 분야에 AI를 깊이 적용하자는 것이었어요. 이번 발표의 제조업 AI 전환(M.AX)과 데이터팩토리는 그 방향과 맞닿아 있다고 봐요.
오늘 얻은 관점, 다음 이슈에서도 이어가세요.
쏟아지는 소식 사이에서 오래 남는 한 편을 골라 격일로 보내드립니다.
이메일 확인 후 구독이 완료돼요.
이미 구독 중이신가요? 로그인하고 댓글 남기기
SEND A COFFEE
이 관점이 좋았다면, 다음 글에 커피 한 잔
오스왈드에게 커피와 함께 짧은 쪽지를 보내주세요. 응원은 다음 취재와 집필에 보탭니다.


함께 읽으면 좋은 지난 호
🔒 WFP 가자 앱 해킹, 60만 가구 개인정보 유출
가자지구 지원 등록 정보가 유출됐어요. 구호에 필요한 정보와 주민 안전을 위해 줄여야 할 정보를 함께 살펴봅니다.
사회🔒 한국 AI 경쟁력, 모델 순위와 인재 유출을 함께 봐야 하는 이유
한국의 AI 모델 수와 인구 대비 특허 수는 상위권이지만, 연구 인력을 확보하고 산업 현장에서 성과를 내는 과제는 남아 있어요. 소버린 AI를 모델 개발과 운영, 공급망까지 함께 봐야 하는 이유를 살펴봐요.
사회🔒 출시 3일 만에 접근이 중단된 Fable 5
미국 정부 지침으로 Fable 5와 Mythos 5의 고객 접근이 중단됐어요. 한 모델에 의존하는 서비스의 운영 위험과 소버린 AI에 미칠 영향을 살펴봅니다.
사회
여러분의 생각이 다음 호를 만듭니다
이번 호에서 가장 공감했거나, 다른 경험을 한 지점은 무엇인가요?