

AIの生成結果を検証する際に切り分けるべき2つの検査
AIの生成結果をコードで検査する場合とモデルに評価を委ねる場合では、確認できる事柄が異なります。タスクに適した検証基準を考察しました。
AI・テックAIが生成した結果を何で検査すべきか
数年前までは、プロンプトエンジニアリングが主に注目を集めていました。モデルが意図通りに動くまで、1つの文を修正し続ける作業でした。昨年には同じ作業にコンテキストエンジニアリングという新しい名前が付き、今年のスレッドではループエンジニアリングと呼ばれています。その下にはいつも同じフレーズが添えられます。「いまやボトルネックはモデルではなく、検証者(ベリファイア)にある」。
名称が変わるたびに、開発者たちは判を押したように反応します。「本当に何かが変わったのか? それとも有料講座を売りたいだけで名前を付け替えたのか?」。この疑念はおおむね的を射ています。AIツールの用語は、それが指し示す課題そのものよりもはるかに速いペースで消費されていくからです。
私が着目しているのは、作業のスコープが広がったという点です。指示文を書く作業から、モデルに投入する資料を選び、生成と検査を繰り返すプロセス全体を設計する作業へと関心が移りました。 ただし、最新の呼び名が指し示す課題自体は本物であるものの、名前を付けたからといってその課題が解決するわけではありません。
作業単位がプロンプト1文だった時代
2022年から2024年までを振り返ってみましょう。多くのユーザーはプロンプトの文面を推敲することに集中していました。フューショット1の例を入れ、役割を与え、「ステップバイステップで考えてみて」と付け加え、何を先に尋ねるか順序を入れ替える、といった工夫です。検索結果を連携させたりツールを使わせたりする方法もありましたが、一般のユーザーにとって最も身近な改善策はプロンプトを書き直すことでした。
当時を振り返ると、ノウハウのほぼすべてが「1文をどう書くか」に集約されていました。例をいくつ入れるか、どのような順序で問いかけるか、いかに役割を与えるか。現在でもこの感覚は有効です。優れたプロンプトが優れた出力の出発点であることに変わりはないからです。しかし現在では、指示文の工夫だけで解決するのが難しいタスクを任せるケースが増えています。
🧩 作業単位がコンテキストウィンドウ全体へと拡大
2025年半ば、アンドレイ・カルパシーが人々がすでに取り組んでいた実践にひとつの名前を付けました。コンテキストエンジニアリングです。作業の単位が単一のメッセージから、ウィンドウ(window)内のあらゆる要素へと広がりました。システムプロンプト、検索によって引き当てられたドキュメント、ツールの定義、そしてターンごとに対話へ同梱されるCLAUDE.mdやAGENTS.md2といった指示ファイルまでが含まれます。いまや1つの文を推敲するにとどまらず、モデルへ同時に投入する資料全体を取捨選択し、整理する作業へと変化したのです。
ここで開発者たちが後から気づく問題がひとつあります。モデルに投入する資料の量と、実際の振る舞いを指示する文の数が一致しないという点です。『The State of AI Instruction Quality』は決定論的な静的解析器を28,721個のリポジトリに対して実行し、指示ファイルの中央値がコンテンツ項目50件に対し、実際の指示文は12件にとどまることを突き止めました。 残りには見出しや背景の説明などが含まれていました。この分析は指示ファイルの構成比を数えたものであり、モデルが残りの内容をすべて無視したと証明したわけではありません。
さらに鋭い失敗のパターンは別の記事で論じられています。『Do NOT Think of a Pink Elephant』は、否定形で記述された制約(「モックを使うな」など)が、かえって禁止された振る舞い自体の発生確率を高めてしまう可能性があることを示しています。 禁止事項を書き連ねたからといって、望む振る舞いが保証されるわけではないという意味です。
いずれもコンテキストエンジニアリングの段階で生じる課題であり、両記事ともに根拠となるデータを公開しています。
🔁 作業単位は生成・検査・再試行のループへ
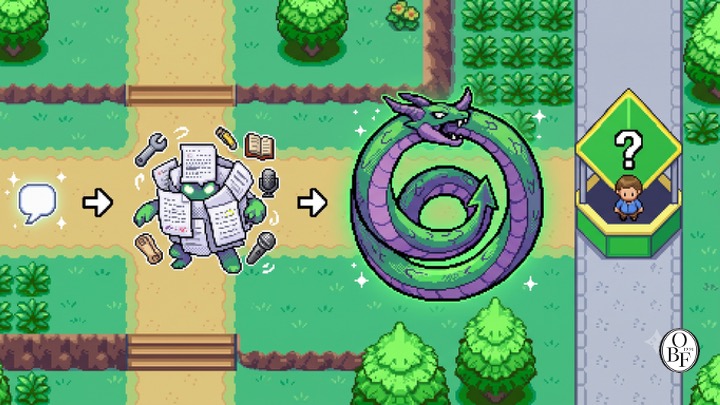
2026年6月、現在のキーワードはループエンジニアリングです。アディ・オスマニがボリス・チェルニーとペーター・シュタインベルガーの議論を整理して発信したことで、わずか数週間のうちにタイムライン全体へと広まりました。いまや作業の単位は、生成し、検査し、方針を立て、再試行し、停止するというループ全体を指します。 プロンプトはそのループ内の一段階となり、コンテキストはループが反復(iteration)間で引き渡す状態(state)となりました。
モデルが要求と参照資料を受け取って出力を生成すると、検証者がその結果を確認します。基準を満たしていれば停止し、満たしていなければ修正方針を定めて再試行します。
あらゆる解説記事が繰り返している主張はこうです。いまや限界を定めているのはモデル自体の性能ではなく、「これくらいで十分だ、停止せよ」と判断を下す検査の側にある、ということです。この名称の利点は明白です。前の2つの呼び名が扱ってこなかった領域を正面から捉えているからです。すなわち、1回の反復が妥当だったのか、もう1周回すべきかを判定する仕組みです。その仕組み自体は常に存在していました。再試行を行うエージェントであれば、例外なく備えています。ループエンジニアリングがもたらした進歩は、その仕組みを漫然と受け入れるデフォルト値から、自分自身で直接設計する対象へと引き上げた点にあります。
🔑 それで、検証者は何を検査するのか?
「検証者がボトルネックだ」というのは耳あたりの良いスローガンです。しかし、それだけでは説明として不十分です。ボトルネックがどこにあるかを指摘しつつも、その検証者が一体何を検査すべきなのかまでは教えてくれないからです。まさにその部分、すなわち検証基準を定義することこそが、実際に設計しなければならない領域です。
検査には2つの種類が存在します。これらは互いに代替できません。決定論的検査3はコードを実行し、終了ステータスを確認し、禁止されたインポートがないか走査し、同じ入力に対して常に同一の判定を返します。そこに解釈の余地は挟まりません。モデルベース検査4は、別のモデルに対して「これで問題ないか?」と問いかけます。前者の手法では表現できない基準、例えば「この説明は明快か」「文面が無礼に読めないか」といったニュアンスを拾い上げることができます。その代わり、評価を行うモデル側の判定も一貫性を欠く恐れがあります。成果物がいつ完成したかの判断を、同じく判定がブレ得るモデルに委ねることになるわけです。
実際のループにおいて両者が分岐する境界を見てみましょう。エージェントにあるモジュールのリファクタリングを命じ、完了したら停止するよう指示したとします。決定論的検証者であれば、テストが依然として通過するか、禁止されたインポートが紛れ込んでいないかを証明できます。毎回の反復で確認可能な事実であり、議論の余地はありません。しかし、そのリファクタリングにそもそも取り組む価値があったのかまでは判断できません。そこでその問いに答えるためにモデルベース検査を追加すると、今度は停止条件が「あるモデルが別のモデルの出来栄えを採点する」という構造の上に乗っかります。判定モデルが納得した時点でループは終了しますが、その判定モデル自体もループが監督しようとしていたものと同種のモデルなのです。
どちらかが間違っているわけではありません。両者はまったく異なる問いに答えています。いま自分がどちらの問いを投げかけているのかを見失うと、ループは見当違いなタイミングで停止してしまいます。
実務で迷ったとき、私は次のように切り分けています。「この基準は、別のモデルに尋ねることなく、実行や静的走査によって真偽値(True/False)として導き出せるだろうか?」。導き出せるのであれば、決定論的検査に委ねるのがほぼ常に正解です。実行コストが低く、結果がブレず、なぜ失敗したのかログが残るからです。反対に、「このコピーはブランドトーンに合致しているか」のように解釈を要する基準であれば、人間がレビューするか、あるいはモデルに評価を任せることになります。その際は、少なくとも判定基準を細かく細分化し、モデルが自由に総評を述べるのではなく、チェックリストの項目ごとに回答させる形に絞り込むことで出力のブレを抑えられます。判定を完全になくすのではなく、判定が揺らぐ余地を狭めるのです。
このトレードオフ、すなわち「その検査は実際に何を検査しているのか」という問いは、決して新しい問題ではありません。『Green Tests Don’t Mean Better Software』はこの問題をCIの文脈で論じています。テストの通過は、検査された条件下で期待通りの結果が出たことを意味するにすぎません。仕様全体を満たしているか、あるいはその変更がシステムをより良くしたかまでを保証するものではないのです。 テストは私たちが尋ねもしなかった問いに答えているにすぎません。この違いをテストスイートではなくエージェントループに当てはめてみれば、開発者にとってすでになじみ深い事例を通じて、ループエンジニアリングが直面している問いをそのまま説明できます。
Oswarldの視点
率直に申し上げると、私はこの新しい呼び名に対して歓迎したい気持ちと慎重になる気持ちの両方を持っています。
GTM戦略を長年策定してきた中で、数え切れないほど目にしてきたパターンがあります。「テクノロジーが世界を変える」という展望自体はおおむね当たります。ただし、その時期と到達経路の予測はほぼ例外なく外れるのです。新しい用語が台頭するたび、私はまずこのパターンを疑うようにしています。しかし、今回の3段階にわたる呼称の変化は少し毛色が異なります。名前が変わるたびに、単なるマーケティングではなく作業の対象自体が実際にシフトしてきたからです。 プロンプトの1文からコンテキスト全体へ、そしてループへと移り変わっていきました。そのため、今回の名称変更は単なる言葉の言い換えにとどまらないと見ています。
ただし、心に留めておくべき点があります。名前は「何を設計すべきか」の所在を指し示してくれるにすぎません。検証者を構築する作業は依然としてあなた自身の仕事であり、それこそが実務の大部分を占めています。 特定のタスクにおいて「何をもって正しいとするか」を定義し、それを実際に実行可能な検査の形へと落とし込む作業です。
その中でも重要なのが、検査の種類を正しく選定することです。データを扱ってきた実務の視点で見れば、これは測定設計の課題にほかなりません。「この説明は明快か」は人間やモデルによる定性評価を要します。「禁止されたインポートが存在しないか」は決定論的な静的走査で十分です。選択を誤れば、どちらに転んでも相応のツケを払うことになります。決定論的検査で済むものをモデルの判定に委ねれば判定がブレるリスクばかりが増え、判断が必要な場所に決定論的検査を置けば、パスの表示は出るものの本当に確認したかった事柄は見落とされたままになります。名前はこの選択の存在を可視化してくれるだけであり、代わりに選択してくれるわけではないのです。
おわりに
要点を整理すると次のようになります。第一に、プロンプトからコンテキストへ、さらにループへと呼称が変化したのは、看板の掛け替えではなくエンジニアリングの対象単位が実際に拡大したためです。 第二に、「検証者がボトルネックである」という言葉だけでは不十分です。何をどのような手法で検査するのかまでを具体的に詰めなければなりません。第三に、名前は課題のありかを教えてくれるにすぎず、検証者を組み上げる作業は依然として自身の手で行う必要があります。
ループは複数のコンポーネントから構成されています。今後数回にわたり、それらのパーツをひとつずつ分解しながら、それぞれをどのように測定すべきかを掘り下げていく予定です。誤った失敗判定と検査漏れをいかに区別するか、修正を促すルールと結果をリジェクトするルールの本質的な違い、そして反復のたびに入力し続ける1つの指示が毎回どれほどのコストを積み上げているのかを検証していきます。本日の記事で提示した問いが、今後の連載の出発点となります。
もし読者の皆さんがエージェントループを自ら運用された経験をお持ちであれば、停止条件を決定論的検査に置かれましたか、それともモデルによる判定に委ねられましたでしょうか。どのような点に最も苦心されたか、ぜひコメント欄でお聞かせください。次回以降のテーマとして取り上げてみたいと思います。
📨 エージェント開発に取り組んでいる同僚がいらっしゃいましたら、ぜひ本記事をシェアしてください


参考資料と関連リンク
主要出典
- reporails, “The State of AI Instruction Quality”:指示ファイルの中央値がコンテンツ項目50件に対し、実際の指示文は12件にとどまるというデータの出典です。
- cleverhoods, “Do NOT Think of a Pink Elephant”:否定形の制約が、かえって禁止された振る舞いの発生確率を高めてしまうという主張の出典です。
- reporails, “Green Tests Don’t Mean Better Software”:テストが実際には問いかけてもいない質問に答えているという論点の出典です。
- cleverhoods, “Prompt Engineering, Context Engineering, Loop Engineering: What Actually Changed”:本ニュースレターの骨子となった元記事です。
背景知識
- アンドレイ・カルパシーによる「コンテキストエンジニアリング」の命名(2025年半ば):この用語がどこから生まれたのかを示す起点です。
- アディ・オスマニによる「ループエンジニアリング」の整理(2026年6月、ボリス・チェルニーおよびペーター・シュタインベルガーの議論を総括):本日の記事で扱った第3の呼称が普及した契機です。
併せて読みたいバックナンバー
- (テーマが直接つながる過去の記事があれば、ここにリンクを挿入してください。例:コンテキストウィンドウや指示ファイルを取り上げた回があれば関連付けると効果的です)
📝 用語解説
각주
-
フューショット(few-shot):モデルにいくつかの具体例を提示し、意図した形式やアプローチを模倣させる手法です。例示なしで単に指示を出すよりも出力が安定します。 ↩
-
CLAUDE.md / AGENTS.md:AIコーディングツールに対して「このプロジェクトではこのように作業せよ」と伝えるための指示ファイルです。対話のターンごとに裏側で自動的に読み込まれます。 ↩
-
決定論的検査(deterministic check):同じ入力に対して常に同一の結果を返す検査手法です。コードの実行、終了ステータスの確認、禁止キーワードの走査など、主観的な判断を挟まない機械的な確認作業を指します。 ↩
-
モデルベース検査(model-graded check):出力の良し悪しを別のAIモデルに問い合わせて判定させる手法です。人間のような柔軟な判断を模倣できる反面、評価結果にブレが生じやすいという側面を持ちます。 ↩
あわせて読みたい過去の号
AIモデルは複製できても自分の判断は自分でする必要があります
一度学習したAIモデルは、複数の場所に複製して利用できます。その便利さゆえに、結果を検証することまで省いてしまう問題について考察しました。
AI・テックClaudeの安全性評価に影響を与えた「試験状況」の認識
AnthropicのJ-空間研究は、Claudeが脅迫を思いとどまった理由が「試験状況」だと気づいていたためである可能性を示しています。
AI・テックAIグラスとコンパニオンデバイスはどんなデータを集めるのか
MetaのスマートグラスやOpenAIの機器に関する報道を手がかりに、生活を支援する機能にどのようなデータが必要とされるのかを考えます。
AI・テック
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。