

「バグ修正だけに専念する」と言えるチームリーダーはなぜいないのか
GitClearの集計でリファクタリング比率は3.8%に激減、重複コードは81%増加。「修正する作業」が評価されない構造的な問題を読み解きます。
AI・テック顔認識を3回求めた銀行アプリ、そして祝福の投稿
先週、ある開発者が経験した一連の出来事を綴った文章を読みました。銀行アプリは決済確認画面までに3回の顔認識を要求し、遅れて立ち上がったSlackのウィンドウにフォーカスを奪われたせいで、ターミナルに入力中だったコマンドがグループチャットに誤送信されてしまいました。冷蔵庫の無償修理の申し込みは、長い入力フォームをすべて埋めた最後の段階で失敗しました。自動車のインフォテインメントシステムは、アップデート後に走行中の再起動を繰り返します。
彼が書き添えたエピソードが印象的でした。数カ月前にその車載OSを刷新したチームのPMが、素晴らしい成果を上げたとLinkedInでお祝いの投稿をしていたそうです。毎日その製品の不具合と格闘しているユーザーの頭には、その投稿が何度も浮かんできます。
開発チームは機能を素早く作ったと評価されますが、ユーザーは不具合によって不便を強いられています。AIは「コードを素早く書けない問題」を少なからず解決しました。しかし、「直した人に誰も報いない問題」には一切手を付けていません。開発スピードが上がっても保守が追いつかなければ、チームが評価する成果とユーザーが実感する品質との乖離は広がるばかりです。
スループットが向上したのは事実です
こうした結果をすべてAIのせいにするわけにはいきません。実際に開発スピードは上がっているからです。
GoogleのDORAチームが世界中の技術者約5,000人を調査した2025年のレポートによると、回答者の90%が業務にAIを利用しており、1日あたりの使用時間の中央値は2時間でした。そして2024年の調査とは異なり、AIの導入率が高いほどソフトウェアデリバリーのスループットとプロダクトの成果が同時に向上するという相関関係が観測されました。各チームがツールをどこでどのように使うべきかを学びつつあることを意味しています。
同じ傾向を示す個別のデータもあります。コード変更履歴を分析するGitClearが2026年1月に発表したレポートによると、AIをもっとも積極的に活用している開発者グループは、非利用者と比べて4〜10倍のアウトプットを出していました。ただし、ここには率直な但し書きがついています。その格差の大部分はAI導入以前からの個人の能力差であり、同一人物の過去のデータと比較した場合のスピード向上は**25%**程度にとどまりました。AIが優秀な人材を生み出したというよりは、もともと優秀だった人が真っ先にAIを使いこなしたという解釈が自然です。
問題は、同じDORAレポートに併記されたもうひとつの結果です。AIの導入率が高い組織ほど、デプロイの不安定性1も同時に上昇していました。障害による予定外のデプロイが増えているということです。DORAはこの組み合わせを次のように総括しています。AIは「増幅器」であると。うまく機能していた組織の強みを伸ばす一方で、きしんでいた組織の欠陥も等しく拡大させてしまうのです。
リファクタリングは減り、コピー&ペーストは増えました
では、何が増幅されているのでしょうか。GitClearが2026年に発表した追跡調査は、この点を極めて具体的に指摘しています。2023年から2026年にかけてのコード変更6億2,300万件を8つのシグナルに分類して分析したデータですが、その変化の方向性は一貫しています。
もっとも顕著なのは、リファクタリング2の消失です。変更された全コード行のうち「移動されたコード」、つまり既存コードを整理・再配置したコードの割合は、2022年の21%から2026年現在では3.8%へと激減しました。同じ期間にコピー&ペーストされたコードの割合は、9.4%から15.7%に上昇しています。2022年の時点では、開発者は貼り付ける作業よりも整理する作業を2倍以上頻繁に選んでいましたが、現在は逆に貼り付けが約5倍も優勢になっています。
ほかの指標も同じ方向を指しています。5行以上そのまま繰り返される重複ブロックは2023年比で**81%**増加し、観測史上最高を記録しました。新しく書かれたコードが既存コードのほかの関数を呼び出す頻度は35%減少しました。新しいコードが既存のコードベースと統合されず、孤立した単独ファイルとして切り離されていることを意味します。1年以上手つかずだった古いコードを再び開いて整理したり破棄したりする作業の比率は、1.7%から0.46%へと、74%減少しました。
これがなぜ問題なのかは、ひとつの重複ブロックを想像してみれば容易に理解できます。5行のブロックが10カ所に散らばっている場合、そのうちの1カ所を修正する人は、残りの9カ所をすべて探し出して「ここも一緒に変更すべきか」を判断する義務を自動的に背負い込むことになります。自分が知らないファイルや詳しくないドメインまで含めてです。いま30秒を節約した代償として、数年後にほかのメンバーが同じ確認作業を繰り返すことになり、はるかに多くの時間を浪費する構造ができあがってしまいます。
GitClearはこの状態を「保守性の格差」と呼んでいます。そしてレポートの中で、核心を次のように要約しています。問題はAIが粗悪なコードを書くことではなく、現在の標準的なワークフローが1つのハッピーパス、1つの通過するテスト、1つの完了したチケットを生み出すように設計されている点にあると。目に見えてすぐに完了するタスクには報酬が支払われますが、目立たないために先送りにされる整理作業は、のちにさらに大きなツケとなって跳ね返ってきます。
それでも誰も直さない理由
これほどツールが進化したのに、なぜ誰もこの負債を返済しようとしないのでしょうか。冒頭で引用した開発者は、その答えを架空の発表文として提示しています。
「今四半期は新機能をリリースせず、リデザインの計画もありません。バグの修正だけに集中します」
この文言を実際に四半期の計画スライドに掲げられる組織が、果たしてどれほどあるでしょうか。私はほとんど見たことがありません。理由は単純です。新機能にはデモがあり、語るべきストーリーがあり、業績評価に書ける成果があります。一方で安定化作業は、うまくいったとしても「障害が起きなかった」という事実が残るだけです。成果としてアピールできる具体的なアウトプットが存在しないのです。
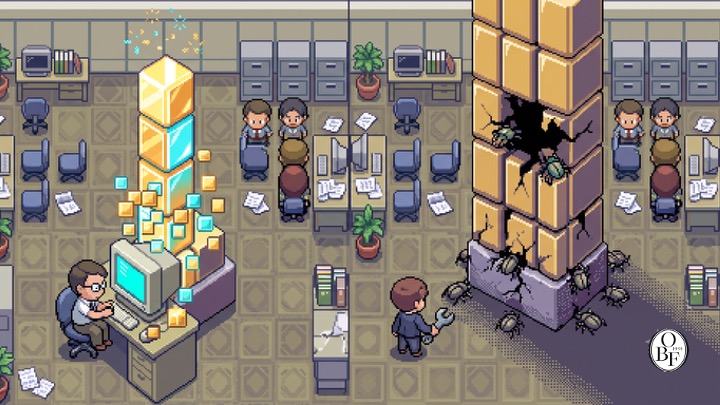 したがって、これは一見すると技術的な問題に見えますが、実態は測定と報酬の問題です。スループットはダッシュボード上ですぐに可視化されますが、保守性が悪化した結果は何年も経ってからコストとして顕在化します。管理者がどちらか一方しか見られないのであれば、どちらを重視して管理するかは最初から決まっています。
韓国では、こうした歪みが個別の企業文化にとどまらず、公共調達の契約単価にも如実に表れています。公共ソフトウェアの保守管理料率3の話です。韓国政府は2017年の国政懸案点検調整会議において、この料率を15%水準から2022年までに20%へと引き上げ、外資系ソフトウェア(約22%)との格差を縮めると決定しました。しかし、韓国のソフトウェア政策研究所による2019年の産業実態調査を見ると、回答企業の**29.8%**がいまだに10%未満の料率を適用されていました。民間平均が14.2%だったことを考えると、公共案件のほうが低かった計算になります。新しく作る価値は認めながら、修正して維持する価値は買い叩くという慣習が、何十年も続いてきたのです。
保守を後回しにした問題は、やがて重大な事故となって露呈することもあります。韓国の金融監督院は2026年3月のデジタル・IT部門業務説明会において、近年発生した事故の相当数が高度なハッキング技術によるものではなく、基本的なセキュリティ原則と内部統制が守られていなかったことに起因していると指摘しました。事故は高度な攻撃技術のせいではなく、基本的な手順を怠ったことから生じたという診断です。しかし、基本的な手順を堅実に守るという作業は、組織の成果として評価されにくい領域なのです。
根拠の限界:GitClear、DORA、METR
ここまで読んで、「やはりAIが悪かったのか」と短絡的に結論づけるのは早計です。提示された根拠の限界も併せて見極める必要があります。
まず、GitClearは中立的な観察者ではありません。コード品質と開発生産性を測定するツールを販売している企業です。品質指標が悪化しているという結論は、同社のビジネス上の利害と一致します。データの規模が大きいことと、解釈が中立であることは別問題です。
DORAの調査もかなりの部分が自己報告形式のアンケートに基づいており、観測されたのはあくまで相関関係です。AIを多用するチームが不安定なのか、もともとスピード重視で突き進むチームがAIも真っ先に導入したのかは、このデータだけでは判別できません。
もっとも興味深いのは、一時期広く引用されたMETRの研究です。2025年7月の発表では、熟練開発者16人に246件の実務タスクを無作為に割り当てた4結果、AIを使用した場合は完了までの時間が19%余計にかかったと報告されました。ところがMETRは、2026年2月に実験設計を自ら修正しました。AIの恩恵を大きく受けている開発者ほど「AI禁止」条件への参加を敬遠するという選択バイアスが生じていたことを理由に挙げ、再参加者を基準にすると、むしろ18%高速化していたという推計値を提示したのです。要するに、研究チーム自身が「AIが生産性を向上させるかどうかは、私たちにもまだ分からない」という立場へと後退した形です。
ただし、この修正を経てもなお残る重要な発見がひとつあります。開発者が実感したスピードと、実際の測定値とのあいだにズレがあるという点です。参加者は開始前に24%速くなると予想し、実験終了後にも20%速くなったと感じていました。測定値がどちらに転ぼうとも、人間が自身の生産性の変化を直感では正確に測れないという結論は覆りません。そして現在のほとんどの組織は、まさにその直感を根拠にしてツールの導入を進め、人員計画を立てているのです。
Oswarldの視点
GTM戦略を策定する中で、製品ロードマップの会議には数え切れないほど参加してきました。その中で、安定化に関する項目が優先順位から外される場面は、ほぼ例外なく繰り返されてきました。興味深いのは、その場の誰も品質を軽視しているわけではないという点です。それでも、四半期目標に盛り込む言葉を選ぶ段になると、「障害を40%削減しました」よりも「新機能を3つリリースしました」が勝つのです。前者は「起きなかったこと」を証明しなければなりませんが、後者は見せるだけで済むからです。
データ関連の業務に携わる中でも、測定しやすい成果にばかりマネジメントが集中する様子を目の当たりにしてきました。そのため私は、今回の問題の本質は組織が従来から持っている評価・報酬の仕組みにあると考えています。たとえばAIによって機能開発のコストが10分の1になったとすれば、もともと新機能を優先していた組織は、そちらへさらに傾斜しやすくなります。反対に、コードを整理して破棄する作業は依然として人間の判断と時間を必要とするため、相対的により高コストに見えてしまうのです。
したがって、この問題を単なる「ツールの選択」として捉えている組織は、概して失敗するはずです。Cursorを使おうがClaude Codeを使おうが、四半期計画の中に「直す作業」の居場所がなければ、結果は変わりません。DORAが導き出した結論もまったく同じです。AI導入の成否はツールの問題ではなく、システムの問題なのです。
元記事を書いた開発者は、悲観論だけで終わらせず希望も書き残しています。企業が保守の負債を積み上げている一方で、個人の開発者はかつてなら思いもよらなかった規模のソフトウェアを1人で作れるようになったと。同じツールが、組織においては負債を肥大化させる一方で、その負債に辟易した個人にとっては自らオルタナティブを構築するための武器になっているのです。
おわりに
AIの導入以降、スループットは向上しました。しかしGitClearの集計では、リファクタリングの比率は3.8%に落ち込み、重複ブロックは81%増加しました。将来にわたってコードを修正しやすく保つ作業が同時に失われているのです。チケットを完了すれば成果として評価され、障害を未然に防いだ功績は認められにくいという評価体制も、その原因の一端を担っていると考えられます。韓国ではその歪みが、公共ソフトウェアの保守管理料率という契約単価にも反映されています。
今四半期はロードマップを開いて、全体の何パーセントが「修正と整理」に割り当てられているかを数えてみてください。もしそれがゼロに近ければ、チームの問題ではなく計画書そのものの問題です。
もし新機能の代わりにシステムの安定化だけに四半期を丸ごと費やした組織をご存じでしたら、ぜひ教えてください。その意思決定がどのように承認されたのか、そしてその後の評価でそのチームがどのような扱いを受けたのか、非常に気になっています。
💬 お寄せいただいた事例は、次号以降で取り上げさせていただきます。 📨 ロードマップに品質改善をねじ込むために苦闘している同僚がいたら、ぜひこの記事をシェアしてください。


参考資料と関連リンク
主要出典
- GitClear, “The Maintainability Gap: AI Code Quality in 2026”, 2026. ··· 本文で引用した数値の多くがここから取られています。ただし、同社がコード品質の測定ツールを販売している企業である点は念頭に置いて読むことをおすすめします。
- Google Cloud, “2025 State of AI-assisted Software Development (DORA Report)”, 2025.9. ··· スループットと不安定性が同時に上昇しているという指摘が核心です。「AIは増幅器である」という表現もここから引用しました。
- Becker, J., Rush, N., Barnes, B. & Rein, D., “Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity”, arXiv:2507.09089, 2025.7. ··· 19%という数値の元論文です。以下の追跡調査の記事と併せて読むことを強く推奨します。
- METR, “We are Changing our Developer Productivity Experiment Design”, 2026.2. ··· 研究チーム自らが選択バイアスを認め、設計を変更した記録です。自身の研究結果を公に修正していくプロセスそのものが非常に示唆に富んでいます。
- ソフトウェア政策研究所、 「公共SW保守事業、予算の死角を解消すべき」. ··· 保守管理料率の目標と現実の乖離を扱った論考です。韓国の構造的背景を理解するための出発点として適しています。
背景知識
- DORA, “Balancing AI tensions: Moving from AI adoption to effective SDLC use”, 2026. ··· AIが節約したコード生成の時間が検証の時間へと再配分されるという分析です。本稿の第3章と連動しています。
- 法律新聞、 「2026年デジタル・IT部門金融監督業務説明会の主要内容および示唆点」, 2026.3. ··· 金融業界における事故原因の分析が整理されています。規制当局の視座を確認するのに役立ちます。
併せて読みたいバックナンバー

📝 用語解説
각주
-
デプロイの不安定性(delivery instability):新しいコードをリリースしたあと、障害や不具合によって予定外のデプロイを余儀なくされる頻度のことです。スピードとは異なり、ユーザーが直接体感する指標です。 ↩
-
リファクタリング(refactoring):プログラムの動作はそのままで、コードの構造だけを整理する作業のことです。部屋を増築するのではなく、すでにある荷物を整理整頓するイメージに近いです。 ↩
-
保守管理料率:ソフトウェアの開発費に掛け合わせて、年間の保守費用を決める比率のことです。料率が10%なら、1億ウォンのシステムであれば年間の保守費用は1,000万ウォンとなる計算です。 ↩
-
無作為割り当て(randomized assignment):実験の参加者やタスクを実験条件に無作為に割り振る方式のことです。条件以外の差異が結果に紛れ込むのを抑えられるため、単純な比較に比べて因果関係を語るうえで有利になります。 ↩
あわせて読みたい過去の号
重みは公開されても個人では動かせないオープンウェイト
Kimi K3は重みだけで1.5TBを超えます。演算に一部のパラメータしか使わないMoEモデルでも、自前で動かすには巨大なメモリが必要となる理由を掘り下げます。
AI・テックAIの生成結果を検証する際に切り分けるべき2つの検査
AIの生成結果をコードで検査する場合とモデルに評価を委ねる場合では、確認できる事柄が異なります。タスクに適した検証基準を考察しました。
AI・テックAIモデルは複製できても自分の判断は自分でする必要があります
一度学習したAIモデルは、複数の場所に複製して利用できます。その便利さゆえに、結果を検証することまで省いてしまう問題について考察しました。
AI・テック
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。