

알리바바가 CPU 메모리에 둔 510억 파라미터 조회표
510억 파라미터 N-gram 조회표를 GPU가 아닌 서버 CPU 메모리에 둔 이유와, 9분의 1·8.6배 같은 발표 수치가 무엇을 잰 값인지 정리했어요
AI·테크알리바바가 510억 파라미터를 GPU 밖 CPU 메모리에 둔 이유
수요일 밤 자정(한국 시간), 알리바바 Qwen 팀이 Qwen3.8-Flash-Next의 가중치를 열었어요. 완성된 플래그십이 아니라 다음 세대 Qwen4에 넣을 설계를 먼저 공개해 검증받는 모델이에요. 전체 파라미터는 1,250억인데 토큰 하나를 처리할 때 실제로 움직이는 건 60억이고, 여기에 자주 나오는 토큰 조합을 미리 기억해 두는 510억짜리 N-gram1 메모리를 붙였어요.
스펙표에서 제가 주목한 건 510억 파라미터의 저장 위치였어요. GPU 메모리 대신 서버의 일반 메모리에 두었다는 설명이었어요. 저는 두 번에 걸쳐 “AI의 진짜 병목은 연산 칩이 아니라 HBM”2이라고 썼는데요. 그 병목을 칩이 아니라 설계로 우회하는 시도가 나온 거예요.
이 발표에서 눈여겨볼 부분은 성능 점수보다 비용 구조예요. 파라미터의 일부를 GPU의 HBM 대신 서버 일반 메모리에 두었고, 발표된 수치는 각각 무엇을 기준으로 잰 값인지 따져봐야 하고, 같은 밤 나온 두 Flash 모델은 가격이 거의 같고 라이선스가 달랐어요.
510억은 왜 GPU 밖에 있을까
언어 모델은 토큰 하나마다 벡터 하나를 사전에서 꺼내 시작해요. Qwen은 여기에 사전을 하나 더 붙였어요. 직전 두세 개 토큰의 조합을 열쇠로 쓰는 2,000만 칸짜리 표예요. 마지막 토큰 몇 개를 해시해 주소를 만들고, 표에서 벡터를 꺼내 두 번째 층의 표현에 섞어요. 곱셈이 아니라 읽기라서 토큰당 연산은 거의 늘지 않아요.
이 표를 어디에 두느냐가 중요해요. 주소가 결정적이라 토큰만 알면 읽을 칸이 정해지고, GPU가 첫 층을 계산하는 동안 CPU 메모리에서 미리 가져다 놓을 수 있어요. 이 프리페치3가 첫 층 연산과 겹치면서 이동 지연이 숨겨져요. vLLM 배포 레시피에 그 결과가 있어요. GPU 쪽 FP8 체크포인트 172.78GiB는 그대로이고, 거기에 “N-gram 오프로드용 호스트 메모리 51GB 이상”이 한 줄 추가돼요.
전문가 혼합(MoE)4과 비교하면 의미가 보여요. MoE도 토큰당 연산은 줄이지만 512개 전문가가 전부 GPU 메모리에 있어야 해요. 반면 조회표는 GPU 밖에 두어도 동작해요. 모델 카드의 “메모리 제약 가속기에 효율적, MoE보다 오프로딩에 적합”이 정확히 이 차이예요.
이 아이디어를 먼저 낸 곳은 구글이에요. 작년 2월 구글 연구진의 SCONE 논문은 “주메모리와 SSD는 가속기 메모리보다 훨씬 싸다”는 문장으로 시작해 N-gram 임베딩을 가속기 밖에 두자고 제안했어요. 논문 단가표로 시스템 메모리는 GB당 약 2달러, SSD는 0.1달러예요. 같은 해 젬마 3n도 층별 임베딩을 CPU에 두는 방식을 썼고요. 이 계보를 1,250억 규모에 510억이라는 크기로 얹은 건, 제가 아는 한 처음이에요.
리포트가 스스로 밝힌 한계도 있어요. N-gram 어휘를 키우면 학습 손실은 계속 내려가지만 다운스트림 정확도는 어느 지점에서 포화해요.
100만 토큰 중 2,048개만 보는 어텐션
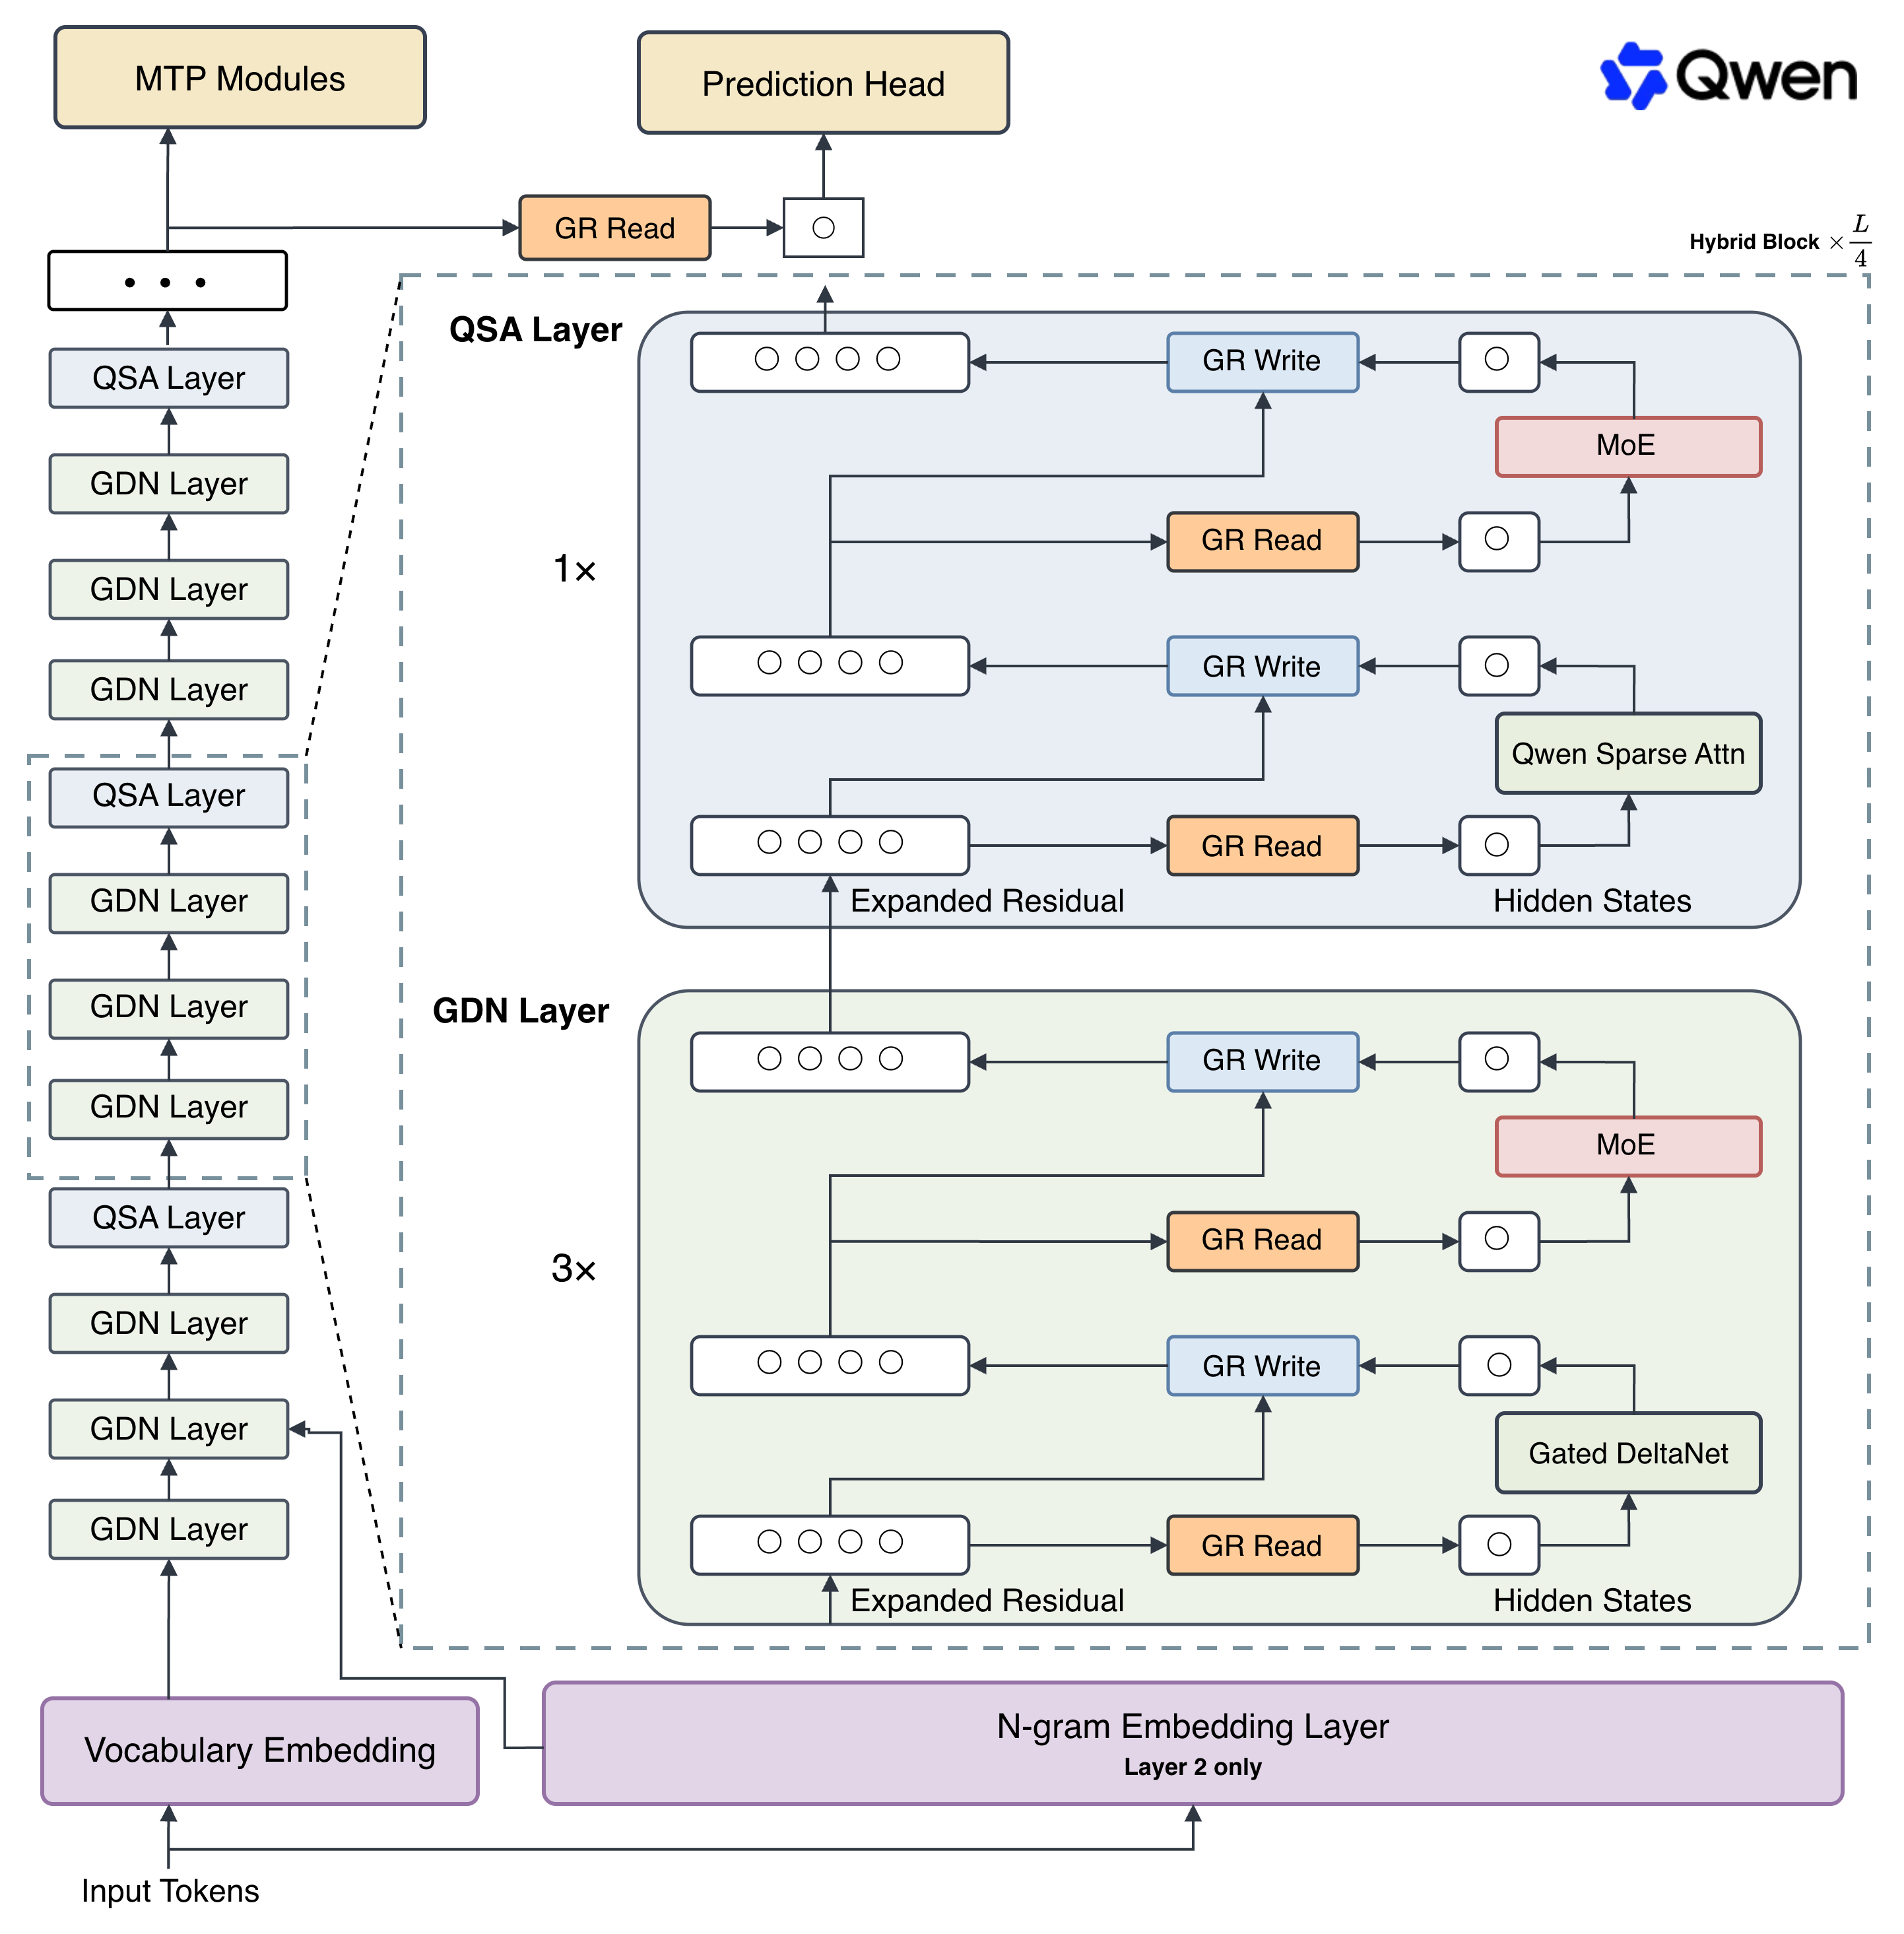
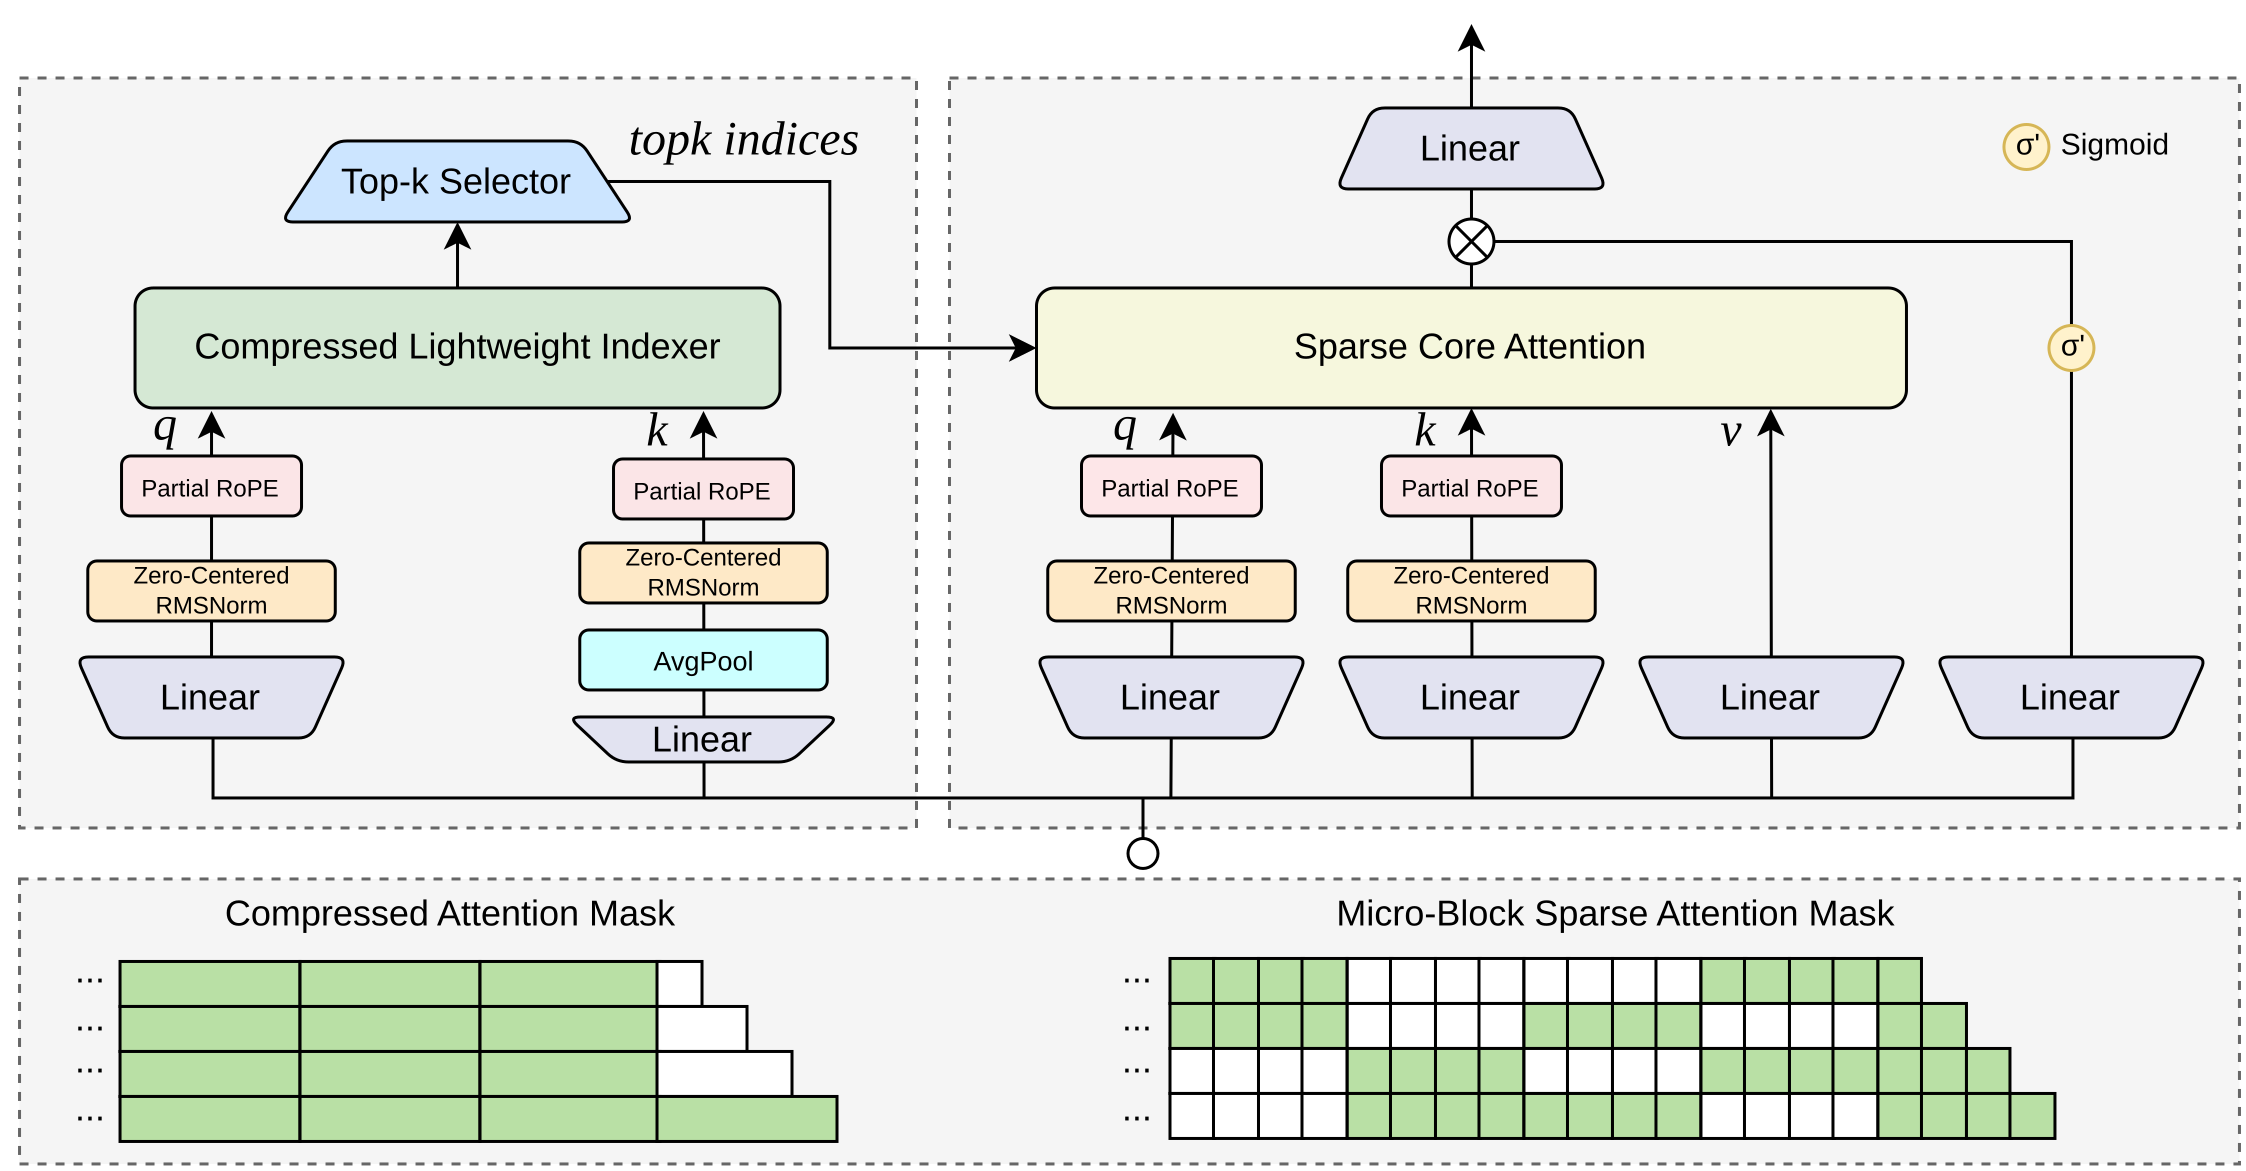
두 번째 부품은 긴 문맥의 비용을 겨냥해요. 48개 층 가운데 36개는 게이티드 델타넷(GDN)이라는 선형 어텐션 층이에요. 문맥이 길어져도 고정 크기의 상태 하나에 압축해 두니까 비용이 길이에 비례해서만 늘어요. 나머지 12개 층, 네 층에 하나꼴로만 진짜 어텐션이 들어가고, 그 자리에 Qwen 희소 어텐션(QSA)이 앉아요.
세 번째 부품은 다이어그램에서 동그라미 네 개로 그려진 잔차 스트림6이에요. 층 사이를 잇는 컨베이어 벨트를 한 줄에서 네 줄로 넓혔고, 각 부품은 읽기 게이트로 필요한 만큼만 꺼내 쓰고 쓰기 게이트로 되돌려 놓아요. 리포트의 강조점은 안정성이에요. 최적 학습률의 4배로 올리는 스트레스 테스트에서 이전 구조는 손실이 자주 튀었고 새 구조는 안정적이었으며, 본학습에서는 손실 스파이크가 한 번도 없었대요.
네 번째는 레시피예요. 행렬 가중치에는 Muon, 그 밖에는 AdamW를 나눠 썼고, 스케일링 법칙을 다시 맞춰 배치와 학습률을 올린 덕에 배치 워밍업을 없앴어요. 워밍업은 옵티마이저 스텝을 18.8% 더 쓴다는 게 근거예요.
이미 구독 중이신가요? 로그인하고 댓글 남기기
커피 한 잔 보내기
이 관점이 좋았다면, 다음 글에 커피 한 잔
오스왈드에게 커피와 함께 짧은 쪽지를 보내주세요. 응원은 다음 취재와 집필에 보탭니다.


함께 읽으면 좋은 지난 호
🔒 에이전트 확산에 서버 CPU 시장 6배 전망
보조 역할로 여겨지던 서버 CPU 시장이 2030년 2,100억 달러로 6배 커진다는 BofA 전망을 풀어봐요
AI·테크🔒 같은 사람인데 이름을 바꾸니 거짓이 됐어요
성능이 같아져도 대체되지 않는 자리가 있어요. 결과물만 쓰는 자리와 누구 이름으로 나가는지가 효력을 좌우하는 자리를 구분해봤어요
AI·테크🔒 버너스리가 모범으로 든 URL은 넉 달 만에 사라졌어요
버너스리가 모범 사례로 든 URL은 넉 달 만에 사라졌지만, 그 글 자체는 28년째 같은 주소에서 열려요. 링크 로트의 원인과 AI 시대의 의미를 정리했어요
AI·테크
여러분의 생각이 다음 호를 만듭니다
이번 호에서 가장 공감했거나, 다른 경험을 한 지점은 무엇인가요?