

中国AI微笑曲线,模型位于谷底
美银图表所言与未尽之言
商业一张形如笑脸的图表
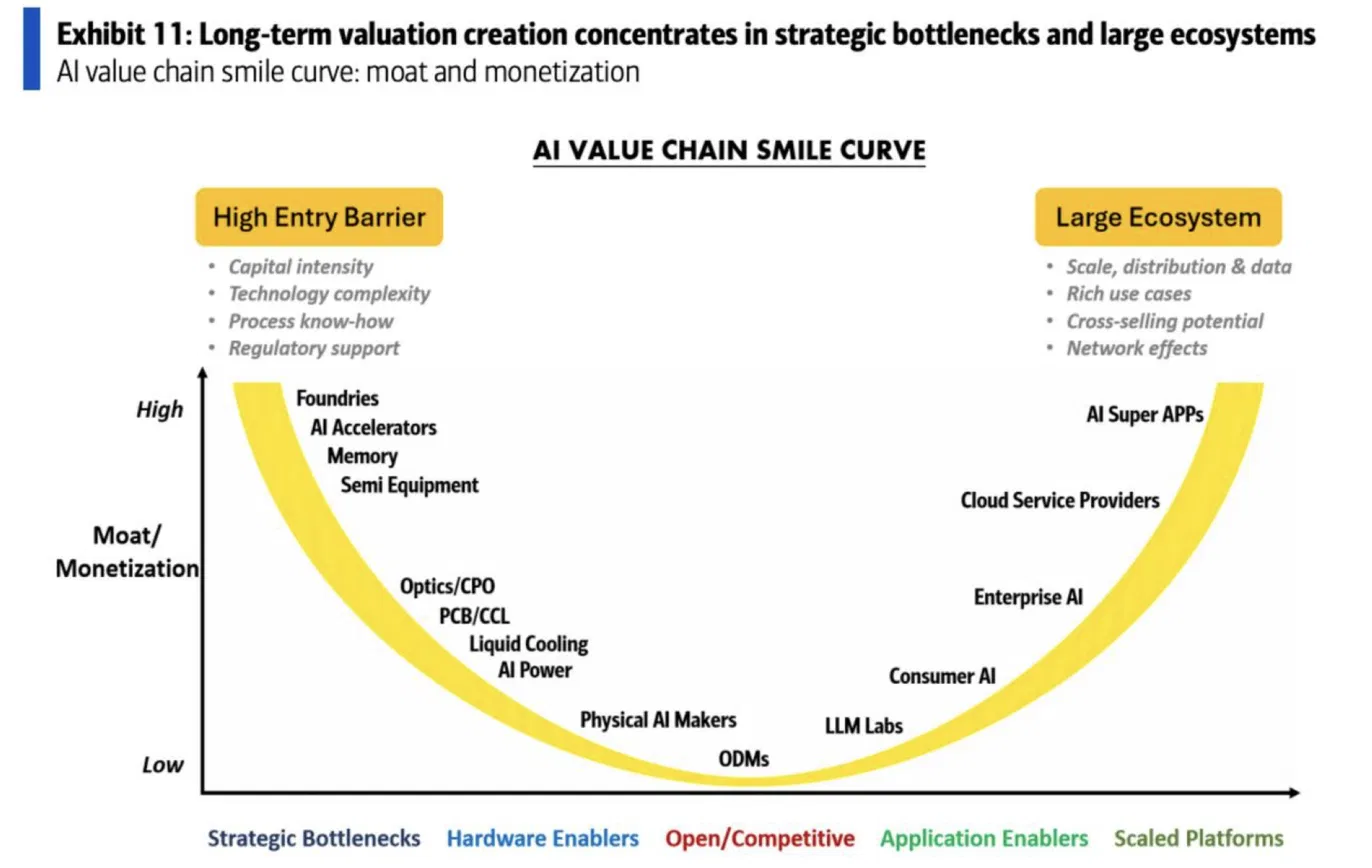
读者,本周美银(BofA)在一份中国AI报告中收录的一张图表在各处流传。其标题为“AI价值链微笑曲线”1。纵轴是“护城河与商业化变现”,横轴是价值链的环节顺序。曲线从左端高位起始,在中间触底,随后又在右端回升。形状宛如一张微笑的嘴唇。
左上方分布着晶圆代工、AI加速器、内存以及半导体设备。美银将这一区间称为“战略瓶颈”。这是一个资金密集、技术复杂、需要工艺诀窍(know-how)且有政府大力扶持的领域。报告摘要将华为、中芯国际(SMIC)、长鑫存储(CXMT)归入此类。右上方则是云服务商与“AI超级应用”。它们手握规模、分发渠道、数据、交叉销售以及网络效应,阿里云被列为典型代表。
接着是谷底。在曲线最低的位置,并排坐着ODM2、具身AI(Physical AI)制造商以及大语言模型(LLM)实验室。摘要重点提到了两个数字:DeepSeek的价格仅为Anthropic的1.5%左右;宇树科技(Unitree)售出的机器人中,仍有70%流向了高校。
本文基于公开发布的图表(Exhibit 11)及摘要内容写就。由于未能阅读报告全文,笔者无法核实这两个数字具体是在哪些指标之间进行的对比。在这一局限之下,我们不妨将这张图表所言与未尽之言拆开来进行一番解读。
 在最初的曲线中,研发本处于高位
微笑曲线是宏碁创始人施振荣在1992年为解释PC产业而绘制的概念图。左端是研发与核心零部件,右端是品牌与服务,中间的谷底则是组装。这张图旨在说服台湾PC企业:仅靠代工组装,几乎无利可图。
在美银的版本中,ODM处于谷底,这与原版并无二致。组装服务器并交付客户,无论是30年前还是今天,拿到的都是最微薄的利润率。真正反常的位置在它旁边:在原版中本应位于左上方、投入最多研发费用的组织,如今却坐落在了组装工厂身旁。
这说明技术难度与凭借该技术赚取收益完全是两码事。重看图表左侧的四行说明,“技术复杂度”仅仅是其中之一。其余三项是资本、工艺诀窍和政策扶持。这三项全都是让竞争对手需要耗费漫长时间才能跟进的壁垒。模型虽然很难,但在中国,每隔几个月就会冒出水平相近的新模型。
为什么在中国模型处于最底端
DeepSeek的价格仅为Anthropic的1.5%,这一数字在走向上与其他资料是一致的。今年7月,OpenRouter的数据负责人曾表示,中国开源权重模型比Anthropic或OpenAI的顶级模型便宜60~90%。美银(BofA)给出的1.5%是一个极端得多的数值,但摘要中并未说明究竟是拿哪款模型的哪种费率进行的对比。
从营收来看,差距更为明显。据9月17日报道的荣鼎咨询(Rhodium Group)报告,DeepSeek的年化营收(ARR)3为5亿美元,MiniMax为8亿美元,月之暗面(Moonshot)为10亿美元。据CNBC报道,智谱在投资者会议上透露其数据为18亿美元。在同一份报告中,OpenAI为400亿美元,Anthropic为650亿美元。即便把字节跳动(40亿美元)和阿里巴巴(24亿美元)的模型营收加起来,也不及这两家美国公司的十分之一。
这里值得注意的是,在美国,LLM实验室并不在谷底。如果以相同的坐标轴绘制美国的价值链,Anthropic应该落在曲线高得多的位置。因此,不能把这张图表理解为“AI行业本来在模型层就赚不到钱”。这是一张属于中国的地图。
图表并没有解释为什么在中国模型会滑落至底端。以下是我的个人解读。第一,一旦开源权重,任何人都能利用该模型销售推理服务。提供DeepSeek模型调用服务最多的并不一定是DeepSeek自身,事实上云厂商都在自己的基础设施上部署并对外销售。研发模型的主体与收取Token费用的主体发生了割裂。第二,掌握分发渠道的平台同样拥有自研模型。阿里巴巴和字节跳动在一家公司内部同时囊括了芯片、云计算、模型和应用,使得独立实验室不得不向既是客户又是竞争对手的巨头供货。第三,则是第233期中探讨过的问题:中国实验室的GPU仍被大量绑定在训练上,因此本身能够拿来售卖的Token量就相对较少。
不过,将现状概括为“实验室全部在打价格战”只说对了一半。月之暗面在7月推出Kimi K3时,将价格定在了与Anthropic的Sonnet系列相近的水平。智谱也表示在提高API价格后,调用量反而有所增加。已经有实验室开始尝试靠性能来争取溢价。如果这种尝试奏效,曲线的底部就不会一直保持现在的形状。至于能否奏效,目前尚不可知。
纵轴上并列写着两个词
这张图表的纵轴是“护城河/商业化”。虽然用一条斜杠连在一起,但这是两个截然不同的问题。护城河问的是别人能不能进得来,商业化问的则是眼下能不能收得到钱。
左上角两者兼备。晶圆代工与存储芯片极难进入,且眼下确实在赚钱。右上角的情况则有所不同。位于顶峰的“AI超级应用”眼下究竟能赚多少钱,无论在图表还是摘要中都没有任何数字。其下方的云厂商,正如我们在第233期中看到的,阿里云的利润率为11~12%。规模与渠道构成的护城河确实清晰可见,但商业化变现仍处于进行时。
图表的原标题给出了提示:“长期价值创造集中于战略瓶颈与大型生态系统”。其中明确带着“长期”二字。因此,这幅图的左侧更接近当下的损益,右侧则更接近未来的展望。如果将其转述为“切实赚钱的曲线”,右半部分就成了夸大其词。两端哪怕在画法上处于相同的高度,也绝不意味着拥有同等的确定性。
当买机器人的人也是研究机器人的人时
具身智能制造企业同样处在谷底附近。人形机器人的出货量虽然在快速增长,但根据报告摘要,宇树科技(Unitree)销量的 70% 都流向了高校。
这个数字所揭示的是购买理由。大学实验室购买机器人并不是为了让它们去干活,而是为了研究机器人本身。这与工厂为了顶替一个人工人去采购,在需求属性上截然不同。科研需求的大小取决于科研经费预算,且仅限于此。即便出货量急剧攀升,也不能证明“干活的机器人”市场已经真正打开。
Oswarld视角
模型处于底部的这幅图景,从购买并使用模型的一方来看,早已是司空见惯的常态。
我在设计面向企业的项目交付或 AX(AI 转型)咨询时,总是从“模型性能必然不断提升”这一前提出发。在为公共机构搭建内网隔离环境时也是如此。我们不会局限于眼下已有的模型,而是抱着对 6~12 个月后即将问世的开放权重模型大概能达到何种水准的预期,来规划整个项目。这样设计下来,模型就成了随时可以替换的零件。真正难以替换的,是底层的设备,以及堆叠其上的业务流与数据。只要采购方保持这种设计逻辑,模型研发厂商就很难提高议价空间。微笑曲线的底部,固然由供应商之间的竞争所造就,但同样也是被采购方的设计惯性所塑造出来的。
如果把韩国投射到这张图表上,其位置颇为微妙。左上方标着“Memory(存储芯片)”,那里正是韩国企业早已占据的阵地。与此同时,在主权 AI 的探讨中,我们倾注最多心力的却是自主模型——也就是这张图表的底层方框。这并不是说我们不该研发模型,而是说我们也必须直面中国图表所提出的追问:那些模型的 Token 费用究竟流向了谁,分发分发渠道又掌握在谁手中?韩国拥有 Naver 和 Kakao 这样平台与模型兼备的结构,因此比起美国,或许与中国的版图更为相似。
结语
在这张图表中,我深信不疑的是左半部分。掌握瓶颈的一方如今正在赚取真金白银,而且这一点已被亮眼的财报业绩所证实。右半部分则是前瞻预测,而底部则是中国自身的实际处境。底部的格局究竟会如何演变,取决于月之暗面和智谱 AI 的价格实验能否奏效。
本文不构成对任何特定股票或资产的投资建议。文中所引用的美银图表之位置与数值,均代表美银自身的研判。
💬 过去一年里,你们公司使用的模型更换过几次?在切换模型时,最让你感到棘手或繁琐的问题是什么?欢迎在评论区分享你的经历。
📨 如果你身边有正在关注和研究中国 AI 企业的同事或朋友,欢迎将本文分享给他们。


参考资料与延伸阅读
- BofA Global Research, “Exhibit 11: Long-term valuation creation concentrates in strategic bottlenecks and large ecosystems”, 2026. ··· 本文参考的图表。未能查阅报告全文,是基于该图表及公开发布的摘要内容撰写的。
- Rhodium Group 报告相关报道,富途牛牛,2026-09-17 ··· 中国各 AI 企业的 ARR 以及与美国两家公司的对比数据均出自此处。
- 彭博社,Kimi K3 发布报道(Yahoo Finance HK 转载),2026-07-17 ··· 其中提及月之暗面将 K3 的定价定在 Sonnet 系列水平。
- 澎湃新闻,“AI四小龙,估值破万亿”,2026-05-08 ··· 报道了智谱的上调价格以及随后的调用量增长。
- 网易,美国企业使用中国模型相关报道,2026-07-08 ··· OpenRouter 数据负责人的 60~90% 言论出处。
