

HBM最底层打响了地盘争夺战
运算芯片的内存窗口正下沉到HBM的最底层。谁能掌握这一底层的设计图,是留给我们的问题
商业昂贵芯片的边缘被窗口占据
读者,让我们试着从上方俯瞰一枚AI加速器。中间是运算芯片(compute die),两侧紧贴着HBM堆叠。运算芯片是用最先进的制程打造的硅片,因此每一平方毫米都弥足珍贵。然而,这片土地的边缘并非被用于运算,而是被与旁边HBM交换信号的窗口占据了。这个窗口分为两个部分:一个是整理数据何时何地读写的内存控制器,另一个是将实际电信号发送到芯片外部的物理层,也就是PHY1。
有一项估算显示了这个窗口有多大。某半导体分析报告估计,在英伟达Rubin运算芯片中,HBM4控制器和PHY所占的面积约为16%。这并非公司公布的数字,而是外部的估算。但方向是明确的。在最尖端制程这片昂贵的土地上,有相当一部分不可忽视的份额被用于通信,而非运算。
在这一期里,我们将通过三星电子图纸上的数字,看看这个窗口每一代究竟变大了多少,再看看定制HBM是如何缩小这个窗口的。接下来我们会看看8月末英伟达推出的NVHBM,给这一变化带来了什么样的新问题。
每换一代,窗口就变宽一次
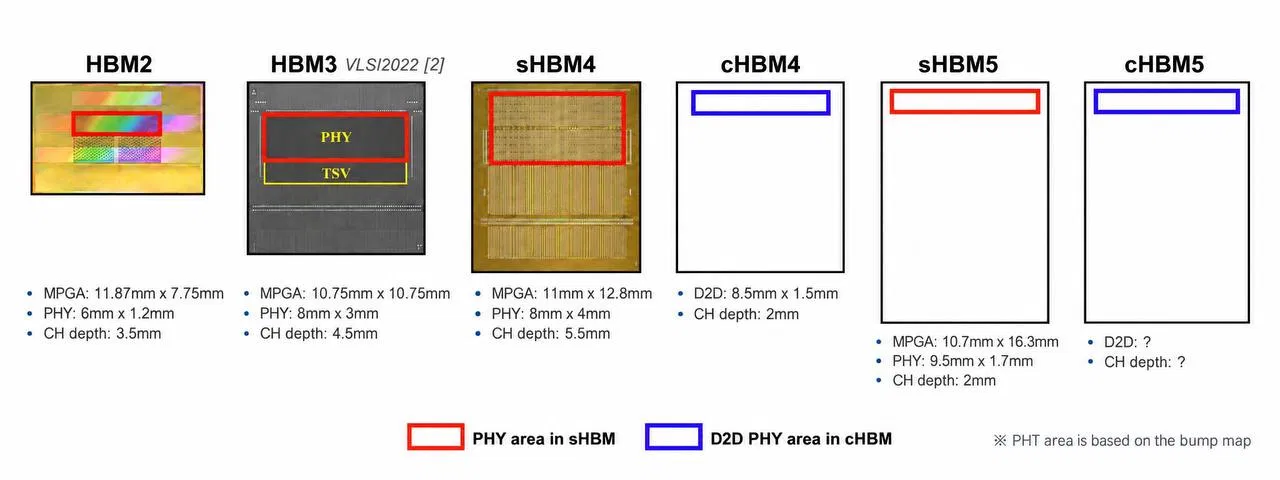
三星电子的HBM世代比较图上标注了各世代的PHY尺寸。把长宽相乘换算成面积,结果如下。
| 分类 | PHY尺寸 | 面积(计算值) |
|---|---|---|
| HBM2 | 6mm × 1.2mm | 约7.2mm² |
| HBM3 | 8mm × 3mm | 24mm² |
| 标准HBM4 | 8mm × 4mm | 32mm² |
| 定制HBM4的D2D接口 | 8.5mm × 1.5mm | 约12.75mm² |
| 标准HBM5 | 9.5mm × 1.7mm | 约16.15mm² |
这张图画的是HBM芯片一侧信号进出的区域,图注说明是以凸点(bump)布局图为基准绘制的。运算芯片一侧的窗口也要接收同样的信号线,所以这些数字可以当作一个指标,用来看两侧窗口的大小朝哪个方向变化。
从HBM2到标准HBM4,PHY面积增大了四倍以上。信号线数量增加是主要原因。按三星电子的说明,HBM4的数据输入输出引脚从1,024个增加到了2,048个,翻了一倍。就像车道增多、收费站的收费亭也要跟着增多一样,往来的线路越多,窗口也就越宽。
定制HBM4的数字打破了这一趋势。标准HBM4的PHY是32mm²,而定制HBM4使用的芯片间(D2D)2接口约为12.75mm²,减少了约60%。两个尺寸中较长的一边反而从8mm略增到8.5mm,较短的一边则从4mm大幅缩减到1.5mm。
值得注意的是,标准HBM5的PHY面积标注得比标准HBM4更小。这可以理解为标准规格也在朝着缩小窗口的方向发展,但HBM5目前还没有产品问世,仅凭一个数字就断言趋势还为时尚早。定制HBM5的D2D尺寸在图上仍标为问号。
 控制器搬到楼下去
减少窗口数量的方法不止于更换 PHY。还可以把内存控制器本身从运算芯片中移出,搬到 HBM 堆栈最底层的基础芯片3上。
这之所以成为可能,背景在于基础芯片工艺的变化。截至上一代,HBM 基础芯片都是用 D 内存工艺制造的,而从 HBM4 开始,用逻辑工艺制造的路径打开了。三星电子表示,其 HBM4 使用 4 纳米逻辑基础芯片。逻辑工艺的晶体管更小,布线层也更多,因此在相同面积内可以容纳更多电路。
控制器下移到基础芯片后,运算芯片与 HBM 之间就不再是标准 HBM 总线,而只剩下更窄、更快的 D2D 连接。 运算芯片可以同时收回此前被控制器占用的面积和被宽 PHY 占用的面积,在那里塞进更多运算单元或缓存。半导体设计专业媒体 Semiconductor Engineering 整理的业界说法也指向同一个方向:控制器在基础芯片上新占用的面积,比在运算芯片上节省下来的面积更便宜。相当于把同样的电路,从最贵的地皮搬到更便宜的地皮上。
三星电子还更进一步。根据三星电子的说明,搭载定制 HBM 控制器的基础芯片,还可以加入用于 SRAM 修复的备用资源、状态监测功能、与外部内存的连接,甚至是在 D 内存正下方处理部分运算的功能。基础芯片正从一块单纯中继信号的底板,变成一颗小型逻辑芯片。
所以定制 HBM 的效果是双重的。一方面是性能层面的效果,即接口单位面积的带宽提升、中介层4布线变得简单;另一方面是结构层面的效果,即运算芯片上的地皮可以重新规划布局。这既是一项提升带宽的技术,也是一项重新绘制加速器布局图的技术。
<<<OZ_BODY>>>
英伟达率先拿着设计图登场
这个变化从图纸里的故事走向市场故事,是在8月26日。英伟达扩展NVLink Fusion计划,同时发布了NVHBM。
NVHBM和前面提到的定制HBM方向一致。英伟达把自己设计的内存控制器放进HBM基础芯片,用更窄的串行D2D连接取代标准总线。英伟达宣称,与标准HBM4E相比,每堆栈带宽最多提升30%,HBM功耗降低15%,运算芯片面积最多可多出25%。 引用英伟达技术博客的报道则写道运算芯片面积最多增加30%,数字略有出入。不管是哪个版本,都只是公司方面的说法,并非经过实际产品验证的数值。
比起性能数字,我更留意的是角色分工。此前,定制HBM一直被描述为由内存厂商与客户共同设计基础芯片的方式。而NVHBM是由英伟达确定控制器和接口,再由多家内存厂商提供并验证同一套实现方案的结构。英伟达方面解释说,这样一来可以减少整合与验证多家供应商内存所需的工夫。英伟达还表示,NVHBM与其未来自家GPU将使用的技术基础相同。
能使用这项技术的公司也是限定的。NVHBM是向NVLink Fusion合作伙伴开放的组件,首批合作伙伴中列入了亚马逊的芯片设计部门Annapurna Labs。Annapurna表示将从Trainium4开始支持NVLink Fusion。不过英伟达博客并未明确说明Trainium4会采用NVHBM。
三星电子方面也公布了时间表。该公司表示,HBM4E样品将于2026年下半年、定制HBM样品将从2027年起向客户供货。也就是说,在同一个基础层上,内存厂商的定制设计与英伟达的实现方案,将在相近的时间点进入市场。
Oswarld视角
我从这则消息里,首先看到的不是带宽数字,而是基础裸片(Base Die)的设计权归谁所有。 当HBM最底层只是传递信号的底板时,内存公司自己做主生产就行了。但当这一层开始加入控制器、承担部分运算功能时,这一层就成了加速器设计的一部分。
如果这一层由内存公司和客户共同设计,内存公司就等于向客户的芯片设计内部迈进了一步。如果客户决定具体实现方式,再让多家公司按同一规格供货,那么内存公司之间的竞争,就变成了谁能把别人定好的图纸做得更好、更多。 这两种情况下,内存公司的营收都可能增长,但议价能力会沉淀在哪一方,差别相当大。
结语
夺回运算芯片地盘的技术,说到底就是在 HBM 最底层叠加新电路的技术。而同一项技术究竟是给存储芯片公司带来机会,还是沦为跟着既定规格走的苦差事,取决于那一层电路的设计权握在谁手里。 2027 年定制 HBM 样品问世时,我打算把性能表和合约的形态一并放在一起看。
💬 在挑选或评估 AI 芯片时,您有没有留意过存储设计的主导权究竟握在谁手中?欢迎在评论区分享您的想法。
📨 如果您身边也有一起关注半导体供应链的同事,欢迎把这篇文章分享给他们。
<<<OZ_BODY>>>


参考资料与延伸阅读
- Samsung Ships Industry-First Commercial HBM4 With Ultimate Performance for AI Computing(三星电子新闻室)
- NVIDIA NVLink Fusion Expands With NVHBM Custom High-Bandwidth Memory(NVIDIA 博客)
- Nvidia unveils custom high-bandwidth memory(TechRadar)
- NVIDIA NVHBM Moves the Memory Controller Into the HBM Stack(StorageReview)
- Nvidia expands NVLink Fusion strategy to supercharge custom silicon memory(SDxCentral)
- How Will The Custom HBM Business Work?(Semiconductor Engineering)

📝 术语说明
注释
-
PHY(物理层):把芯片内部的数字信号传送到芯片外部电线、并接收返回信号的电路。它与负责整理数据的控制器搭配,共同构成内存的出入口。 ↩
-
D2D(Die-to-Die)接口:用于连接同一封装内并排放置的芯片之间的短距离通信电路。由于不需要把信号传送到很远的地方,因此可以做得比标准内存 PHY 更小。 ↩
-
基础芯片(Base Die):HBM 中 D 内存层层堆叠所依托的最底层芯片。它在上层 D 内存与外部芯片之间中继信号,从 HBM4 开始改用逻辑工艺制造,从而能够容纳更多功能。 ↩
-
中介层(Interposer):将运算芯片与 HBM 一同放置在同一块基板上、并将二者紧密连接起来的中间基板。信号线越多,这块基板的布线设计就越复杂。 <<<OZ_END>>> ↩
延伸阅读
搜索“暗黑模式”的人,是在找法律条款,还是在找酷澎?
韩国公正委于10月6日发布了暗黑模式指南。在法律直接禁止的6种类型、指南中的13种类型与人们实际联想到的界面之间,存在着比想象中更大的鸿沟。
商业电磁波屏蔽贴纸没用的发布,已经是第12年了
政府说明材料里,“安全”和“减少”写在同一页上
商业Meta Muse Spark Open,家里是不是要开始需要超级计算机了
816B 的开放权重被装进了两台 Mac Studio。决定 token 速度的内存带宽、Meta 关闭后又重新开放的原因、1T 成为默认值的开放权重格局,以及销售这些内存的三星电子季度业绩,一次全看懂。
商业
你的观点会成为下一期的线索
欢迎留下你的经验与看法。