

HBM 맨 아래층에서 땅 싸움이 시작됐어요
연산 칩의 메모리 창구가 HBM 바닥층으로 내려가요. 그 바닥층의 설계도를 누가 쥐는지가 남은 질문이에요
비즈니스비싼 칩의 가장자리를 창구가 차지하고 있어요
구독자님, AI 가속기 하나를 위에서 내려다본다고 해볼게요. 가운데 연산 다이(compute die)가 있고, 그 양옆에 HBM 스택이 바짝 붙어 있어요. 연산 다이는 가장 앞선 공정으로 만드는 실리콘이라 1제곱밀리미터도 아까운 땅이에요. 그런데 이 땅의 가장자리를 계산이 아니라 옆의 HBM과 신호를 주고받는 창구가 차지하고 있어요. 창구는 두 부분으로 나뉘어요. 데이터를 언제 어디서 읽고 쓸지 정리하는 메모리 컨트롤러, 그리고 실제 전기 신호를 칩 밖으로 내보내는 물리 계층인 PHY1예요.
이 창구가 얼마나 넓은지 보여주는 추정이 있어요. 한 반도체 분석 리포트는 엔비디아 루빈 연산 다이에서 HBM4 컨트롤러와 PHY가 차지하는 면적을 약 16%로 봤어요. 회사가 공개한 수치가 아니라 외부 추정이에요. 그래도 방향은 분명해요. 최첨단 공정의 비싼 땅 가운데 무시하기 어려운 몫이 연산이 아니라 통신에 쓰이고 있어요.
이번 호에서는 삼성전자 도면의 숫자로 이 창구가 세대마다 얼마나 커졌는지 보고, 커스텀 HBM이 창구를 어떻게 줄이는지 살펴볼게요. 그다음 8월 말 엔비디아가 내놓은 NVHBM이 이 변화에 어떤 질문을 얹었는지 볼게요.
세대가 바뀔 때마다 창구가 넓어졌어요
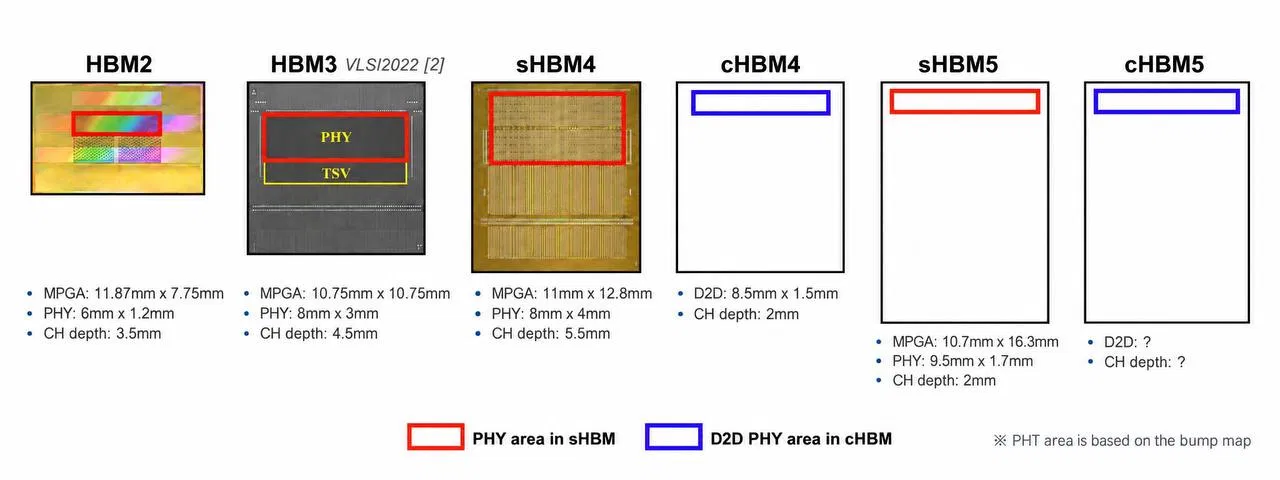
삼성전자의 HBM 세대 비교 도면에는 세대별 PHY 크기가 적혀 있어요. 가로·세로를 곱해 면적으로 바꿔보면 이래요.
| 구분 | PHY 크기 | 면적(계산값) |
|---|---|---|
| HBM2 | 6mm × 1.2mm | 약 7.2mm² |
| HBM3 | 8mm × 3mm | 24mm² |
| 표준 HBM4 | 8mm × 4mm | 32mm² |
| 커스텀 HBM4의 D2D 인터페이스 | 8.5mm × 1.5mm | 약 12.75mm² |
| 표준 HBM5 | 9.5mm × 1.7mm | 약 16.15mm² |
이 도면은 HBM 다이 쪽에서 신호가 드나드는 영역을 그린 것이고, 도면 주석에 따르면 범프 배치도를 기준으로 잡았어요. 연산 다이 쪽 창구도 같은 신호선을 받아야 하니, 이 숫자는 양쪽 창구의 크기가 어느 방향으로 움직이는지 보여주는 지표로 읽으시면 돼요.
HBM2에서 표준 HBM4까지 PHY 면적은 네 배 넘게 커졌어요. 신호선 수가 늘어난 게 큰 이유예요. 삼성전자 설명으로는 HBM4에서 데이터 입출력 핀이 1,024개에서 2,048개로 두 배가 됐어요. 차선이 늘면 톨게이트 부스도 늘어나는 것처럼, 오가는 선이 많아질수록 창구도 넓어져요.
커스텀 HBM4의 숫자는 이 흐름을 꺾어요. 표준 HBM4 PHY가 32mm²인데 커스텀 HBM4가 쓰는 다이 간(D2D)2 인터페이스는 약 12.75mm²예요. 60% 정도 줄어요. 두 치수 가운데 긴 쪽은 8mm에서 8.5mm로 오히려 조금 늘었고, 짧은 쪽이 4mm에서 1.5mm로 크게 줄었어요.
표준 HBM5의 PHY 면적이 표준 HBM4보다 작게 적혀 있는 점도 눈에 띄어요. 표준 규격도 창구를 줄이는 쪽으로 움직인다고 읽을 수 있지만, HBM5는 아직 제품이 나오지 않은 세대라 숫자 하나로 추세를 말하기는 일러요. 커스텀 HBM5의 D2D 크기는 도면에 물음표로 남아 있어요.
 컨트롤러가 아래층으로 이사 가요
창구를 줄이는 방법은 PHY를 바꾸는 데서 끝나지 않아요. 메모리 컨트롤러 자체를 연산 다이에서 빼서 HBM 스택의 맨 아래층, 베이스 다이3로 옮길 수 있어요.
이게 가능해진 배경에는 베이스 다이의 공정 변화가 있어요. 이전 세대까지 HBM 베이스 다이는 D램 공정으로 만들었는데, HBM4부터는 로직 공정으로 만드는 길이 열렸어요. 삼성전자는 자사 HBM4에 4나노 로직 베이스 다이를 쓴다고 밝혔어요. 로직 공정은 트랜지스터가 작고 배선 층도 많아서 같은 면적에 훨씬 많은 회로를 넣을 수 있어요.
컨트롤러가 베이스 다이로 내려가면 연산 다이와 HBM 사이에는 표준 HBM 버스 대신 더 좁고 빠른 D2D 연결만 남아요. 연산 다이는 컨트롤러가 쓰던 땅과 넓은 PHY가 쓰던 땅을 함께 돌려받고, 그 자리에 연산 유닛이나 캐시를 더 넣을 수 있어요. 반도체 설계 전문 매체 세미컨덕터 엔지니어링이 정리한 업계 설명도 같은 방향이에요. 컨트롤러가 베이스 다이에 새로 차지하는 면적은 연산 다이에서 아끼는 면적보다 싸다는 거예요. 같은 회로를 가장 비싼 땅에서 그보다 싼 땅으로 옮기는 셈이에요.
삼성전자는 여기서 더 나아가요. 삼성전자 설명에 따르면 커스텀 HBM 컨트롤러가 들어간 베이스 다이에는 SRAM 복구용 예비 자원, 상태 모니터링 기능, 외부 메모리와의 연결, D램 바로 아래에서 일부 연산을 처리하는 기능까지 넣을 수 있어요. 베이스 다이가 신호를 중계하는 바닥판에서 작은 로직 칩으로 바뀌는 그림이에요.
그래서 커스텀 HBM의 효과는 두 겹이에요. 인터페이스 면적당 대역폭이 올라가고 인터포저4 배선이 단순해지는 성능 쪽 효과가 있고, 연산 다이의 땅을 다시 배치할 수 있는 구조 쪽 효과가 있어요. 대역폭을 높이는 기술이면서 가속기의 배치도를 다시 그리는 기술이기도 해요.
엔비디아가 설계도를 들고 먼저 나왔어요
이 변화가 도면 속 이야기에서 시장 이야기로 넘어온 건 8월 26일이에요. 엔비디아가 NVLink Fusion 프로그램을 확장하면서 NVHBM을 발표했어요.
NVHBM은 앞에서 본 커스텀 HBM과 같은 방향이에요. 엔비디아가 설계한 메모리 컨트롤러를 HBM 베이스 다이에 넣고, 표준 버스 대신 더 좁은 직렬 D2D 연결을 써요. 엔비디아는 표준 HBM4E와 비교해 스택당 대역폭 최대 30% 증가, HBM 전력 15% 절감, 연산 다이 면적 최대 25% 확보를 내세웠어요. 엔비디아 기술 블로그를 인용한 보도에는 연산 다이 면적이 최대 30% 늘어난다고 적혀 있어 수치가 엇갈려요. 어느 쪽이든 회사 주장이고 실제 제품에서 검증된 값은 아니에요.
제가 눈여겨본 건 성능 숫자보다 역할 분담이에요. 지금까지 커스텀 HBM은 메모리 회사와 고객사가 베이스 다이를 함께 설계하는 방식으로 이야기돼 왔어요. NVHBM은 엔비디아가 컨트롤러와 인터페이스를 정하고, 여러 메모리 회사가 같은 구현을 공급하고 검증하는 구조예요. 엔비디아는 이렇게 하면 여러 공급사의 메모리를 통합하고 검증하는 수고가 줄어든다고 설명해요. 또 NVHBM이 엔비디아가 앞으로 자사 GPU에 쓸 기술과 같은 기반이라고 밝혔어요.
쓸 수 있는 회사도 정해져 있어요. NVHBM은 NVLink Fusion 파트너에게 열리는 구성 요소이고, 첫 협력사로 아마존의 칩 설계 조직 안나푸르나 랩스가 이름을 올렸어요. 안나푸르나는 트레이니엄4부터 NVLink Fusion을 지원한다고 했어요. 다만 엔비디아 블로그가 트레이니엄4에 NVHBM이 들어간다고 명시하지는 않았어요.
삼성전자도 일정을 내놓은 상태예요. HBM4E 샘플은 2026년 하반기, 커스텀 HBM 샘플은 2027년부터 고객사에 공급하겠다고 밝혔어요. 같은 바닥층을 두고 메모리 회사의 커스텀 설계와 엔비디아의 구현이 비슷한 시기에 시장에 나오는 셈이에요.
오스왈드의 시선
저는 이 소식에서 대역폭 숫자보다 베이스 다이의 설계 권한이 누구에게 가는지를 먼저 보게 돼요. HBM 맨 아래층이 신호를 중계하는 바닥판일 때는 메모리 회사가 알아서 만들면 됐어요. 그런데 그 층에 컨트롤러가 들어가고 연산 일부까지 맡게 되면, 그 층은 가속기 설계의 일부가 돼요.
이 층을 메모리 회사와 고객이 같이 설계하면 메모리 회사는 고객의 칩 설계 안으로 한 발 들어가요. 고객이 구현을 정하고 여러 회사에 같은 것을 공급받으면, 메모리 회사들은 남이 정한 도면을 누가 더 잘, 더 많이 만드느냐로 경쟁하게 돼요. 두 경우 모두 메모리 회사의 매출은 늘 수 있지만, 협상력이 어디에 쌓이는지는 꽤 달라져요.
마치며
연산 칩의 땅을 돌려받는 기술은 결국 HBM 맨 아래층에 새 회로를 올리는 기술이에요. 그 층의 회로를 누가 설계하느냐에 따라 같은 기술이 메모리 회사에 기회가 되기도 하고, 정해진 규격을 따라가는 일이 되기도 해요. 2027년 커스텀 HBM 샘플이 나올 때 성능표와 함께 계약의 모양도 같이 보려고 해요.
💬 AI 칩을 고르거나 평가할 때, 메모리 쪽 설계를 누가 쥐고 있는지까지 따져보신 적 있나요? 댓글로 들려주세요.
📨 반도체 공급망을 함께 보는 동료가 있다면 이 글을 공유해 주세요.
이미 구독 중이신가요? 로그인하고 댓글 남기기
커피 한 잔 보내기
이 관점이 좋았다면, 다음 글에 커피 한 잔
오스왈드에게 커피와 함께 짧은 쪽지를 보내주세요. 응원은 다음 취재와 집필에 보탭니다.


참고자료 & 더 읽기
- Samsung Ships Industry-First Commercial HBM4 With Ultimate Performance for AI Computing (삼성전자 뉴스룸)
- NVIDIA NVLink Fusion Expands With NVHBM Custom High-Bandwidth Memory (NVIDIA 블로그)
- Nvidia unveils custom high-bandwidth memory (TechRadar)
- NVIDIA NVHBM Moves the Memory Controller Into the HBM Stack (StorageReview)
- Nvidia expands NVLink Fusion strategy to supercharge custom silicon memory (SDxCentral)
- How Will The Custom HBM Business Work? (Semiconductor Engineering)

📝 용어 설명
각주
-
PHY (Physical Layer): 칩 안의 디지털 신호를 칩 밖의 전선으로 실어 보내고 받는 회로예요. 데이터를 정리하는 컨트롤러와 짝을 이뤄 메모리 창구를 만들어요. ↩
-
D2D (Die-to-Die) 인터페이스: 한 패키지 안에 나란히 놓인 칩끼리 짧은 거리로 연결하는 통신 회로예요. 멀리 신호를 보낼 필요가 없어 표준 메모리 PHY보다 작게 만들 수 있어요. ↩
-
베이스 다이 (Base Die): HBM의 D램 층들이 쌓이는 맨 아래 칩이에요. 위층 D램과 바깥 칩 사이에서 신호를 중계하고, HBM4부터는 로직 공정으로 만들어 더 많은 기능을 담을 수 있게 됐어요. ↩
-
인터포저 (Interposer): 연산 칩과 HBM을 한 판 위에 올려 촘촘하게 이어주는 중간 기판이에요. 신호선이 많을수록 이 판의 배선 설계가 복잡해져요. ↩
함께 읽으면 좋은 지난 호
다크패턴을 검색하는 사람은 법을 찾을까, 쿠팡을 찾을까
공정위가 10월 6일 다크패턴 가이드라인을 냈어요. 법이 직접 금지한 6가지, 가이드라인의 13가지, 사람들이 실제로 떠올리는 화면 사이에는 생각보다 큰 틈이 있어요.
비즈니스전자파 차단 스티커가 소용없다는 발표, 12년째예요
정부 안내문에는 '안전해요'와 '줄이세요'가 한 페이지에 같이 적혀 있어요
비즈니스메타 Muse Spark Open, 집에 슈퍼컴퓨터가 필요해지는 걸까요
816B 오픈 웨이트가 맥 스튜디오 두 대에 올라갔어요. 토큰 속도를 정하는 메모리 대역폭, 메타가 닫았다 다시 연 이유, 1T가 기본값이 된 오픈 웨이트 지형, 그 메모리를 파는 삼성전자의 분기 실적까지 한 번에 봐요.
비즈니스EU가 8월 기한을 넘겼는데, 2027년 2월은 그대로예요
대상이 아닌 항목을 먼저 걷어내야, 진짜 받아야 할 자료가 보여요
비즈니스
여러분의 생각이 다음 호를 만듭니다
이번 호에서 가장 공감했거나, 다른 경험을 한 지점은 무엇인가요?