

HBMの最下層で陣地争いが始まりました
演算チップのメモリ窓口がHBMの最下層へ下りていきます。その最下層の設計図を誰が握るのかが残された問いです
ビジネス高価なチップの縁を窓口が占めています
読者さん、AIアクセラレーターを一つ、上から見下ろしてみましょう。中央に演算ダイ(compute die)があり、その両脇にHBMスタックがぴったりと付いています。演算ダイは最先端の工程で作るシリコンなので、1平方ミリメートルも惜しい土地です。ところがこの土地の縁を、演算ではなく隣のHBMと信号をやり取りする窓口が占めています。窓口は二つの部分に分かれます。データをいつどこで読み書きするかを整理するメモリコントローラー、そして実際の電気信号をチップの外に送り出す物理層であるPHY1です。
この窓口がどれほど広いかを示す推定があります。ある半導体分析レポートは、NvidiaのRubin演算ダイでHBM4コントローラーとPHYが占める面積を約16%と見積もりました。同社が公開した数値ではなく、外部の推定です。それでも方向性は明確です。最先端工程の高価な土地のうち、無視できない分が演算ではなく通信に使われています。
今回は、サムスン電子の図面にある数字から、この窓口が世代ごとにどれだけ大きくなったのかを見て、カスタムHBMがその窓口をどう縮めるのかを確認します。続いて、8月末にNvidiaが発表したNVHBMが、この変化にどんな問いを投げかけたのかを見ていきます。
世代が変わるたびに窓口が広がっていました
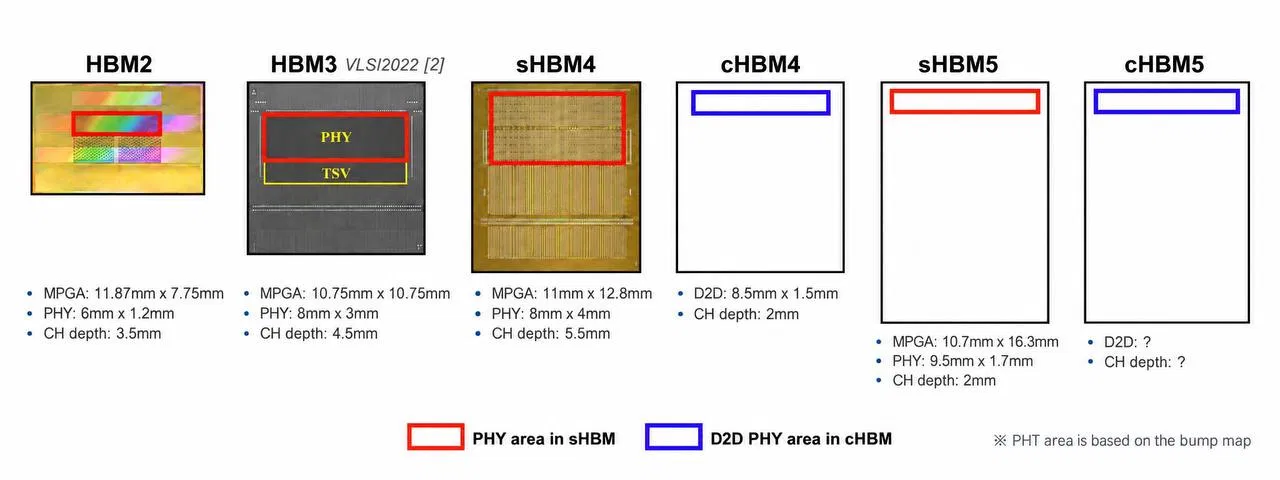
サムスン電子のHBM世代比較図には、世代ごとのPHYサイズが記載されています。縦・横を掛けて面積に換算すると、次のようになります。
| 区分 | PHYサイズ | 面積(計算値) |
|---|---|---|
| HBM2 | 6mm × 1.2mm | 約7.2mm² |
| HBM3 | 8mm × 3mm | 24mm² |
| 標準HBM4 | 8mm × 4mm | 32mm² |
| カスタムHBM4のD2Dインターフェース | 8.5mm × 1.5mm | 約12.75mm² |
| 標準HBM5 | 9.5mm × 1.7mm | 約16.15mm² |
この図はHBMダイ側で信号が出入りする領域を描いたもので、図の注釈によるとバンプ配置図を基準にしています。演算ダイ側の窓口も同じ信号線を受け取る必要があるため、この数字は両側の窓口の大きさがどちらの方向に動いているかを示す指標として読んでいただければと思います。
HBM2から標準HBM4まで、PHY面積は4倍以上に大きくなりました。信号線の数が増えたことが大きな理由です。サムスン電子の説明によれば、HBM4ではデータ入出力ピンが1,024個から2,048個へと倍になりました。車線が増えれば料金所のブースも増えるように、行き交う線が多くなるほど窓口も広がります。
カスタムHBM4の数字は、この流れを折り返します。標準HBM4のPHYが32mm²であるのに対し、カスタムHBM4が使うダイ間(D2D)2インターフェースは約12.75mm²です。60%ほど縮小しています。二つの寸法のうち長いほうは8mmから8.5mmへとむしろ少し増え、短いほうは4mmから1.5mmへと大きく縮んでいます。
標準HBM5のPHY面積が標準HBM4より小さく記載されている点も目を引きます。標準規格も窓口を縮小する方向に動いていると読むこともできますが、HBM5はまだ製品が出ていない世代であり、数字一つで傾向を語るのは時期尚早です。カスタムHBM5のD2Dサイズは、図の中で疑問符のまま残されています。
 コントローラーが下の階層に引っ越す
窓口を減らす方法は、PHYを変えるだけでは終わりません。メモリコントローラー自体を演算ダイから抜き出して、HBMスタックの一番下の層、ベースダイ3に移すことができます。
これが可能になった背景には、ベースダイの工程変化があります。これまでの世代まで、HBMベースダイはDRAM工程で作られていましたが、HBM4からはロジック工程で作る道が開かれました。サムスン電子は、自社のHBM4に4ナノのロジックベースダイを使うと明らかにしています。ロジック工程はトランジスタが小さく配線層も多いため、同じ面積にはるかに多くの回路を詰め込めます。
コントローラーがベースダイに降りると、演算ダイとHBMの間には標準HBMバスの代わりに、より狭く速いD2D接続だけが残ります。 演算ダイは、コントローラーが使っていた土地と広いPHYが使っていた土地を合わせて取り戻し、そこに演算ユニットやキャッシュをさらに積めます。半導体設計専門メディアのSemiconductor Engineeringがまとめた業界の説明も同じ方向を指しています。コントローラーがベースダイに新たに占める面積は、演算ダイで節約できる面積よりも安いというわけです。同じ回路を、最も高価な土地からそれより安い土地へ移すようなものです。
サムスン電子はここからさらに踏み込みます。サムスン電子の説明によれば、カスタムHBMコントローラーが搭載されたベースダイには、SRAM復旧用の予備資源、状態モニタリング機能、外部メモリとの接続、さらにはDRAMのすぐ下で一部の演算を処理する機能まで組み込めます。ベースダイが信号を中継する土台から、小さなロジックチップへと姿を変える絵図です。
そのため、カスタムHBMの効果は二重です。インターフェース面積当たりの帯域幅が上がり、インターポーザー4の配線が単純になるという性能面の効果があり、演算ダイの土地を再配置できるという構造面の効果があります。帯域幅を高める技術であると同時に、アクセラレーターの配置図を描き直す技術でもあるのです。
Nvidiaが設計図を手に先に名乗りを上げました
この変化が図面の中の話から市場の話に移ったのは8月26日です。NvidiaがNVLink Fusionプログラムを拡張し、NVHBMを発表しました。
NVHBMは先に見たカスタムHBMと同じ方向性です。Nvidiaが設計したメモリコントローラーをHBMベースダイに組み込み、標準バスの代わりによりナローなシリアルD2D接続を使います。Nvidiaは標準HBM4E比でスタックあたりの帯域幅を最大30%向上、HBM消費電力を15%削減、演算ダイ面積を最大25%確保できると主張しています。Nvidiaの技術ブログを引用した報道には演算ダイ面積が最大30%増えると書かれており、数値に食い違いがあります。いずれにせよこれは同社の主張であり、実製品で検証された値ではありません。
私が注目したのは性能の数字よりも役割分担です。これまでカスタムHBMは、メモリ会社と顧客企業がベースダイを共同設計する方式として語られてきました。NVHBMはNvidiaがコントローラーとインターフェースを定め、複数のメモリ会社が同じ実装を供給・検証する構造です。Nvidiaはこうすることで、複数の供給元のメモリを統合・検証する手間が減ると説明しています。また、NVHBMは今後Nvidiaが自社GPUに使う技術と同じ基盤だとも明らかにしました。
利用できる会社も決まっています。NVHBMはNVLink Fusionパートナーに開かれたコンポーネントで、最初の協力社としてAmazonのチップ設計組織であるAnnapurna Labsが名を連ねました。Annapurnaは、Trainium4からNVLink Fusionをサポートすると述べています。ただし、NvidiaのブログがTrainium4にNVHBMが搭載されると明示しているわけではありません。
サムスン電子もスケジュールを示しています。HBM4Eのサンプルは2026年下半期、カスタムHBMのサンプルは2027年から顧客企業に供給すると発表しました。同じベースダイ層をめぐって、メモリ会社によるカスタム設計とNvidiaによる実装が、ほぼ同時期に市場に出てくることになります。
Oswarldの視点
私はこのニュースで、帯域幅の数字よりもベースダイの設計権限が誰の手に渡るのかをまず見てしまいます。 HBMの一番下の層が信号を中継するだけの土台板だったときは、メモリー会社が自分たちの裁量で作ればよかったんです。ところがこの層にコントローラーが入り、演算の一部まで担うようになると、この層はアクセラレータ設計の一部になってしまいます。
この層をメモリー会社と顧客が共同で設計すれば、メモリー会社は顧客のチップ設計の内側に一歩踏み込むことになります。顧客が実装を定め、複数の会社から同じものを供給してもらう形になれば、メモリー会社同士は他人が引いた図面を誰がより上手く、より多く作れるかで競争することになります。 どちらの場合もメモリー会社の売上は伸びる可能性がありますが、交渉力がどこに積み上がるのかはかなり変わってきます。
おわりに
演算チップの土地を取り戻す技術は、結局のところHBM最下層に新しい回路を載せる技術です。その層の回路を誰が設計するかによって、同じ技術がメモリー会社にとってチャンスにもなれば、決められた規格に従うだけの仕事にもなります。2027年にカスタムHBMのサンプルが出てくるとき、性能表と一緒に契約の形も合わせて見ていこうと思います。
💬 AIチップを選んだり評価したりするとき、メモリー側の設計を誰が握っているかまで検討したことはありますか?コメントで聞かせてください。
📨 半導体サプライチェーンを一緒に見ている同僚がいれば、この記事をシェアしてください。


参考資料と関連リンク
- Samsung Ships Industry-First Commercial HBM4 With Ultimate Performance for AI Computing(サムスン電子ニュースルーム)
- NVIDIA NVLink Fusion Expands With NVHBM Custom High-Bandwidth Memory(NVIDIAブログ)
- Nvidia unveils custom high-bandwidth memory(TechRadar)
- NVIDIA NVHBM Moves the Memory Controller Into the HBM Stack(StorageReview)
- Nvidia expands NVLink Fusion strategy to supercharge custom silicon memory(SDxCentral)
- How Will The Custom HBM Business Work?(Semiconductor Engineering)

📝 用語解説
각주
-
PHY(Physical Layer):チップ内のデジタル信号をチップ外の配線へ送り出し、また受け取るための回路です。データを整理するコントローラーと対になってメモリの窓口を作ります。 ↩
-
D2D(Die-to-Die)インターフェース:ひとつのパッケージの中に並んで置かれたチップ同士を短距離でつなぐ通信回路です。遠くまで信号を送る必要がないため、標準的なメモリPHYよりも小さく作ることができます。 ↩
-
ベースダイ(Base Die):HBMのDRAM層が積み重なる、いちばん下のチップです。上層のDRAMと外部チップとの間で信号を中継し、HBM4からはロジック工程で作られるようになったことで、より多くの機能を詰め込めるようになりました。 ↩
-
インターポーザー(Interposer):演算チップとHBMをひとつの基板の上に載せ、密に接続する中間基板です。信号線が増えるほど、この基板の配線設計は複雑になります。 ↩
あわせて読みたい過去の号
ダークパターンを検索する人は法律を探しているのか、クーパンを探しているのか
韓国の公正取引委員会が10月6日、ダークパターンのガイドラインを発表しました。法律が直接禁止する6項目、ガイドラインの13類型、人々が実際に思い浮かべる画面の間には、思いのほか大きな隔たりがあります。
ビジネス電磁波遮断ステッカーが「効果なし」と発表されて12年です
政府の案内文には「安全です」と「減らしましょう」が同じページに並んで書かれています
ビジネスメタのMuse Spark Open、家にスーパーコンピューターが必要になるのでしょうか
816Bのオープンウェイトが、Mac Studio2台に搭載されました。トークン速度を左右するメモリ帯域幅、メタが一度閉じて再び開いた理由、1Tが標準になりつつあるオープンウェイトの地形、そしてそのメモリを売るサムスン電子の四半期決算まで、一気に見ていきます。
ビジネス
あなたの視点が次の号をつくります
この号で最も共感した点、あるいは違う経験をした点はどこですか。