평균 30점 과목에서 100점, 이제 모든 고득점이 의심받아요
한국 세무사 시험 수석이 AI 부정행위를 자백했어요
비즈니스1만 6,856명의 평균이 30점이던 과목에서 나온 100점
한국에는 세무사(Certified Tax Accountant, CTA)라는 국가 전문자격이 있어요. 세금 신고와 세무 조정, 세금 불복 절차를 대리하는 직업이에요. 시험은 두 단계예요. 올해 제63회 1차 시험에는 1만 6,856명이 응시해 18.09%가 붙었어요. 2차 시험은 정부가 최소 합격인원을 700명으로 정해 두고 치르고, 지난해 2차 합격률은 10.48%였어요. 몇 년씩 준비하는 사람이 흔한 시험이에요.
올해 1차 시험 과목인 세법학개론에서 응시자 1만 6,856명의 평균은 30.18점이었어요. 이 과목에서 100점을 받은 사람이 있었어요. 그는 1차 시험 160문항 가운데 159문항을 맞혔고, 논술형인 2차 시험에서도 800점 만점에 663점으로 수석을 했어요. 이 사람을 A씨라고 부를게요.
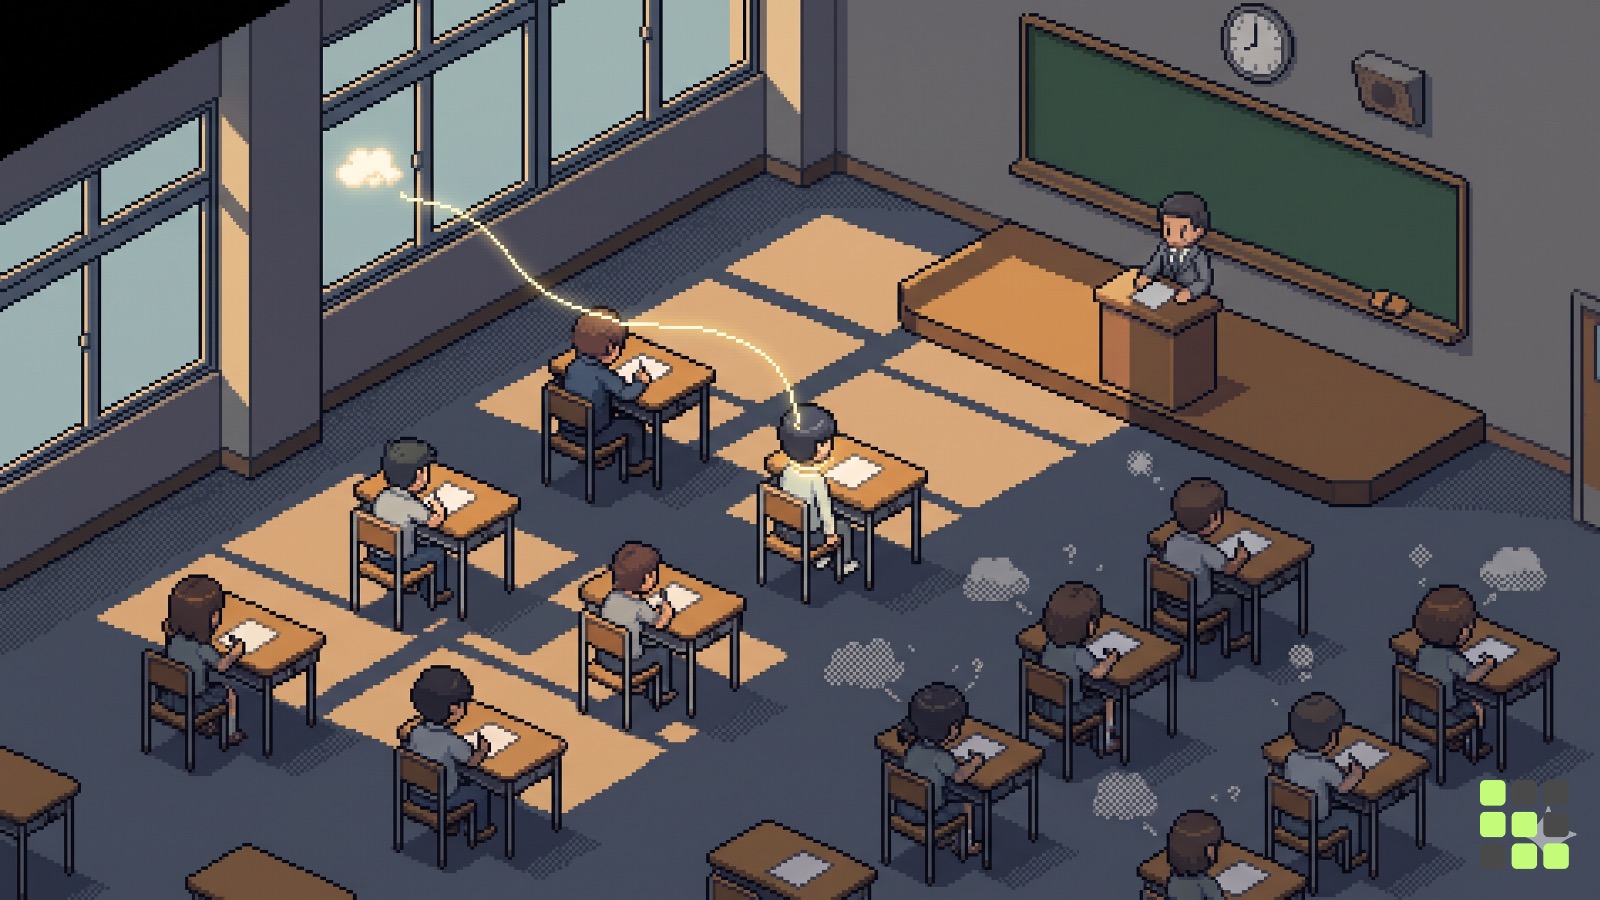
2026년 11월 15일, A씨는 부정행위를 자백하고 경찰에 자수했어요. 자백에 따르면 몸에 숨긴 초소형 카메라가 시험지를 찍었고, 시험장 밖에서 생성형 AI가 답을 만들었고, A씨는 스마트폰으로 그 답을 확인했어요.
한국 밖 독자에게는 낯선 시험이겠지만, 시험으로 자격을 주는 사회라면 어디든 같은 질문을 피하기 어려워요. AI가 푼 답과 사람이 푼 답을 시험은 어떻게 가려낼 수 있을까요.
감독관 바로 앞, 첫째 줄 가운데 자리
A씨의 2차 시험 자리는 감독관 바로 앞인 첫째 줄 가운데였어요. 그를 감독한 위원 4명 가운데 의심스러운 행동을 봤다는 사람은 없었어요. 시험을 주관하는 한국산업인력공단1은 전산으로 판독하는 1차 채점 자료에서도 특이사항을 찾지 못했어요. 의혹은 시험 절차 안이 아니라, 점수를 이상하게 여긴 온라인 커뮤니티에서 시작됐어요.
같은 수법이 늘 통한 것도 아니었어요. A씨는 제61회 공인회계사 1차 시험에서도 전자기기와 생성형 AI를 썼다고 밝혔는데, 그 시험에서는 떨어졌어요. 실패한 부정행위는 평범한 불합격으로 끝나고, 성공한 부정행위는 고득점으로만 남아요. 어느 쪽이든 답안지에는 흔적이 없어요.
자백 영상에서 A씨가 밝힌 동기는 30대에 시작한 수험 생활이 얼마나 더 길어질지 모른다는 두려움이었어요. 합격에 걸린 것이 큰 시험일수록 같은 유혹을 받는 응시자는 또 나올 거예요.
정부는 전파탐지기 도입, 시험장 CCTV 확대, 수능 시험장의 스마트안경 판별 인력 배치를 대책으로 내놨어요. 그런데 공단이 세무사 2차 시험 감독위원 교육자료에 넣은 주의사항은 스마트안경이었고, 온라인에서 처음 제기된 의혹도 AI 스마트안경이었어요. 실제로 쓰인 건 초소형 카메라와 스마트폰이었어요. 감독은 이미 알려진 기기를 겨냥하고, 부정행위는 다음 기기로 옮겨 가요. 전파탐지기가 들어오면 또 다른 방법이 나올 거예요.
다음 날부터 다른 고득점자들이 의심받기 시작했어요
자백이 알려진 뒤 국내 커뮤니티에는 올해 시험에서 나온 이례적인 결과를 일곱 줄로 묶은 게시물이 돌았어요. 로스쿨 입학시험인 리트(LEET)2, 의·치의학 전문대학원 입학시험인 미트(MEET), 세무사, 관세사, 감정평가사, 5급 공무원 시험이 한 목록에 들어 있었어요. 저는 이 가운데 리트 만점만 보도로 확인했고, 나머지 항목이 사실인지는 확인하지 못했어요.
목록에 오른 사람들이 AI로 부정행위를 했다는 근거는 없어요. 리트 만점자는 언론 인터뷰에서 자기 공부법을 자세히 설명했고, 부정행위와 관련해 보도된 내용도 없어요. 그런데도 같은 목록에 들어갔어요.
이런 의심은 이번 사건보다 먼저 있었어요. 올해 9월 리트 시행 19년 만에 처음으로 만점자가 나왔을 때, 수험생 커뮤니티의 첫 반응은 “조작 아니야?”였다고 해요. 세무사 사건은 그 막연한 의심에 실제 사례 하나를 붙여 준 셈이에요.
이 의심도 부정행위가 남긴 비용이에요. 시험이 AI가 만든 고득점과 사람이 만든 고득점을 구별하지 못하면, 정직하게 높은 점수를 받은 사람도 결백을 보여 줄 방법이 없어요. 점수가 높을수록 의심도 커져요. 시험 점수는 원래 ‘이 사람이 이만큼 안다’는 걸 사회에 보증하는 장치인데, 그 보증이 맨 위에서부터 흔들리는 거예요.
AI는 2023년부터 이 시험들의 합격선 근처에 있었어요
AI가 전문직 시험 문제를 푼다는 사실은 갑자기 나온 이야기가 아니에요. 2023년 2월 학술지 PLOS 디지털 헬스에 실린 연구는 챗GPT가 미국 의사면허시험(USMLE) 공개 문항에서 52.4~75.0%의 정답률을 냈다고 보고했어요. 이 시험의 합격선은 60% 안팎이에요. 같은 해 공개된 미국·독일 연구진의 논문에서는 GPT-4가 예시 문항과 계산기 같은 도구를 받은 조건에서 공인회계사(CPA)를 포함한 회계 자격시험 4종의 객관식 문항에서 평균 85.1%를 기록했어요. 변호사시험에서 GPT-4가 상위 10% 성적을 냈다는 OpenAI의 발표는 2024년에 과장이라는 재검토 논문이 나왔어요.
만점은 아니었고, 수치를 둘러싼 논쟁도 있었어요. 실제 시험장에서 치른 결과도 아니에요. 그래도 사람이 몇 년을 준비하는 시험의 합격선 근처에 3년 전 모델이 이미 와 있었다는 점은 달라지지 않아요.
객관식도 논술도 같은 이유로 뚫려요
객관식 시험이 많은 데는 이유가 있어요. 채점이 빠르고, 기계로 판독할 수 있고, 정답이 하나라 다툼이 적어요. 그런데 이 장점은 부정행위를 하는 사람에게도 그대로 유리해요. 시험장 밖의 AI가 안에 있는 응시자에게 넘겨야 할 정보가 문항당 숫자 하나예요. 옮겨 적는 데 시간이 거의 들지 않고, 답안지에는 풀이 과정이 남지 않아요. 답안지만 봐서는 사람이 맞힌 159문항과 AI가 맞힌 159문항을 구별할 수 없어요.
그러면 논술형으로 바꾸면 될까요. 이번 사건은 그 처방에도 답을 줬어요. A씨가 수석을 한 2차 시험이 논술형이었어요. 자수 하루 전인 11월 14일 보도된 인터뷰에서 A씨는 이 2차 성적을 들어 의혹을 반박했어요. 논술형 고득점을 결백의 근거로 내세운 거예요. 하루 뒤 그는 2차 시험에서도 부정행위를 했다고 인정했어요.
이유는 단순해요. 생성형 AI는 번호를 고르는 일보다 긴 글을 쓰는 일에 더 능숙한 도구예요. 문제를 찍어 보낼 수 있고 답을 받아 볼 수 있다면, 논술형 답안은 옮겨 적는 시간이 조금 더 걸릴 뿐이에요. 종이 답안지에는 무엇을 썼는지만 남고, 그 내용을 누가 생각했는지는 남지 않아요. 공단은 A씨의 2차 답안지를 채점 전문가에게 다시 검토받고 있었지만, 결론보다 본인의 자백이 먼저 나왔어요.
오스왈드의 시선
저는 대학에서 학생들을 가르치면서, 채점하는 사람이 번거롭더라도 논술시험과 면접 형태의 구술시험을 도입해야 한다고 꾸준히 말해 왔어요. 제 강의에서도 실제로 그렇게 평가해 왔고요. 학생들에게 시험을 치르게 한 뒤, 실제로 이해했는지를 다시 묻는 것을 시험으로 자주 써요. 논술이나 구술에서는 머릿속에 떠오르는 것을 바로 적고 말하는 학생과 그렇지 못한 학생이 갈려요.
2024년 1월에 쓴 글에서도 AI 글쓰기 도구가 퍼지면서 글의 완성도만으로는 학생이 내용을 이해했는지 알기 어려워졌고, 자기가 쓴 글을 말로 설명하게 하는 구두 방어3가 필요하다고 적었어요. 책 《생각을 맡기는 사람들: 호모 브레인리스》에서도 AI가 의학·법학·회계 시험을 통과한다는 사실을 다뤘어요.
이번 사건은 그 판단을 조금 좁혀 줬어요. 종이에 쓰는 논술만으로는 부족해요. 논술이 평가 수단으로 제 몫을 하려면 답안을 쓴 사람에게 그 답안에 대해 다시 물을 수 있어야 해요.
되묻는 시험이 지필시험과 다른 점은 질문이 미리 정해져 있지 않다는 거예요. 채점자는 답을 듣고 그 자리에서 왜 그렇게 판단했는지, 조건이 바뀌면 결론이 어떻게 달라지는지를 물어요. 다음 질문이 앞의 답에 따라 달라지니 응시자는 무엇을 물을지 미리 알 수 없어요. 누군가 대신 만들어 준 답은 첫 질문까지는 버텨도 이어지는 질문에서 막히기 쉬워요.
국가시험은 대학 강의와 규모가 달라요. 한 과목에 1만 6,856명이 응시하는 시험에서 모든 응시자를 구술로 평가할 수는 없어요. 그래도 최종 단계에 구술을 두는 방식은 이미 있어요. 한국의 기술사4 시험은 논술형 필기시험 합격자에게 30분가량의 구술형 면접을 치르게 해요. 전문자격시험도 2차 논술형 시험 합격권에 든 응시자에게 자기 답안을 설명하게 하는 절차를 검토할 만해요. 구술이 모든 부정행위를 막아 주지는 못해요. 다만 답안지에 적힌 내용이 응시자의 머리에서 나왔는지를 시험 절차 안에서 한 번 더 확인할 수 있어요.
이 절차는 의심받는 고득점자에게도 필요해요. 지금은 만점을 받은 사람이 커뮤니티의 의심 앞에서 할 수 있는 일이 인터뷰에서 공부법을 설명하는 것 정도예요. 시험 안에 되묻는 단계가 있으면, 높은 점수를 받은 사람이 그 점수가 자기 것이라는 걸 공식 절차 안에서 보여 줄 수 있어요.
시험만 바꿔서 끝날 일도 아니에요. 주판이 나왔을 때는 주판 쓰는 법을, 계산기가 나왔을 때는 계산기 쓰는 법을 배웠어요. 컴퓨터와 엑셀도 그랬어요. 이제 입시 학원이 AI를 잘 쓰는 법을 고민하고 있어요. 저에게는 그 점이 인상적이었어요.
AI가 전문직 시험을 통과했다는 사실은 거꾸로 읽을 수도 있어요. 전문가가 아닌 사람도 AI와 함께라면, 적어도 시험이 묻는 수준의 전문 지식이 필요한 일을 처리할 수 있게 됐다는 뜻이에요. 그렇다면 전문직의 영역이 어디인지 다시 봐야 해요. 시험으로 확인하던 지식과, 일을 하면서 쌓이는 경험과 노하우는 달라요. 뒤쪽을 흔히 암묵지라고 불러요. 저는 법령을 누가 더 많이 외웠는지는 앞으로 큰 의미가 없어질 거라고 봐요.
AI를 잘 쓰는 법을 가르치는 일과, 학생이 스스로 이해했는지 되묻는 일은 서로 어긋나지 않아요. AI가 내놓은 답이 맞는지 판단하려면 그 내용을 이해하고 있어야 하고, 되묻는 시험이 확인하려는 게 바로 그 이해예요.
마치며
감독 기기는 부정행위 기기가 바뀔 때마다 다시 바꿔야 해요. 되묻는 절차는 기기가 무엇이든 같은 것을 확인해요. 그리고 그 확인은 부정행위를 가려내는 데만 쓰이지 않고, 정직하게 높은 점수를 받은 사람을 의심에서 꺼내 주는 데도 쓰일 수 있어요.
💬 구독자님은 시험을 치른 뒤 누군가 “왜 그렇게 답했어요?” 하고 되물은 적이 있나요? 있었다면 어떤 질문이 가장 어려웠는지 댓글로 짧게 들려주세요.
📨 자격시험을 준비하는 사람이나 시험과 평가를 설계하는 동료가 있다면 이 글을 전해 주세요.
오늘 얻은 관점, 다음 이슈에서도 이어가세요.
쏟아지는 소식 사이에서 오래 남는 한 편을 골라 격일로 보내드립니다.
이메일 확인 후 구독이 완료돼요.
이미 구독 중이신가요? 로그인하고 댓글 남기기
커피 한 잔 보내기
이 관점이 좋았다면, 다음 글에 커피 한 잔
오스왈드에게 커피와 함께 짧은 쪽지를 보내주세요. 응원은 다음 취재와 집필에 보탭니다.


참고자료 & 더 읽기
사건 보도
- 파이낸셜뉴스, 세무사 수석 합격자 자수 보도, 2026년 11월 15일. 링크 ··· 자백 내용(초소형 카메라, 생성형 AI, 스마트폰), 공인회계사 1차 불합격, 좌석과 감독위원 답변, 정부 대책이 정리돼 있어요.
- 경향신문, 세무사 1차·2차 성적 관련 보도, 2026년 11월 12·13일. 링크 1 · 링크 2 ··· 159문항, 세법학개론 평균 30.18점, 2차 663점의 출처예요.
- 헤럴드경제, 감독위원 교육자료와 2차 답안 재검토 보도. 링크 ··· 스마트안경 주의사항이 들어간 경위를 볼 수 있어요.
- 아주경제, 온라인 커뮤니티 의혹 제기 보도, 2026년 11월 15일. 링크
- 세무사신문, 「세무사 1차시험 합격률 18.09%」. 링크 ··· 올해 1차 응시자와 합격률이에요.
- 세무사신문, 「제62회 세무사시험 728명 최종 합격…합격률 10.48%」. 링크
- 중앙일보(미주중앙일보 게재), 리트 첫 만점자 인터뷰, 2026년 9월. 링크 ··· 시행 19년 만의 첫 만점과 커뮤니티의 첫 반응이 나와요.
AI와 전문직 시험 연구
- Kung et al., PLOS Digital Health, 2023. PLOS 보도자료 ··· 챗GPT의 USMLE 공개 문항 성적이에요.
- Eulerich et al., Review of Accounting Studies, 2024. 링크 ··· 회계 자격시험 4종 객관식 문항 결과예요. 실제 시험 응시가 아니라 문항 표본 실험이에요.
- Martínez, Artificial Intelligence and Law, 2024. 링크 ··· GPT-4 변호사시험 상위 10% 주장을 다시 계산한 논문이에요.
저자의 이전 글
- 안광섭, 구두 방어로 글쓰기 평가를 보완하자는 글, 2024년 1월 31일. 링크
📝 용어 설명
각주
-
한국산업인력공단(HRD Korea): 정부를 대신해 세무사, 기술사 같은 국가자격시험의 출제·시행·채점을 맡는 공공기관이에요. ↩
-
리트(LEET): 한국 로스쿨 입학에 쓰는 법학적성시험이에요. 미국의 LSAT와 비슷한 역할을 하고, 공부해도 점수가 잘 오르지 않는 시험으로 알려져 있어요. ↩
-
구두 방어(oral defense): 자기가 쓴 글이나 답안을 평가자 앞에서 말로 설명하고 질문에 답하는 방식이에요. 학위논문 심사에서 많이 써요. ↩
-
기술사(Professional Engineer): 한국 국가기술자격 가운데 최상위 등급이에요. 논술형 필기시험에 붙은 사람이 구술형 면접을 한 번 더 치러요. ↩
여러분의 생각이 다음 호를 만듭니다
이번 호에서 가장 공감했거나, 다른 경험을 한 지점은 무엇인가요?